Der Text-Inspektor
Der Tab Text im Inspektor beschreibt das aktive Dokument als Ganzes. Er hat drei Facetten. Überblick zeigt Statistiken zum Dokument, darunter Satz- und Wortzahlen, Lesbarkeitswerte, Angaben zu Wortschatz und Satzbau sowie Diagramme zur Häufigkeit der Wortarten, der grammatischen Funktionen und der Phrasen. Details enthält die Attributwerte und Tags des Dokuments, und Lesezeichen zeigt die Textstellen, die Sie im Dokument mit einem Lesezeichen versehen haben.
Statistiken beschreiben nur die Oberfläche eines Textes. Mit ihnen können Sie ein Dokument charakterisieren, Dokumente für eine genauere Lektüre auswählen und Auffälligkeiten in einem Datenbestand entdecken (etwa Transkripte, in denen die Sätze nie getrennt wurden). Was jemand mit einem Text beabsichtigt hat, können Statistiken dagegen nicht zeigen, und ebenso wenig, warum sich zwei Meinungsbeiträge unterscheiden.
Grundbegriffe
Beim Indizieren zerlegt LemmaLoom Dokumente in ihre Sätze und Tokens; Tokens sind einzelne Wörter und Satzzeichen (siehe Kapitel 21, Analyse und Indizierung). Aus dieser Zerlegung werden die Statistiken abgeleitet.
- Wort bezeichnet jedes Token, das weder Satzzeichen noch Symbol ist. Auch Zahlen gelten als Wörter.
- Verschiedene Wörter erkennt LemmaLoom an der Grundform jedes Wortes, dem Lemma; Modell und Modelle zählen als dasselbe Wort, ebenso war und waren. In der Linguistik heißen diese Einheiten Types, daher der Name Type-Token-Verhältnis.
- Die Silbenzahl ist eine grobe Schätzung, die allein auf der Schreibung jedes Wortes beruht.
- Als lange Wörter gelten in LemmaLoom Wörter mit mehr als sechs Buchstaben.
- Stoppwörter sind Wörter aus einer festen Liste für jede Sprache; es handelt sich um sehr häufige Wörter wie der, von und ist. Wörter, die nicht auf dieser Liste stehen, heißen Inhaltswörter.
- Anteile sind Verhältnisse, die als Prozentwerte angegeben werden. Bei 17 Stoppwörtern unter insgesamt 30 Wörtern ergibt sich ein Anteil von , angezeigt als 57 %.
Den Tab Text öffnen
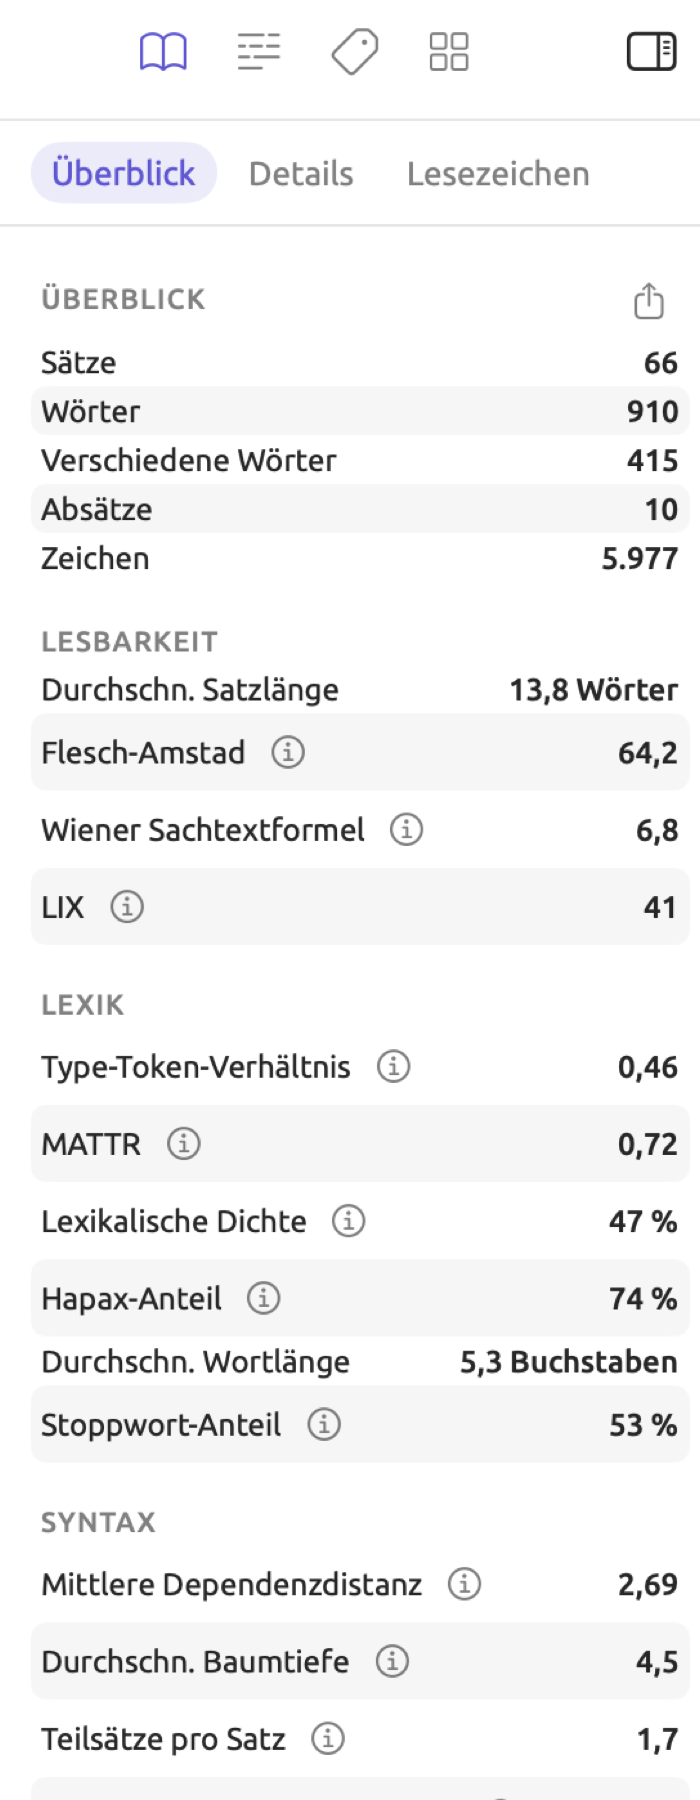
Die Beispiele in diesem Kapitel stammen aus „Klimadebatte“, dem mitgelieferten Beispielprojekt dieses Handbuchs; Sie fügen es mit Ablage ▸ Importieren ▸ Beispielprojekt Ihrer Bibliothek hinzu (siehe Das Beispielprojekt in Kapitel 1, Einführung). Die Abbildung unten zeigt den Tab Text für „Uns läuft die Zeit davon“, einen aktivistischen Meinungsbeitrag mit 910 Wörtern in 66 Sätzen.
Die Facette Überblick besteht aus einer einzigen Spalte. Von oben nach unten enthält sie fünf Abschnitte mit Kennzahlen (Überblick, Lesbarkeit, Lexik, Syntax und Struktur), gefolgt von drei Balkendiagrammen (Wortarten, Funktionen und Phrasen). Der erste Abschnitt, Überblick, enthält einfache Zählungen zum Text; er trägt denselben Titel wie die Facette.
So öffnen Sie den Tab Text:
- Öffnen Sie ein Dokument in der Leseansicht.
- Ist der Inspektor ausgeblendet, wählen Sie Darstellung ▸ Inspektor ein-/ausblenden (⌃⌘I).
- Klicken Sie oben im Inspektor auf das Buchsymbol oder wählen Sie Darstellung ▸ Inspektor ▸ Text (⌥⌘1).
- Klicken Sie in der Reihe der Facetten unter den Symbolen auf Überblick, Details oder Lesezeichen.
Ein Dokument zeigt zunächst den Tab Text mit der Facette Überblick, bis Sie selbst etwas anderes wählen. Wenn Sie zwischen Dokument-Tabs wechseln, merkt sich jedes Dokument seinen eigenen Tab und seine eigene Facette. Liegen in der geteilten Ansicht zwei Dokumente nebeneinander, zeigt der Inspektor das Dokument im aktiven Bereich. Klicken Sie in den anderen Bereich, um die Statistiken des anderen Dokuments zu sehen; der zuvor gewählte Tab und die Facette bleiben dabei erhalten. In Detailansichten und bei der Anzeige eines Sets bleibt der Inspektor geschlossen, und jedes separate Dokumentfenster hat einen eigenen Inspektor.
Statistiken setzen ein indiziertes Dokument voraus. Ist der erste Textabschnitt noch nicht fertig indiziert, sehen Sie den Hinweis Statistiken werden verfügbar, sobald die Indizierung abgeschlossen ist. Die Facette Details funktioniert unabhängig davon, ob schon Statistiken vorliegen. Solange die Indizierung läuft, beziehen sich die Statistiken nur auf den bereits verarbeiteten Teil. Dokumentstatistiken gibt es nur für englische, deutsche und chinesische Dokumente; bei anderen Sprachen bleibt der Hinweis stehen.
Die Facette Details
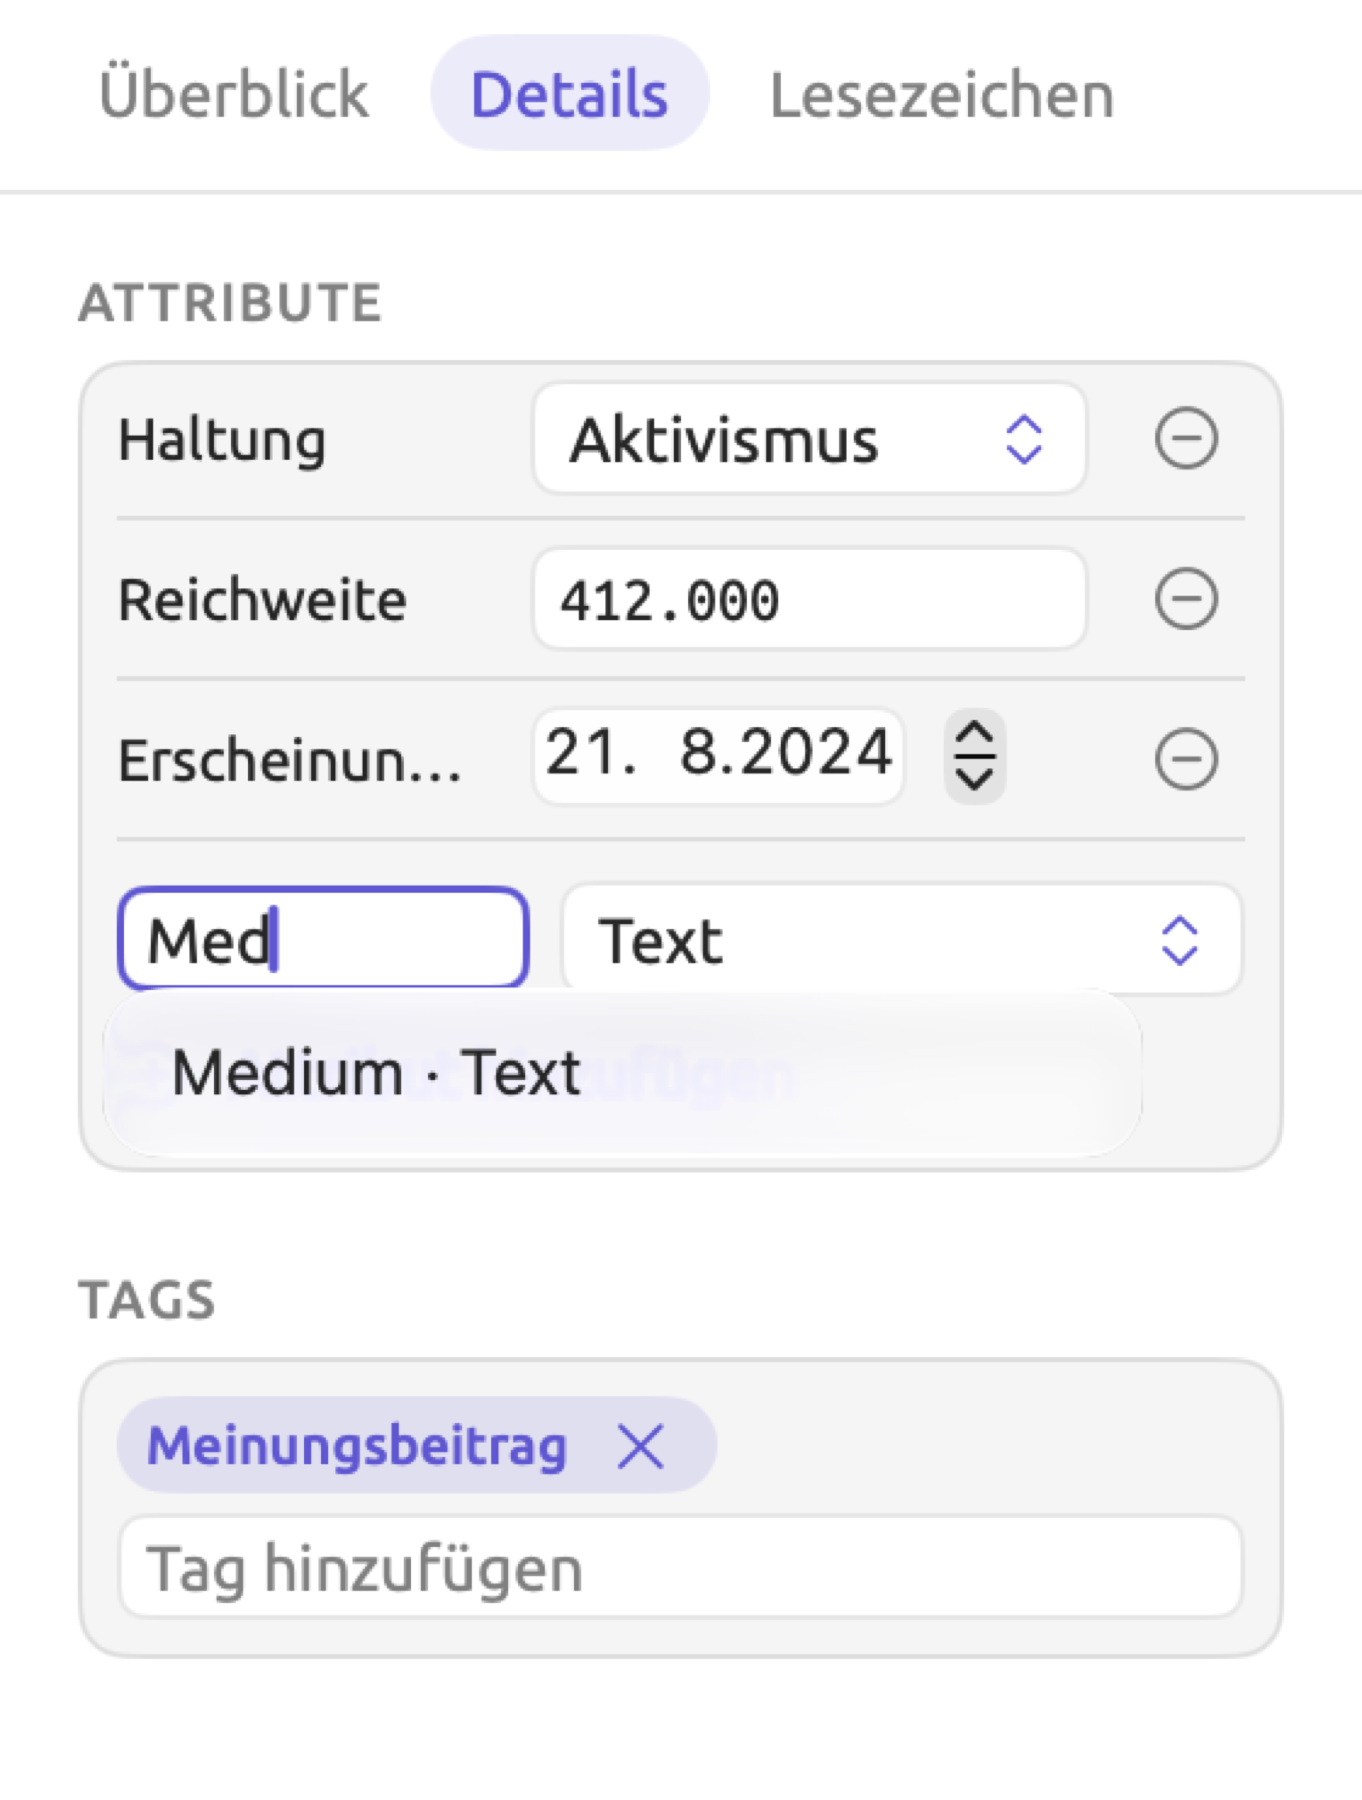
Jedes Dokument im Beispielprojekt „Klimadebatte“ hat Werte für vier Attribute. Die Werte von „Haltung“ geben an, ob ein Text von Aktivisten, von Skeptikern oder aus einer neutralen Quelle stammt. „Reichweite“, „Erscheinungsdatum“ und „Medium“ geben an, wie groß das Publikum ist, wann der Artikel erschienen ist und wo. In der Facette Details des Dokuments „Uns läuft die Zeit davon“ zeigt Attribute für „Haltung“ den Wert „Aktivismus“, für „Reichweite“ 412.000 Leserinnen und Leser, für „Erscheinungsdatum“ den 21. August 2024 und für „Medium“ den Wert „Der Nordherold“. Unter dem Abschnitt Attribute steht bei Tags das einzige Tag dieses Dokuments, „Meinungsbeitrag“.
Attribute listet jedes Attribut-Wert-Paar des aktiven Dokuments auf und bietet Felder, in denen Sie die Werte bearbeiten. Hier vergeben und ändern Sie die Attributwerte eines einzelnen Dokuments, während Sie es durchsehen. Wie Sie mehreren Dokumenten gleichzeitig Attributwerte zuweisen, lesen Sie unter Einen Wert für viele Dokumente festlegen in Kapitel 8, Sets, Gruppen, Tags und Attribute.
So geben Sie dem Dokument einen Wert für ein Attribut, das in seiner Liste noch nicht aufgeführt ist:
- Geben Sie den Namen des Attributs in das Feld unter der Liste ein. LemmaLoom schlägt Namen vor, die in Ihren Projekten bereits verwendet werden, jeweils mit ihrem Typ, etwa „Medium“ · Text.
- Gibt es im Projekt noch kein Attribut dieses Namens, wählen Sie einen Typ. Bei Auswahl geben Sie außerdem die Wahlmöglichkeiten ein, eine pro Zeile.
- Klicken Sie auf Attribut hinzufügen oder drücken Sie den Zeilenschalter.
- Geben Sie den Wert in der neuen Zeile ein.
Jedes Attribut erscheint in einem Dokument nur einmal. Versuchen Sie, ein Attribut hinzuzufügen, das das Dokument bereits aufführt, bleibt Attribut hinzufügen deaktiviert, und sein Tooltip lautet Bereits hinzugefügt.
Um einen Wert zu entfernen, klicken Sie auf die Schaltfläche zum Entfernen am Ende seiner Zeile (Attribut entfernen). Tags geben Sie in das Feld Tag hinzufügen ein. Geben Sie das gewünschte Tag ein und drücken Sie den Zeilenschalter, oder tippen Sie nach einem Tag ein Komma, um mit dem nächsten fortzufahren. Während Sie tippen, erscheinen Vorschläge aus den vorhandenen Tags; um ein Tag zu löschen, klicken Sie auf sein ×.
Alle Änderungen wirken sofort und gelten auch für die Übersetzungen des Dokuments. Änderungen an Werten und Tags machen Sie mit Bearbeiten ▸ Wert festlegen widerrufen und Bearbeiten ▸ Tags bearbeiten widerrufen (⌘Z) rückgängig; das Hinzufügen eines ganz neuen Attributs widerrufen Sie mit Bearbeiten ▸ Attribut hinzufügen widerrufen. Mehr dazu finden Sie unter Werte eingeben und Ein Dokument mit Tags versehen in Kapitel 8, Sets, Gruppen, Tags und Attribute.
Die Statistiken im Überblick
Welche Kennzahlen erscheinen, hängt von der Sprache des Dokuments ab. Die meisten gibt es für englische, deutsche und chinesische Dokumente gleichermaßen. Die Lesbarkeitsformeln unterscheiden sich jedoch, weil die meisten von ihnen für eine einzige Sprache entwickelt wurden.
| Abschnitt | Kennzahl | Englisch | Deutsch | Chinesisch |
|---|---|---|---|---|
| Überblick | Sätze, Wörter, Verschiedene Wörter, Absätze, Zeichen | ja | ja | ja |
| Lesbarkeit | Durchschn. Satzlänge | ja | ja | ja |
| Flesch Reading Ease, Flesch-Kincaid-Stufe, Gunning Fog, SMOG, Coleman-Liau, ARI | ja | |||
| Flesch-Amstad, Wiener Sachtextformel | ja | |||
| LIX | ja | ja | ||
| Zeichen pro Satz, Durchschn. Wortlänge (in Zeichen), Partikeldichte | ja | |||
| Lexik | Type-Token-Verhältnis, MATTR, Lexikalische Dichte, Hapax-Anteil, Stoppwort-Anteil | ja | ja | ja |
| Durchschn. Wortlänge (in Buchstaben) | ja | ja | ||
| Syntax | Mittlere Dependenzdistanz, Durchschn. Baumtiefe, Teilsätze pro Satz, Anteil eingebetteter Teilsätze, Passivsätze | ja | ja | ja |
| Struktur | Dialoganteil, Fragen und Ausrufe, Sätze pro Absatz | ja | ja | ja |
Im Abschnitt Syntax erscheinen nur die Kennzahlen, die die Grammatikanalyse liefert. Ist die grammatische Struktur der Sätze eines Dokuments unbekannt, entfällt der Abschnitt.
Alle Werte werden für die Anzeige gerundet. Zählungen und LIX sind ganze Zahlen. Type-Token-Verhältnis, MATTR und Mittlere Dependenzdistanz haben zwei Nachkommastellen. Hapax-Anteil und die Anteile erscheinen als ganze Prozentwerte. Alle übrigen Werte haben eine Nachkommastelle.
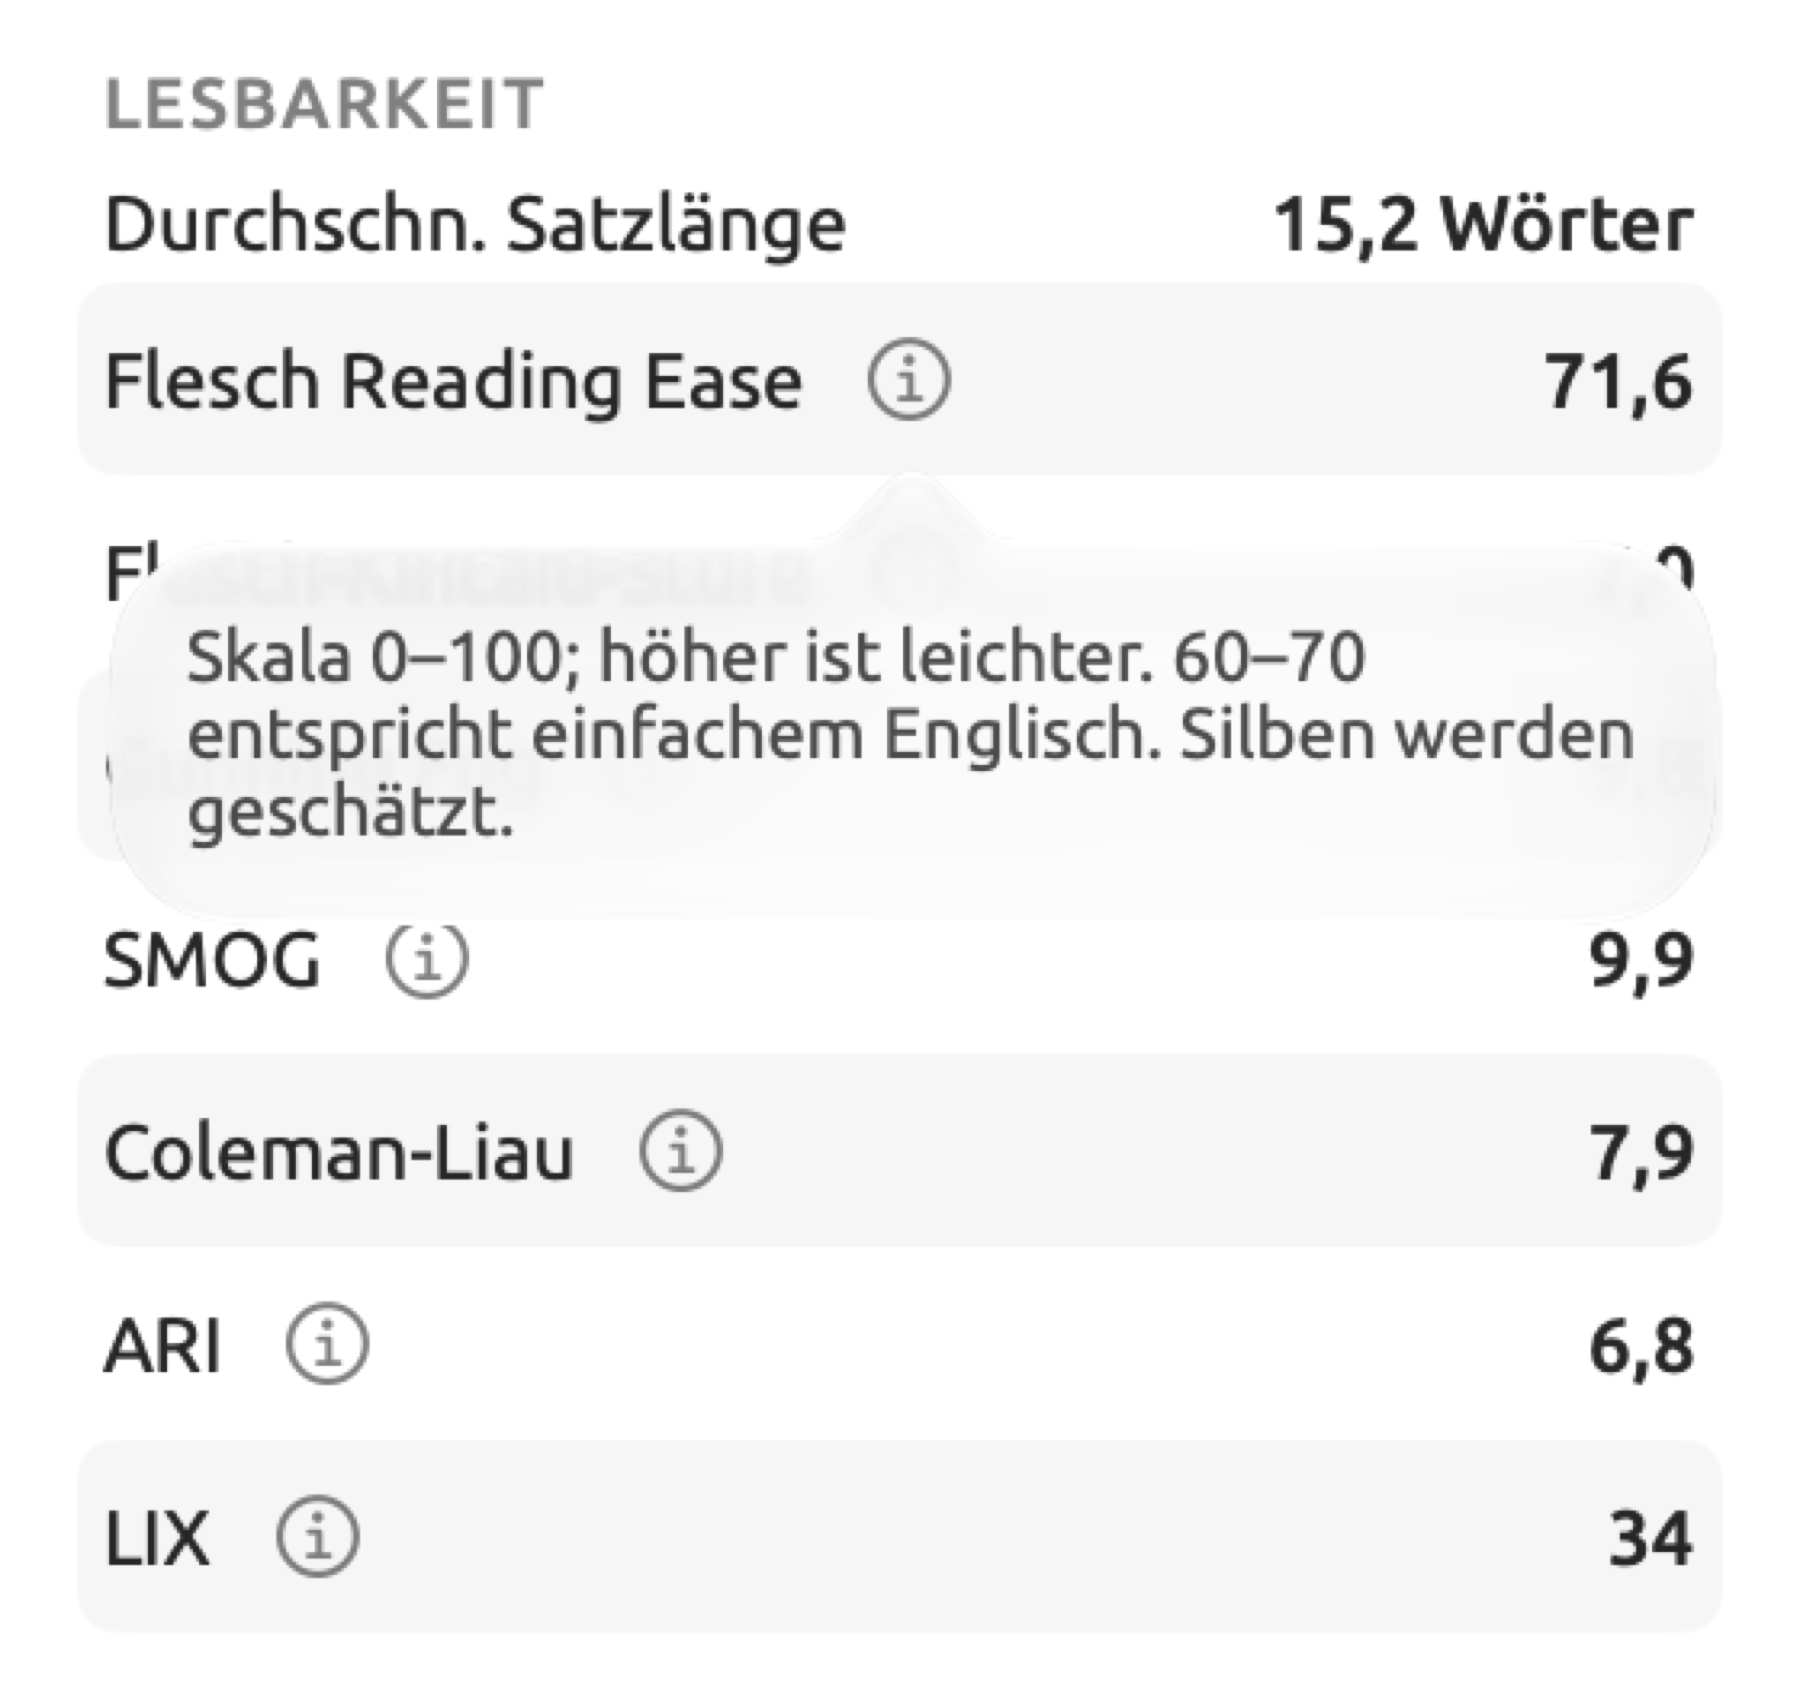
Neben dem Namen vieler Kennzahlen steht eine Schaltfläche ⓘ. Ein Klick darauf zeigt eine kurze Erklärung dazu, was die Kennzahl darstellt und auf welcher Skala sie liegt; ein Klick an eine andere Stelle schließt sie wieder.
Die Statistiken exportieren
So exportieren Sie alle Statistiken eines Dokuments in eine einzige Datei:
- Suchen Sie in der Facette Überblick die Überschrift des Abschnitts Überblick ganz oben in der Facette.
- Klicken Sie auf die Exportschaltfläche rechts neben der Überschrift (Als CSV exportieren).
- Wählen Sie einen Namen und einen Ordner und klicken Sie auf Sichern. Vorgeschlagen wird der Titel des Dokuments, gefolgt von
-statistics, etwaUns läuft die Zeit davon-statistics.csv.
Die Datei hat drei Spalten, Abschnitt, Maß und Wert, und eine Zeile für jede angezeigte Kennzahl sowie eine Zeile für jeden Balken der drei Diagramme. Die Werte erscheinen so wie im Inspektor (einschließlich Rundung und Einheit), etwa 57 % oder 10,0 Wörter.
Rechts neben der Überschrift jedes Diagramms steht ebenfalls eine Exportschaltfläche. Sie öffnet ein Menü mit den Formaten PNG und PDF (jeweils mit dem Titel des Diagramms) sowie CSV, das nur die Zahlen der Kategorien enthält (in den Spalten Kategorie und Anzahl).
Als Name wird der Titel des Dokuments zusammen mit dem Titel des Diagramms vorgeschlagen, etwa Uns läuft die Zeit davon-Wortarten.png.
Der Inspektor zeigt immer nur ein Dokument. Um die Werte mehrerer Dokumente für einen Vergleich in einer Tabellenkalkulation zu sammeln, exportieren Sie zuerst jedes Dokument in eine eigene Datei und führen die Dateien dann zusammen; entfernen Sie vor dem Rechnen die Einheiten und Prozentzeichen.
Dokumente nach einer Kennzahl finden
Jede Kennzahl aus der Tabelle oben kann in einer Abfrage als Regel dienen. Mit einer solchen Abfrage wählen Sie gezielt die Dokumente aus, auf die die Regel zutrifft, etwa solche, die schwerer zu verstehen sind als einfaches Englisch, oder solche mit einem außergewöhnlich hohen Anteil an Passivsätzen.
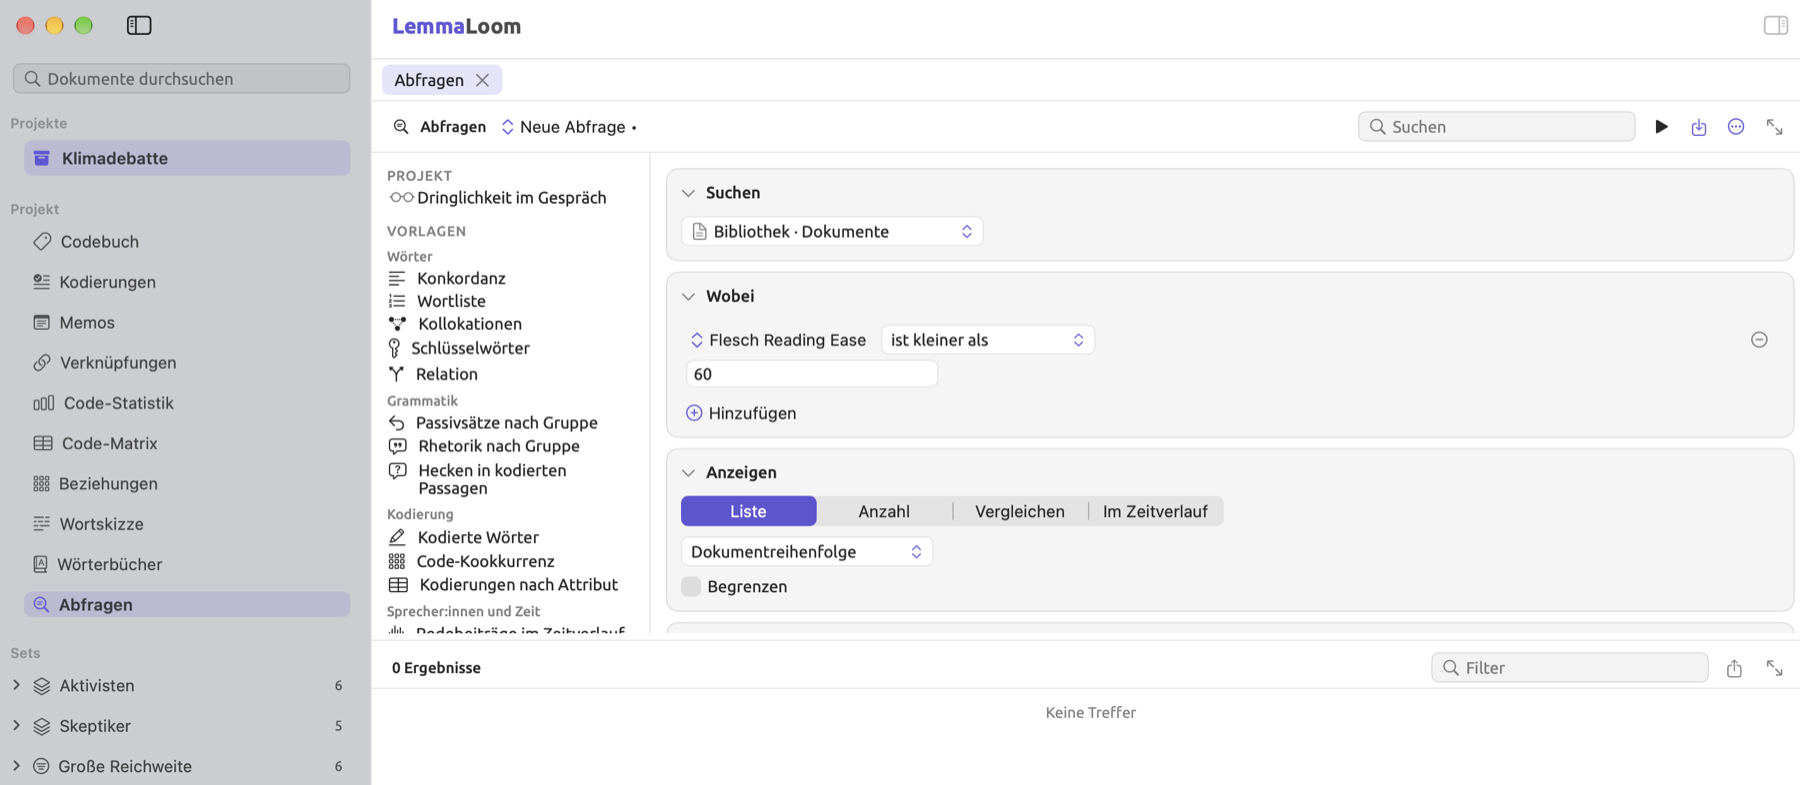
Die Abbildung unten zeigt eine solche Abfrage im Projekt „Klimadebatte“. Sie sucht Dokumente, deren Flesch Reading Ease unter 60 liegt (der unteren Grenze von Fleschs Bereich für einfaches Englisch), und meldet Keine Treffer. Flesch Reading Ease wird nur für englische Dokumente berechnet, und die Originaldokumente dieses Projekts sind deutschsprachig; die englische Übersetzung „Uns läuft die Zeit davon (Englisch)“ liegt mit 71,6 über der Grenze.
So fragen Sie Dokumente nach einer Kennzahl ab:
- Klicken Sie in der Seitenleiste unter Projekt auf Abfragen.
- Wählen Sie unter Suchen den Eintrag Bibliothek · Dokumente.
- Klicken Sie unter Wobei auf Hinzufügen und wählen Sie Regel hinzufügen.
- Klicken Sie auf das Feld, wählen Sie Kennzahl und dann die gewünschte Kennzahl, etwa Flesch Reading Ease.
- Wählen Sie einen Vergleich, etwa ist kleiner als, und geben Sie die Zahl unter Wert ein.
Für Kennzahlfelder in Abfragen gelten folgende Regeln:
- Das Feld Kennzahl steht nur in Abfragen über Dokumentsets, Projekte und Alle Projekte zur Verfügung. Abfragen bieten alle Kennzahlfelder an, intelligente Sets dagegen nur Token, Sätze und Zeichen, die LemmaLoom festhält, sobald ein Dokument indiziert ist. Token zählt auch Satzzeichen mit und liegt deshalb über Wörter. Wo welches Kennzahlfeld angeboten wird, finden Sie unter Felder in Kapitel 15, Eine Abfrage erstellen.
- Eine Abfrage vergleicht mit dem ungerundeten Wert. Ein angezeigter Wert von 86,7 kann zum Beispiel tatsächlich 86,705 sein; verwenden Sie daher Vergleiche wie ist kleiner als, ist mindestens oder liegt zwischen statt ist.
- Kennzahlen, die als Prozentwerte angezeigt werden, Hapax-Anteil eingeschlossen, erscheinen in Abfragen als Werte zwischen 0 und 1. Um Dokumente zu finden, deren Lexikalische Dichte mindestens 45 Prozent beträgt, geben Sie
0.45ein. - Eine Regel überspringt Dokumente, die für ihre Kennzahl keinen Wert haben. Kennzahlen wie Flesch Reading Ease werden nur für englische Dokumente berechnet; eine Regel wie ist kleiner als
60überspringt daher alle nicht englischen Dokumente. Dokumente, die gerade indiziert werden, bleiben unberücksichtigt, bis ihre Statistiken vorliegen.
Wann die Statistiken berechnet werden
LemmaLoom berechnet die Statistiken eines Dokuments und speichert sie zusammen mit dem Dokument. Der Tab Text und das Feld Kennzahl in Abfragen verwenden diese gespeicherten Werte, deshalb zeigen beide stets übereinstimmende Statistiken. Die Statistiken beziehen sich auf das ganze Dokument, auch wenn die Leseansicht nur annotierte Sätze zeigt (siehe Nur annotierte Sätze anzeigen in Kapitel 6, Lenses).
LemmaLoom berechnet die Statistiken nur neu, wenn sich der Text des Dokuments oder die Einstellungen seiner Indizierung ändern. Dazu gehört, dass Sie den Text bearbeiten und sichern, die Spracheinstellung des Dokuments ändern oder die Muster anpassen, die Text von der Indizierung ausschließen. Sind die Statistiken noch nicht berechnet, wenn Sie den Tab Text öffnen, erscheint kurz eine Fortschrittsanzeige, bis LemmaLoom fertig ist.
Eine Übersetzung wie „Uns läuft die Zeit davon (Englisch)“ hat eigene Statistiken; sie werden mit den Kennzahlen ihrer eigenen Sprache berechnet.
Zählungen
Der Abschnitt Überblick führt fünf auf:
| Kennzahl | Was gezählt wird |
|---|---|
| Sätze | Sätze, so wie die Indizierung den Text unterteilt |
| Wörter | Wörter, ohne Satzzeichen und Symbole |
| Verschiedene Wörter | Unterschiedliche Lemmata unter den Wörtern |
| Absätze | Absätze, getrennt an Leerzeilen oder Zeilenumbrüchen |
| Zeichen | Jedes Zeichen des Textes, einschließlich Leerzeichen, Zeilenumbrüchen und Satzzeichen |
Wörter und verschiedene Wörter
Wörter sind die Tokens der Indizierung ohne Satzzeichen und Sonderzeichen, je nachdem, was die Indizierung in der jeweiligen Sprache als Token behandelt. Im Englischen trennt die Indizierung zum Beispiel zusammengezogene Formen (don’t = do + n’t), und Wörter mit Bindestrich werden am Bindestrich getrennt, der als Satzzeichen gilt (eighty-four = eighty + four). Da die chinesische Schrift keine Abstände zwischen Wörtern kennt, entscheidet die Indizierung, wo ein Wort endet und das nächste beginnt, und danach wird gezählt.
Verschiedene Wörter ignoriert die Groß- und Kleinschreibung; Die am Satzanfang und die mitten im Satz werden also nur einmal gezählt.
Text, der von der Indizierung ausgeschlossen ist, etwa Zeitstempel in einem Transkript, zählt nur unter Zeichen und, wenn er einen eigenen Absatz bildet, unter Absätze (siehe Von der Analyse ausgeschlossener Text in Kapitel 21, Analyse und Indizierung).
Sätze und Absätze
In geschriebenen Texten markieren meist Punkte, Fragezeichen und Ausrufezeichen die Satzgrenzen. In Transkripten liegen Satzgrenzen überall dort, wo bei der Transkription ein solches Satzzeichen gesetzt wurde.
Absatzgrenzen ergeben sich aus den Zeilenumbrüchen im Text. Enthält der Text irgendwo eine Leerzeile, trennen Leerzeilen die Absätze, und benachbarte Zeilen, zwischen denen nur ein Zeilenumbruch steht, bilden einen Absatz. Andernfalls beginnt mit jedem Zeilenumbruch ein neuer Absatz. Als Leerzeile gilt eine Zeile, die nur Leerraum enthält. In Transkripten, die LemmaLoom erstellt, beginnt bei jedem Sprecherwechsel und nach jeder Pause von mehr als anderthalb Sekunden automatisch ein neuer Absatz.
Buchstaben, Zeichen und Silben
Die Buchstabenzählung erfasst jeden Buchstaben im Text, chinesische Schriftzeichen eingeschlossen. Ziffern, Satzzeichen und Apostrophe zählen nicht als Buchstaben. Unter allen Lesbarkeitsformeln berücksichtigt nur ARI Buchstaben und Ziffern zusammen.
Die Silbenzahl wird geschätzt, indem LemmaLoom die Gruppen aufeinanderfolgender Vokale in einem Wort zählt. Als Vokale gelten die fünf Buchstaben a, e, i, o und u, im Englischen und Deutschen außerdem y und im Deutschen die Umlaute ä, ö und ü. Beispiele sind heat (ea), again (a und ai) und families (a, i und ie). Bei englischen Wörtern gilt ein e am Wortende nach anderen Vokalgruppen als stumm, außer bei Wörtern auf le. Daher werden wave und were mit einer Silbe geschätzt, people dagegen mit zwei. Jedes Wort hat mindestens eine Silbe; selbst 2050, das keine Vokale enthält, zählt also als eine Silbe.
Fehler entstehen zum Beispiel bei warned, das wegen seiner Endung -ed auf zwei Silben geschätzt wird, oder bei science, das als eine Silbe statt zwei gilt. Auch Wörter mit aufeinanderfolgenden Vokalen a, y und o wie mayor werden falsch geschätzt, nämlich mit einer Silbe. Im Deutschen wird Familien wegen der Gruppe ie fälschlich mit drei Silben gezählt. Über ganze Dokumente gleichen sich solche Fehler in der Praxis teilweise aus.
Die Beispielstelle
Die folgenden Abschnitte enthalten Beispiele. Sie verwenden eine erfundene englische Textstelle, wie sie in aktivistischen Texten vorkommen könnte. Die Textstelle unten wird als vollständiges Dokument behandelt.
We were hit by the heat again this summer. So the schools shut for a week and nobody could sleep. The families felt that our mayor had already given up.
Für sie ergeben sich diese Zählungen:
| Satz | Wörter | Silben | Buchstaben | Lange Wörter | Wörter mit 3+ Silben | Wörter mit 1 Silbe |
|---|---|---|---|---|---|---|
| We were hit by the heat again this summer. | 9 | 11 | 33 | 0 | 0 | 7 |
| So the schools shut for a week and nobody could sleep. | 11 | 13 | 43 | 1 | 1 | 10 |
| The families felt that our mayor had already given up. | 10 | 15 | 44 | 2 | 2 | 7 |
| Ganze Textstelle | 30 | 39 | 120 | 3 | 3 | 24 |
Die langen Wörter sind schools, families und already. Die dreisilbigen Wörter sind nobody, families und already. Die Silbenzahl geht bei mayor von der Schätzung mit einer Silbe aus (tatsächlich hat das Wort zwei). Ziffern kommen nicht vor, die Zahl der Buchstaben und Ziffern beträgt also 120. Weil the dreimal vorkommt, hat die Textstelle 28 verschiedene Wörter.
Lesbarkeit
Lesbarkeitsformeln schätzen, wie leicht ein Text zu lesen ist, und stützen sich dabei auf nur zwei Größen (die Länge der Sätze und die Länge der Wörter), die sich vergleichsweise einfach und objektiv aus einem Text gewinnen lassen. Längere Sätze beanspruchen das Arbeitsgedächtnis stärker und sind deshalb schwerer zu lesen. Je länger Wörter sind, desto seltener und abstrakter sind sie meist auch. Den Zusammenhang zwischen diesen beiden Längen und dem Textverständnis von Versuchspersonen (etwa Schulkindern) ermittelte man in Studien, in denen man Testtexte vorlegte und prüfte, wie gut sie verstanden wurden. Die merkwürdig genauen Konstanten wie 206,835 stammen daher, dass eine mathematische Funktion an diese Beobachtungen angepasst wurde.
In einer Studie können Sie mit Lesbarkeitswerten die Texte eines Mediums mit denen anderer vergleichen oder prüfen, welche Seite einer Debatte einfachere oder kompliziertere sprachliche Strukturen verwendet.
Die Schulstufe, die manche Formeln angeben, bezeichnet die Zahl der Schuljahre, die nötig sind, um den Text ohne große Mühe oder Verwirrung angemessen zu verstehen. Wenn kein anderes Schulsystem genannt ist, beziehen sich die Stufen auf das amerikanische Schulsystem, in dem Stufe 8 ungefähr einem Alter von 13 oder 14 Jahren entspricht.
Auch ein Satz aus lauter kurzen Wörtern kann schwer verständlich sein, und vertrauter, verständlicher Fachwortschatz zählt in diesen Formeln allein nach seiner Länge, unabhängig davon, ob ein Begriff tatsächlich verstanden wird.
Die Symbole in den Lesbarkeitsformeln:
| Symbol | Bedeutung | In der Beispielstelle |
|---|---|---|
| Wörter | 30 | |
| Sätze | 3 | |
| Silben | 39 | |
| Buchstaben | 120 | |
| Buchstaben und Ziffern | 120 | |
| Wörter mit drei oder mehr Silben | 3 | |
| Lange Wörter, mit mehr als sechs Buchstaben | 3 | |
| Wörter mit einer Silbe | 24 |
Zwei Größen kehren immer wieder. ist die durchschnittliche Zahl der Wörter pro Satz; hier ist = 30 ÷ 3 = 10. ist die durchschnittliche Zahl der Silben pro Wort; hier ist = 39 ÷ 30 = 1,3.
Durchschnittliche Satzlänge
Durchschn. Satzlänge ist die durchschnittliche Zahl der Wörter pro Satz und wird als berechnet. Die Kennzahl gibt es für alle drei Sprachen; für die Beispielstelle beträgt sie 10,0 Wörter pro Satz. Die meisten der unten vorgestellten Formeln beruhen auf diesem Wert, deshalb erklärt er einen großen Teil ihres Verhaltens. Teilen Sie einen langen Satz in zwei, zeigt jeder Wert eine bessere Lesbarkeit an.
Flesch Reading Ease
Flesch Reading Ease, entwickelt von Rudolf Flesch, bewertet englische Texte anhand der durchschnittlichen Satzlänge und der durchschnittlichen Zahl der Silben pro Wort. Die Werte liegen meist zwischen 0 und 100; höhere Werte bedeuten leichter lesbare Texte. Die Formel lautet:
, und sind die Werte Ihres Textes aus der Tabelle oben. Der Ausgangswert ist also recht hoch, und die Formel zieht Punkte für lange Sätze und für Wörter mit vielen Silben ab. Die Silben wiegen weit schwerer als die Satzlänge; steigt die durchschnittliche Silbenzahl pro Wort um eine Zehntelsilbe, kostet das etwa 8,5 Punkte, ungefähr so viel wie acht zusätzliche Wörter pro Satz im Durchschnitt.
Für die Beispielstelle:
Der Inspektor zeigt 86,7. Rudolf Flesch teilte seine Werte in Bereiche ein:
| Wert | Beschreibung |
|---|---|
| 90–100 | Sehr leicht |
| 80–90 | Leicht |
| 70–80 | Ziemlich leicht |
| 60–70 | Standard; einfaches Englisch |
| 50–60 | Ziemlich schwer |
| 30–50 | Schwer |
| 0–30 | Sehr schwer |
Der Wert von 86,7 bedeutet hier, dass die Textstelle leicht ist. Das ist zu erwarten, denn die Sätze sind kurz und bestehen überwiegend aus einsilbigen Wörtern. „Uns läuft die Zeit davon (Englisch)“, die englische Übersetzung des Meinungsbeitrags, erreicht 71,6 und ist damit ziemlich leicht zu verstehen. Sehr lange Sätze können Werte unter 0 ergeben, sehr kurze Wörter Werte über 100.
Flesch-Kincaid-Stufe
Die Flesch-Kincaid-Stufe, entwickelt für Ausbildungshandbücher der US-Marine, verwendet dieselben beiden Größen wie Flesch Reading Ease, rechnet sie aber in Schulstufen des US-amerikanischen Bildungssystems um.
Setzt man die Zahlen ein, ergibt sich:
Auf eine Nachkommastelle aufgerundet entspricht 3,7 der Stufe, auf der Kinder im dritten und vierten Schuljahr eine Textstelle verstehen. Da die Flesch-Kincaid-Stufe und Flesch Reading Ease auf denselben Größen beruhen, geht ein hoher Wert bei der einen meist mit einem niedrigen Wert bei der anderen einher.
Gunning Fog
Robert Gunnings Fog-Index schätzt anhand der Satzlänge und der Schwierigkeit der Wörter, welche Schulstufe nötig ist, um Ihr Dokument zu verstehen. Als schwere Wörter galten bei Gunning alle Wörter mit drei oder mehr Silben, ausgenommen Komposita aus geläufigen Bestandteilen, Namen und Wörter, die nur durch Endungen wie -ed auf drei Silben kommen.
ist die Zahl der schweren Wörter; LemmaLoom nimmt nur Namen aus, also Wörter, die die Indizierung als Eigennamen bestimmt, etwa Lerchenhafen. Der Faktor 100 macht aus dem Anteil der schweren Wörter einen Prozentwert.
Die Beispielstelle enthält drei schwere Wörter (nobody, families und already) und keinerlei Namen. Die Rechnung ergibt:
Ein Fog-Index von 8 bedeutet, dass etwa acht Schuljahre nötig sind; 12 entspricht dem letzten Jahr der High School in den USA. Weil der zweite Teil der Formel ausschließlich Wörter mit drei oder mehr Silben berücksichtigt, beeinflussen schon wenige solche Wörter das Ergebnis erheblich.
SMOG
Die SMOG-Stufe (Simple Measure of Gobbledygook, etwa „einfaches Maß für Kauderwelsch“) stammt von G. Harry McLaughlin. Dieses Lesbarkeitsmaß zählt die Wörter mit drei oder mehr Silben, und zwar bei McLaughlin in einer Stichprobe von 30 Sätzen. LemmaLoom zählt im ganzen Dokument und rechnet das Ergebnis auf 30 Sätze um.
ist hier die Zahl der Wörter mit drei oder mehr Silben. Durch die Quadratwurzel steigt die Stufe immer langsamer, je mehr solche Wörter hinzukommen.
Die Beispielstelle oben hat Wörter mit drei oder mehr Silben in 3 Sätzen. Auf 30 Sätze hochgerechnet ergibt das :
Die SMOG-Stufe gibt die Schulstufe an, auf der ein Text vollständig verstanden wird. Deshalb liegt der Wert im Allgemeinen höher als die Flesch-Kincaid-Stufe derselben Textstelle (8,8 gegenüber 3,7). In kürzeren Texten fallen Wörter mit drei oder mehr Silben stark ins Gewicht, was zu dem hohen Ergebnis für diese Textstelle führt.
Coleman-Liau
Der Coleman-Liau-Index unterscheidet sich von den bisherigen Lesbarkeitsindizes dadurch, dass er die Schulstufe aus der Zahl der Buchstaben statt der Silben vorhersagt. Bei seiner Entwicklung kam es darauf an, dass ein Computer ihn leicht berechnen konnte; statt die Silben zu schätzen, was Fehler verursachen kann, zählt er deshalb die genaue Zahl der Buchstaben.
In der Formel steht für die Buchstaben pro hundert Wörter und für die Sätze pro hundert Wörter. Mehr Buchstaben pro Wort erhöhen die vorhergesagte Stufe, mehr Sätze pro hundert Wörter (also kürzere Sätze) senken sie.
In der Beispielstelle ergeben 120 Buchstaben und 3 Sätze 400 Buchstaben und 10 Sätze pro 100 Wörter:
Die vorhergesagte Stufe liegt zwischen dem vierten und dem fünften Schuljahr.
ARI
Wie Coleman-Liau berechnet auch der Automated Readability Index die entsprechende amerikanische Schulstufe ohne Silben, und zwar aus den Zeichen pro Wort. Zeichen sind hier Buchstaben und Ziffern (die Variable in der Tabelle oben).
Mit und ergibt sich:
Da ARI Ziffern mitzählt und Coleman-Liau nicht, erhält ein englisches Dokument mit vielen Ziffern, etwa ein Bericht voller Messwerte und Jahreszahlen, bei ARI eine vergleichsweise höhere Stufe als bei Coleman-Liau.
LIX
Der Lesbarkeitsindex (schwedisch Läsbarhetsindex) von Carl-Hugo Björnsson, kurz LIX, ist die Summe aus der durchschnittlichen Satzlänge und dem Prozentanteil langer Wörter einer Textstelle. LemmaLoom bietet ihn für englische und deutsche Texte an. Die Formel lautet:
ist darin die Gesamtzahl der langen Wörter der Textstelle. Mit 3 langen Wörtern unter den 30 Wörtern der Beispielstelle:
Die Skala reicht ungefähr von 20 (sehr leicht) bis 60 (sehr schwer), mit 40 (mittlere Schwierigkeit) für den Durchschnitt. Die Beispielstelle erreicht 20 und gilt damit als sehr leicht.
Weil LIX lange Wörter nach Buchstaben statt nach Silben bestimmt, wird er in jeder Sprache mit genau demselben Verfahren berechnet. LIX-Werte verschiedener Sprachen lassen sich trotzdem nicht vergleichen. Unter anderem weil das Deutsche Komposita zusammenschreibt (etwa Hitzewelle für heat wave), erreicht die deutsche Fassung eines Textes meist einen höheren Wert als die englische. So erreicht „Uns läuft die Zeit davon“ im Projekt „Klimadebatte“ 41, die englische Übersetzung „Uns läuft die Zeit davon (Englisch)“ dagegen 34. Die deutsche Fassung der Beispielstelle (unten) hat neun lange Wörter und erreicht .
Flesch-Amstad (Deutsch)
Toni Amstad übertrug die Skala von Flesch Reading Ease auf deutsche Texte, deren Wörter meist mehr Silben haben. Wie bei Flesch Reading Ease liegen die Ergebnisse in der Regel zwischen 0 und 100, und höhere Werte bedeuten bessere Lesbarkeit.
Die deutschen Beispiele verwenden diese deutsche Fassung der Textstelle:
Auch in diesem Sommer hat uns die Hitze wieder getroffen. Die Schulen blieben eine Woche zu, und niemand konnte schlafen. Die Familien glaubten, dass unser Bürgermeister schon längst aufgegeben hatte.
| Zählung | Wert |
|---|---|
| Wörter | 30 |
| Sätze | 3 |
| Silben | 54 |
| Buchstaben | 166 |
| Wörter mit drei oder mehr Silben | 4 (getroffen, Familien, Bürgermeister, aufgegeben) |
| Lange Wörter | 9 (getroffen, Schulen, blieben, niemand, schlafen, Familien, glaubten, Bürgermeister, aufgegeben) |
| Wörter mit einer Silbe | 12 |
Die Silbenschätzung zählt Familien mit drei Silben, obwohl das Wort vier hat. Mit ergibt sich:
Nach Fleschs Tabelle, deren Bereiche auch hier gelten, liegt diese deutsche Fassung im Bereich Standard. Ein Vergleich mit dem Wert der englischen Fassung (86,7) sagt nichts darüber, welche Fassung leichter zu lesen ist, denn die beiden Formeln wurden an verschiedene Sprachen angepasst.
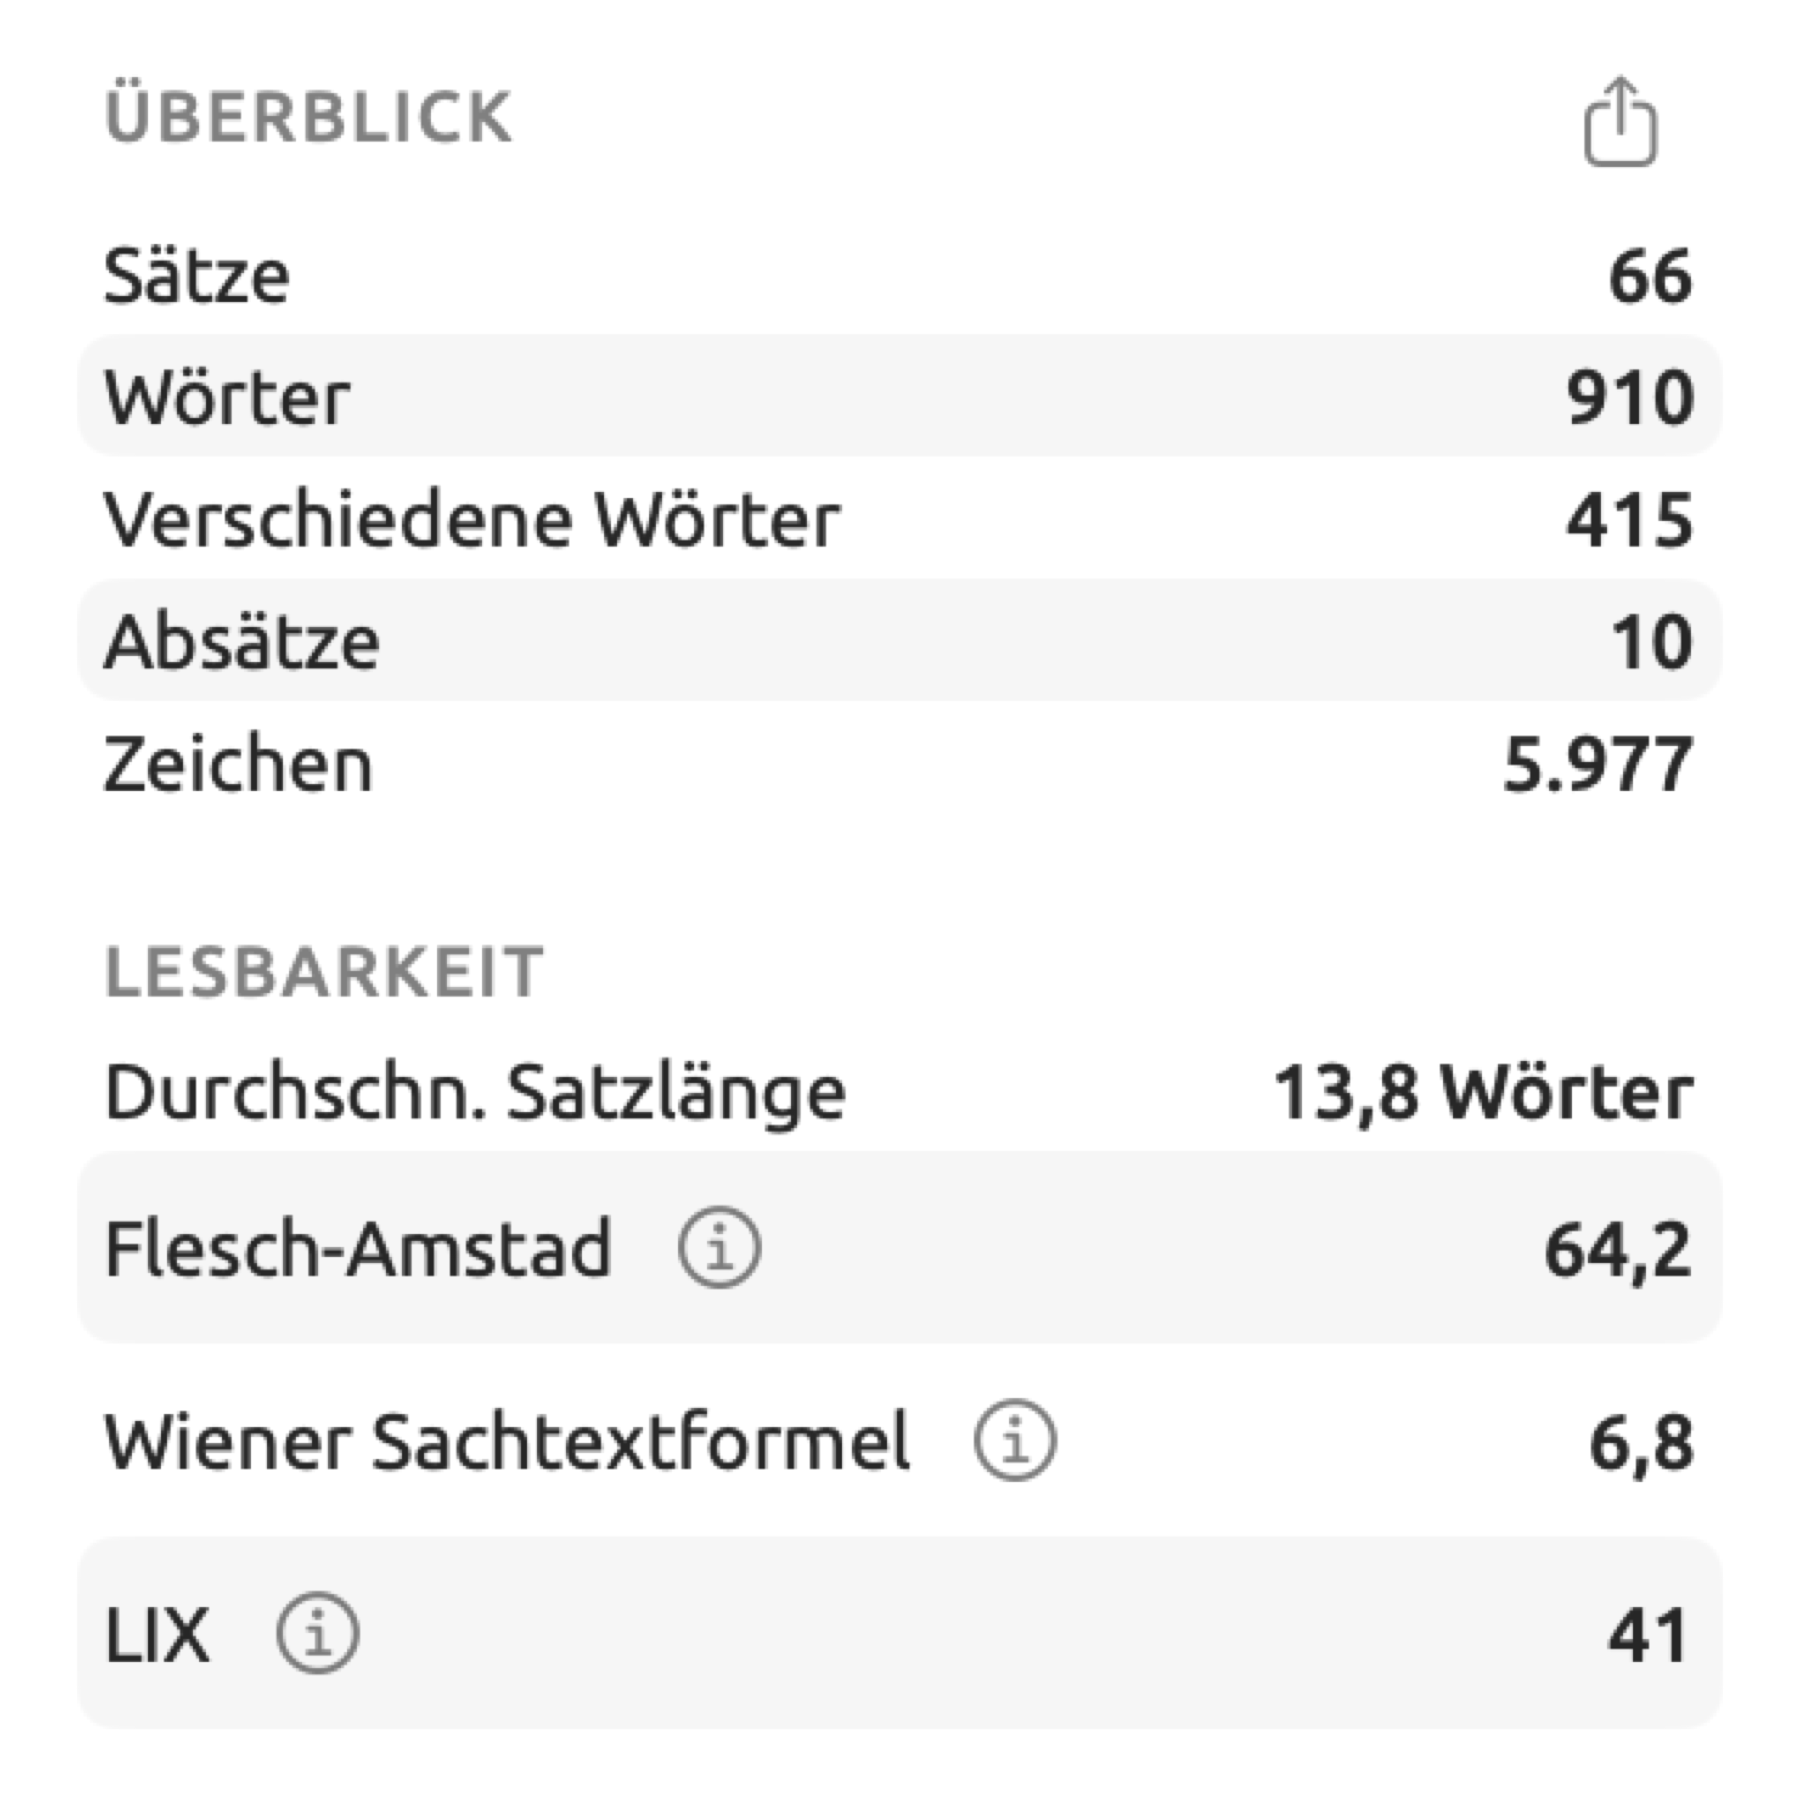
Die Abbildung unten zeigt „Uns läuft die Zeit davon“ im Projekt „Klimadebatte“. Der Text erreicht 64,2 bei Flesch-Amstad und 6,8 bei der Wiener Sachtextformel.
Wiener Sachtextformel (Deutsch)
Die Wiener Sachtextformel entwickelten Richard Bamberger und Erich Vanecek für deutschsprachige Texte. Sie schätzt die Schulstufe eines Textes in den Schulsystemen des deutschen Sprachraums, auf einer Skala von etwa 4 (leicht) bis 15 (sehr schwer). LemmaLoom verwendet die erste von mehreren Fassungen der Formel, die vier Größen berücksichtigt (den Prozentanteil der Wörter mit drei oder mehr Silben, die durchschnittliche Satzlänge, den Prozentanteil langer Wörter und den Prozentanteil einsilbiger Wörter):
Für die deutsche Textstelle oben ergeben sich die Prozentanteile in der Reihenfolge der Formel als , und . Der vierte Teil wird abgezogen, weil viele einsilbige Wörter einen Text leichter machen. Eingesetzt ergibt sich:
Das ergibt:
Auf eine Nachkommastelle gerundet beträgt der Wert also etwa 6,0 und liegt damit nahe am unteren Ende der Skala; die Textstelle gilt als leicht.
Chinesische Kennzahlen
Die Formeln oben messen die Lesbarkeit alphabetisch geschriebener Sprachen anhand von Silben oder Buchstaben. Da diese Größen für chinesische Texte nicht taugen, bietet der Abschnitt Lesbarkeit eines chinesischen Dokuments unter Durchschn. Satzlänge drei Alternativen:
- Zeichen pro Satz ist das Verhältnis der Zahl der chinesischen Schriftzeichen zur Zahl der Sätze im Text. Buchstaben anderer Alphabete zählen hier ebenfalls mit. Auch in Schriftzeichen geschriebene Zahlen tragen zur Zeichenzahl bei; 十二 besteht zum Beispiel aus zwei Zeichen. Zahlen in arabischen Ziffern wie 12 gelten dagegen nicht als chinesische Schriftzeichen. Satzzeichen erhöhen die Zeichenzahl wie üblich ebenfalls nicht.
- Durchschn. Wortlänge wird in Zeichen gemessen und als Zahl der Zeichen geteilt durch die Zahl der Wörter berechnet. Dokumente mit vielen Wörtern aus zwei Zeichen wie 气候 oder 邻居 erreichen höhere Werte als solche, in denen Wörter aus einem Zeichen häufig sind.
- Partikeldichte gibt an, wie viele Partikeln auf hundert Wörter kommen. Als Partikeln gelten die Wörter, die die Lens Partikeln annotiert, nämlich die Verbpartikeln 了, 着 und 过, außerdem 的, 地 und 得 sowie Zählwörter wie 个 (siehe Konstruktionen und Partikeln (Chinesisch) in Kapitel 6, Lenses). Satzfinale Partikeln wie 吗, 呢 und 吧 werden nicht gezählt.
Diese beiden Sätze zerlegt die Indizierung so in Wörter:
我们 / 等 / 了 / 十二 / 个 / 小时 。 邻居 / 也 / 非常 / 担心 。
Das ergibt zehn Wörter mit sechzehn Zeichen in zwei Sätzen. Zwei Partikeln kommen vor, nämlich 了 und das Zählwort 个. Zeichen pro Satz beträgt also , Durchschn. Wortlänge Zeichen und Partikeldichte Partikeln pro hundert Wörter.
Die chinesischen Kennzahlen lassen sich keinen Schulstufen zuordnen. Die drei dienen nur dazu, ein chinesisches Dokument mit einem anderen zu vergleichen; für sich genommen sagt eine höhere Partikeldichte nichts darüber, wie schwer ein Text ist.
Die Lesbarkeitswerte lesen
Wendet man diese Formeln auf die englische Beispielstelle mit 30 Wörtern an, ergibt sich:
| Kennzahl | Wert | Art der Skala |
|---|---|---|
| Flesch Reading Ease | 86,7 | Lesbarkeit, 0 bis 100 |
| Flesch-Kincaid-Stufe | 3,7 | US-Schulstufe |
| Gunning Fog | 8,0 | Schuljahre |
| SMOG | 8,8 | US-Schulstufe |
| Coleman-Liau | 4,8 | US-Schulstufe |
| ARI | 2,4 | US-Schulstufe |
| LIX | 20 | Schwierigkeit, etwa 20 bis 60 |
Die fünf Formeln schätzen die nötige Schulbildung für dieselbe Textstelle auf Werte von 2,4 bis 8,8. Die Unterschiede entstehen, weil jede Formel die Merkmale anders gewichtet. Diese Textstelle enthält in relativ kurzen Sätzen mehrere Wörter mit drei oder mehr Silben; das treibt Gunning Fog und SMOG nach oben, wirkt sich auf ARI aber kaum aus. In längeren Dokumenten werden die Abweichungen zwischen den Formeln kleiner, verschwinden aber nie ganz. Für „Uns läuft die Zeit davon (Englisch)“ reichen die Schätzungen der fünf Formeln von 6,8 bis 9,9.
Wortschatz
Der Abschnitt Lexik befasst sich mit den Wörtern Ihres Dokuments. An diesen Kennzahlen erkennen Sie, ob ein Dokument stark auf wiederkehrenden Wortschatz setzt oder einen abwechslungsreichen Wortschatz hat. Das Type-Token-Verhältnis zum Beispiel zeigt, wie viele verschiedene Lemmata im Verhältnis zur Gesamtzahl der Wörter verwendet werden. Hier wie bei MATTR und dem Hapax-Anteil zählen verschiedene Formen eines Lemmas nur einmal.
Type-Token-Verhältnis
Das Type-Token-Verhältnis misst die Vielfalt des Wortschatzes als Zahl der verschiedenen Wörter geteilt durch die Gesamtzahl der Wörter:
ist hier die Zahl der verschiedenen Wörter und die Zahl der Wörter. Ein Verhältnis von 1 bedeutet, dass jedes Wort genau einmal vorkommt; je seltener sich Wörter im Dokument wiederholen, desto näher liegt das Verhältnis an 1.
In der Beispielstelle wiederholt sich nur the, das insgesamt dreimal vorkommt; damit ist und das Type-Token-Verhältnis . Hätte ein Bericht mit 4.000 Wörtern 800 verschiedene Wörter, läge sein Verhältnis bei .
Ein niedrigeres Verhältnis bedeutet nicht zwangsläufig einen ärmeren Wortschatz. Das Verhältnis sinkt bei längeren Dokumenten immer, weil häufige Wörter sich ständig wiederholen und neue Wörter immer seltener hinzukommen.
MATTR
MATTR, das gleitende Type-Token-Verhältnis (moving-average type-token ratio), misst die lexikalische Vielfalt unabhängig von der Länge des Dokuments. LemmaLoom berechnet dazu zuerst das Type-Token-Verhältnis in einem Fenster aus den ersten hundert Wörtern eines Textes, verschiebt das Fenster dann um ein Wort, berechnet das Type-Token-Verhältnis der Wörter 2 bis 101 und so weiter bis zum Ende. MATTR ist der Durchschnitt dieser Verhältnisse.
Dabei sind , usw. die Zahlen der verschiedenen Wörter in den aufeinanderfolgenden Fenstern aus 100 Wörtern; ist die Gesamtzahl der Fenster, also die Zahl der Wörter minus 99. Teilt man jedes durch 100, erhält man das Verhältnis des jeweiligen Fensters; die Summe geteilt durch ergibt den Durchschnitt.
Zur Veranschaulichung im kleinen Maßstab stellen Sie sich ein Fenster aus 4 statt 100 Wörtern vor, und nehmen Sie die acht Wörter wir warnen und wir warten und wir warnen. Die fünf Fenster sind:
| Fenster | Verschiedene Wörter | Verhältnis |
|---|---|---|
| wir warnen und wir | 3 | 0,75 |
| warnen und wir warten | 4 | 1,00 |
| und wir warten und | 3 | 0,75 |
| wir warten und wir | 3 | 0,75 |
| warten und wir warnen | 4 | 1,00 |
Der Durchschnitt beträgt hier . Das Type-Token-Verhältnis der acht Wörter mit ihren 4 verschiedenen Wörtern beträgt dagegen nur .
Bei einem Dokument mit 100 Wörtern oder weniger ist MATTR einfach gleich dem Type-Token-Verhältnis.
Hapax-Anteil
Das Wort Hapax, griechisch für „einmal“, bezeichnet ein Wort, das in Ihrem Dokument genau einmal vorkommt. Der Hapax-Anteil ist der Anteil der verschiedenen Wörter, die Hapaxe sind:
ist die Zahl der verschiedenen Wörter, die genau einmal vorkommen, und die Gesamtzahl der verschiedenen Wörter. Manchmal wird stattdessen durch die Zahl der Wörter geteilt, was einen kleineren Wert ergibt. In der Beispielstelle kommen von den 28 verschiedenen Wörtern 27 genau einmal vor, ein Anteil von , angezeigt als 96 %. Im angenommenen Dokument mit 4.000 Wörtern und 800 verschiedenen Wörtern ergäben 400 Hapaxe einen Anteil von 50 %.
Ein hoher Hapax-Anteil zeigt meist, dass viele Wörter nur beiläufig vorkommen, Eigennamen eingeschlossen. Wie das Type-Token-Verhältnis hängt der Hapax-Anteil von der Länge ab; in einem kurzen Dokument kommen die meisten Wörter genau einmal vor.
Lexikalische Dichte und Stoppwort-Anteil
Stoppwort-Anteil ist der Anteil der Wörter eines Dokuments, die auf der Stoppwortliste für die Sprache des Dokuments stehen. Lexikalische Dichte ist umgekehrt der Anteil der Wörter, die keine Stoppwörter sind; beide Anteile ergeben zusammen 100 Prozent.
Die Beispielstelle besteht aus dreißig Wörtern. Darunter sind siebzehn Stoppwörter, nämlich we, were, by, the, again und this im ersten Satz, so, the, for, a, and und could im zweiten und the, that, our, had und up im dritten. Der Stoppwort-Anteil dieser Textstelle beträgt also , die lexikalische Dichte .
Natürliche gesprochene Sprache hat wegen der Pronomen und Hilfsverben meist eine geringere lexikalische Dichte als redigierte Texte. Ist der Stoppwort-Anteil eines Transkripts im Vergleich zu natürlicher Rede niedrig, kann das darauf hindeuten, dass zusammengefasst statt wörtlich transkribiert wurde.
Die Stoppwortlisten sind eingebaut und für jede Sprache fest:
- Die englische Liste enthält rund 160 Wörter, darunter Artikel, Pronomen, Präpositionen und Konjunktionen, die Formen von be, have und do, sämtliche Modalverben wie can, should und must, die Verneinungen not und no sowie häufige Adverbien wie very, also und again.
- Die deutsche Liste enthält rund 210 Wörter, neben Artikeln, Pronomen, Präpositionen und Hilfsverben auch die Modalpartikeln ja, doch, mal, eben und halt.
- Die chinesische Liste enthält etwa 150 Wörter, darunter 的, 了 und 是, Pronomen, 不 und 没有 sowie häufige Präpositionen und Adverbien.
Ein Wort gilt als Stoppwort, wenn sein Lemma oder seine Tokenform auf der Liste steht. Zu den Inhaltswörtern, die wie Funktionswörter aussehen können, gehört nobody in der Beispielstelle. Das Abfragefeld Stoppwort verwendet dieselben Listen.
Durchschnittliche Wortlänge
Durchschn. Wortlänge im Abschnitt Lexik ist das Verhältnis von Buchstaben zu Wörtern, , angegeben in Buchstaben. Die Beispielstelle hat Buchstaben pro Wort, ihre deutsche Fassung . Da Zahlen keine Buchstaben enthalten, haben Texte mit vielen Zahlen eine etwas niedrigere Durchschn. Wortlänge als Texte ohne. Bei chinesischen Texten erscheint die Kennzahl unter Lesbarkeit und wird in Zeichen angegeben.
Syntax
Der Abschnitt Syntax untersucht über die bloße Satzlänge hinaus, wie Ihre Sätze gebaut sind. Die Kennzahlen betrachten etwa den Abstand zwischen zusammengehörigen Wörtern, die Verschachtelung von Teilsätzen in anderen Teilsätzen und ähnliche Merkmale, die zeigen, wie komplex der Satzbau ist. Sie stützen sich auf zwei Teile der Grammatikanalyse.
Die Dependenzanalyse untersucht die Beziehungen zwischen den Wörtern eines Satzes, und zwar danach, von welchem Kopf jedes Wort abhängt. In a fair share hängen zum Beispiel fair und a von share ab. Jeder Satz hat ein Wort, das von keinem anderen abhängt, die Wurzel (meist das Hauptverb des Satzes). Die Verbindungen zwischen den Wörtern und ihren Köpfen zeigt der Inspektor grafisch im Tab Grammatik (siehe Kapitel 11, Der Grammatik-Inspektor).
Die Phrasenanalyse fasst die Wörter eines Satzes zu ineinander verschachtelten Phrasen und Teilsätzen zusammen.
Mittlere Dependenzdistanz
Die Dependenzdistanz ist der Abstand zwischen einem Wort und seinem Kopf, gemessen in Positionen im Satz. Die mittlere Dependenzdistanz ist der Durchschnitt der Dependenzdistanzen aller Wörter eines Dokuments, die einen Kopf haben:
bis sind die einzelnen Dependenzdistanzen, und ist die Zahl der Wörter mit Kopf, also aller Wörter außer der Wurzel jedes Satzes. Satzzeichen belegen Positionen, tragen aber nicht zur Summe der Dependenzdistanzen bei.
Im Satz The richest countries rarely pay a fair share. ist pay das Wurzelverb. Die Nummern geben die Position der Wörter an, beginnend mit 1. Die Wörter und ihre Köpfe:
| Wort | Position | Kopf | Position des Kopfes | Distanz |
|---|---|---|---|---|
| The | 1 | countries | 3 | 2 |
| richest | 2 | countries | 3 | 1 |
| countries | 3 | pay | 5 | 2 |
| rarely | 4 | pay | 5 | 1 |
| a | 6 | share | 8 | 2 |
| fair | 7 | share | 8 | 1 |
| share | 8 | pay | 5 | 3 |
Die Summe dieser 7 Dependenzdistanzen beträgt 12. Die mittlere Dependenzdistanz dieses Satzes ist also . Dependenzdistanzen sind groß, wenn zusammengehörige Wörter weit auseinanderstehen. In der Forschung zur Satzverarbeitung gehen größere Dependenzdistanzen mit höherem Verarbeitungsaufwand beim Lesen einher. Lange Sätze, eingebettete Teilsätze und die Verbendstellung deutscher Nebensätze erhöhen den Wert. Die mittlere Dependenzdistanz hat keine allgemeingültige Skala; aussagekräftig ist sie nur im Vergleich mit anderen Dokumenten derselben Sprache.
Durchschnittliche Baumtiefe
Folgt man von einem Wort aus seinen Köpfen nach oben bis zur Wurzel der Hierarchie, bestimmt dieser Weg seine Tiefe. Die Zahl der nötigen Schritte ist die Tiefe des Wortes. Die Tiefe eines Satzes ist der höchste Tiefenwert unter seinen Wörtern. Durchschn. Baumtiefe ist einfach die durchschnittliche Tiefe der Sätze eines Dokuments.
Im Satz oben hängen countries, rarely und share direkt von der Wurzel ab; sie brauchen also nur einen Schritt (Tiefe 1). The, richest, a und fair brauchen zwei Schritte bis zur Wurzel; die Tiefe dieses Satzes ist daher 2. Nehmen Sie als weiteres Beispiel ein Dokument mit Sätzen der Tiefen 2, 4 und 6. Seine durchschnittliche Baumtiefe beträgt dann .
Teilsätze pro Satz und eingebettete Teilsätze
Teilsätze pro Satz gibt an, wie viele Teilsätze laut Phrasenanalyse im Durchschnitt auf einen Satz kommen. Berechnet wird , wobei die Gesamtzahl der Teilsätze und die Gesamtzahl der Sätze Ihres Dokuments ist. Anteil eingebetteter Teilsätze gibt an, wie groß der Anteil der Teilsätze Ihres Dokuments ist, die keine Hauptsätze sind. Für jeden Satz mit mindestens einem Teilsatz wird genau ein Hauptsatz angenommen. Die Kennzahl teilt daher durch , wobei die Zahl der Sätze mit mindestens einem Teilsatz ist. Zusammen zeigen die beiden Kennzahlen, wie stark jemand einen Gedanken in einen anderen einbettet, statt die Gedanken nebeneinanderzustellen.
Formal ist Teilsätze pro Satz also und Anteil eingebetteter Teilsätze
Die Zählung folgt eng der Phrasenanalyse. So zählt ein englischer Nebensatz wie because the heat was dangerous als zwei Schichten, denn er enthält den inneren Teilsatz the heat was dangerous. Der Satz We stayed inside because the heat was dangerous. hat deshalb insgesamt drei Teilsätze (den ganzen Satz, den because-Satz und den Teilsatz darin). Der Satz Nobody complained. hat dagegen nur einen. Für ein Dokument aus diesen beiden Sätzen ergibt sich:
- Teilsätze pro Satz beträgt .
- Anteil eingebetteter Teilsätze beträgt , also 50 %.
Wegen dieser Schichtung fallen die Werte höher aus, als wenn man Teilsätze nach Schulgrammatik zählt.
Passivsätze
Passivsätze ist der Anteil der Sätze Ihres Dokuments, die mindestens eine Passivkonstruktion enthalten. Mehrere Passive in einem Satz ändern die Zählung nicht. Enthalten zum Beispiel in einem Dokument mit insgesamt 40 Sätzen sechs Sätze ein Passiv, beträgt der Anteil .
Was als Passiv zählt, hängt von der Sprache ab:
- Im Englischen erkennt die Grammatikanalyse Subjekt und Hilfsverb eines Passivsatzes, etwa in This report was prepared by the agency’s climate monitoring service.
- Im Chinesischen zählen alle Sätze mit 被 und anderen erkannten Passivkonstruktionen, wie beim Aspekt 被-Passiv der Lens Konstruktionen.
- Im Deutschen zählt ein Passiv mit werden und Partizip II, ob das Agens genannt wird oder nicht, etwa Dieser Bericht wurde erstellt und Dieser Bericht wurde von der Klimaüberwachung des Amtes erstellt aus „Hitzebericht 2024“. Ein Passiv mit sein zählt nur, wenn eine Phrase mit von oder durch das Agens nennt, wie beim Mittel Passiv der Lens Rhetorik.
Manchmal lässt ein Passiv offen, wer gehandelt hat. In „Hitzebericht 2024“ heißt es zum Beispiel, dass die Zuständigkeit für die Betreuung allein lebender älterer Menschen nicht eindeutig geregelt war.
Struktur
Der Abschnitt Struktur enthält drei Kennzahlen.
Dialoganteil gibt an, wie viel Prozent der Wörter zwischen doppelten Anführungszeichen stehen. Nehmen Sie etwa den erfundenen Satz Meine Nachbarin sagte immer: „Unsere Sommer sind mild.“ Hier stehen vier von acht Wörtern in Anführungszeichen, ein Dialoganteil von 50 %. In Nachrichtentexten wie „Streit um die CO2-Steuer“ kennzeichnen Anführungszeichen direkte Zitate, und der Anteil zeigt, wie viel des Textes insgesamt aus den Worten anderer besteht. Um den Anteil zu schätzen, bildet LemmaLoom Paare aus den Anführungszeichen:
- Gerade Anführungszeichen (
") öffnen und schließen abwechselnd. - Typografische Anführungszeichen öffnen mit “ und schließen mit ”. In deutschen Dokumenten öffnet „ und schließt “.
- « und die chinesischen Eckklammern 「 und 『 öffnen, », 」 und 』 schließen. In deutschen Dokumenten öffnet » und « schließt.
- Einfache Anführungszeichen werden ignoriert.
Ein Anführungszeichen ohne Gegenstück lässt alle folgenden Wörter als zitiert zählen. Ein überraschend hoher Wert deutet daher oft auf ein verirrtes Anführungszeichen irgendwo im Dokument hin.
Fragen und Ausrufe gibt den Prozentanteil der Sätze an, die mit einem Fragezeichen oder einem Ausrufezeichen enden, einschließlich der vollbreiten Zeichen in chinesischen Texten. Es zählen nur Sätze, deren letztes Token ein Ausrufe- oder Fragezeichen ist; Sätze, die nach dem Fragezeichen mit einem schließenden Anführungszeichen enden, zählen nicht. In einem Dokument mit 80 Sätzen, darunter 18 Fragen und 2 Ausrufe, beträgt Fragen und Ausrufe . Ein hoher Wert in Meinungsbeiträgen und Reden kann auf rhetorische Fragen hindeuten, etwa die Frage, die in „Uns läuft die Zeit davon“ ein Lesezeichen trägt. Wie immer beziehen sich die Statistiken auf das ganze Dokument, in einem Transkript wie „Radiodebatte“ also auch auf die Fragen der Moderation.
Sätze pro Absatz schließlich ist die Gesamtzahl der Sätze geteilt durch die Zahl der Absätze. Zum Beispiel ergeben 120 Sätze in 40 Absätzen 3,0 Sätze pro Absatz. Transkripte, die LemmaLoom erstellt, beenden einen Absatz bei jedem Sprecherwechsel und bei längeren Pausen; der Wert gibt dort also ungefähr an, wie viele Sätze jemand am Stück sagt.
Wortarten, Funktionen und Phrasen
Unter den Kennzahlen zeigen drei Balkendiagramme, wie sich die Wörter und Phrasen des gewählten Dokuments auf Kategorien verteilen. Jede Zeile enthält den Namen der Kategorie, einen Balken und eine Zahl, die angibt, wie oft die Kategorie im Dokument vorkommt. Es erscheinen nur Kategorien, die im Dokument vorkommen; die Balken haben die Standardfarben der jeweiligen Lens, auch wenn im Bereich Lenses der Einstellungen andere Farben gewählt wurden.
- Wortarten zeigt die Zahl der Wörter in den zehn Klassen der Lens Wortklasse, von Substantiv bis Interjektion (siehe Wortklasse in Kapitel 6, Lenses). Alle anderen Wörter, auch fremdsprachige, gehen nicht in diese Statistik ein.
- Funktionen zeigt die Zahl der Wörter in jeder der zehn Funktionen der Lens Grammatische Funktion, von Subjekt bis Konnektor (siehe Grammatische Funktion in Kapitel 6, Lenses). Die Wurzel jedes Satzes, die keine Funktion hat (meist das Hauptverb), bleibt dabei ebenso unberücksichtigt wie Wörter, deren Beziehung zu keiner der zehn grammatischen Funktionen passt. Die Summe dieser Statistik liegt daher unter der Gesamtzahl der Wörter des Dokuments.
- Phrasen zeigt die Zahl der Phrasen jeder Art der Lens Phrase, von Nominalphrase bis Interjektion (siehe Phrase in Kapitel 6, Lenses). Verschachtelte Phrasen zählen jeweils einzeln; in our valley zählt zum Beispiel als Präpositionalphrase, und our valley wird zusätzlich als Nominalphrase gezählt. Teilsätze werden dagegen gesondert unter Syntax erfasst.
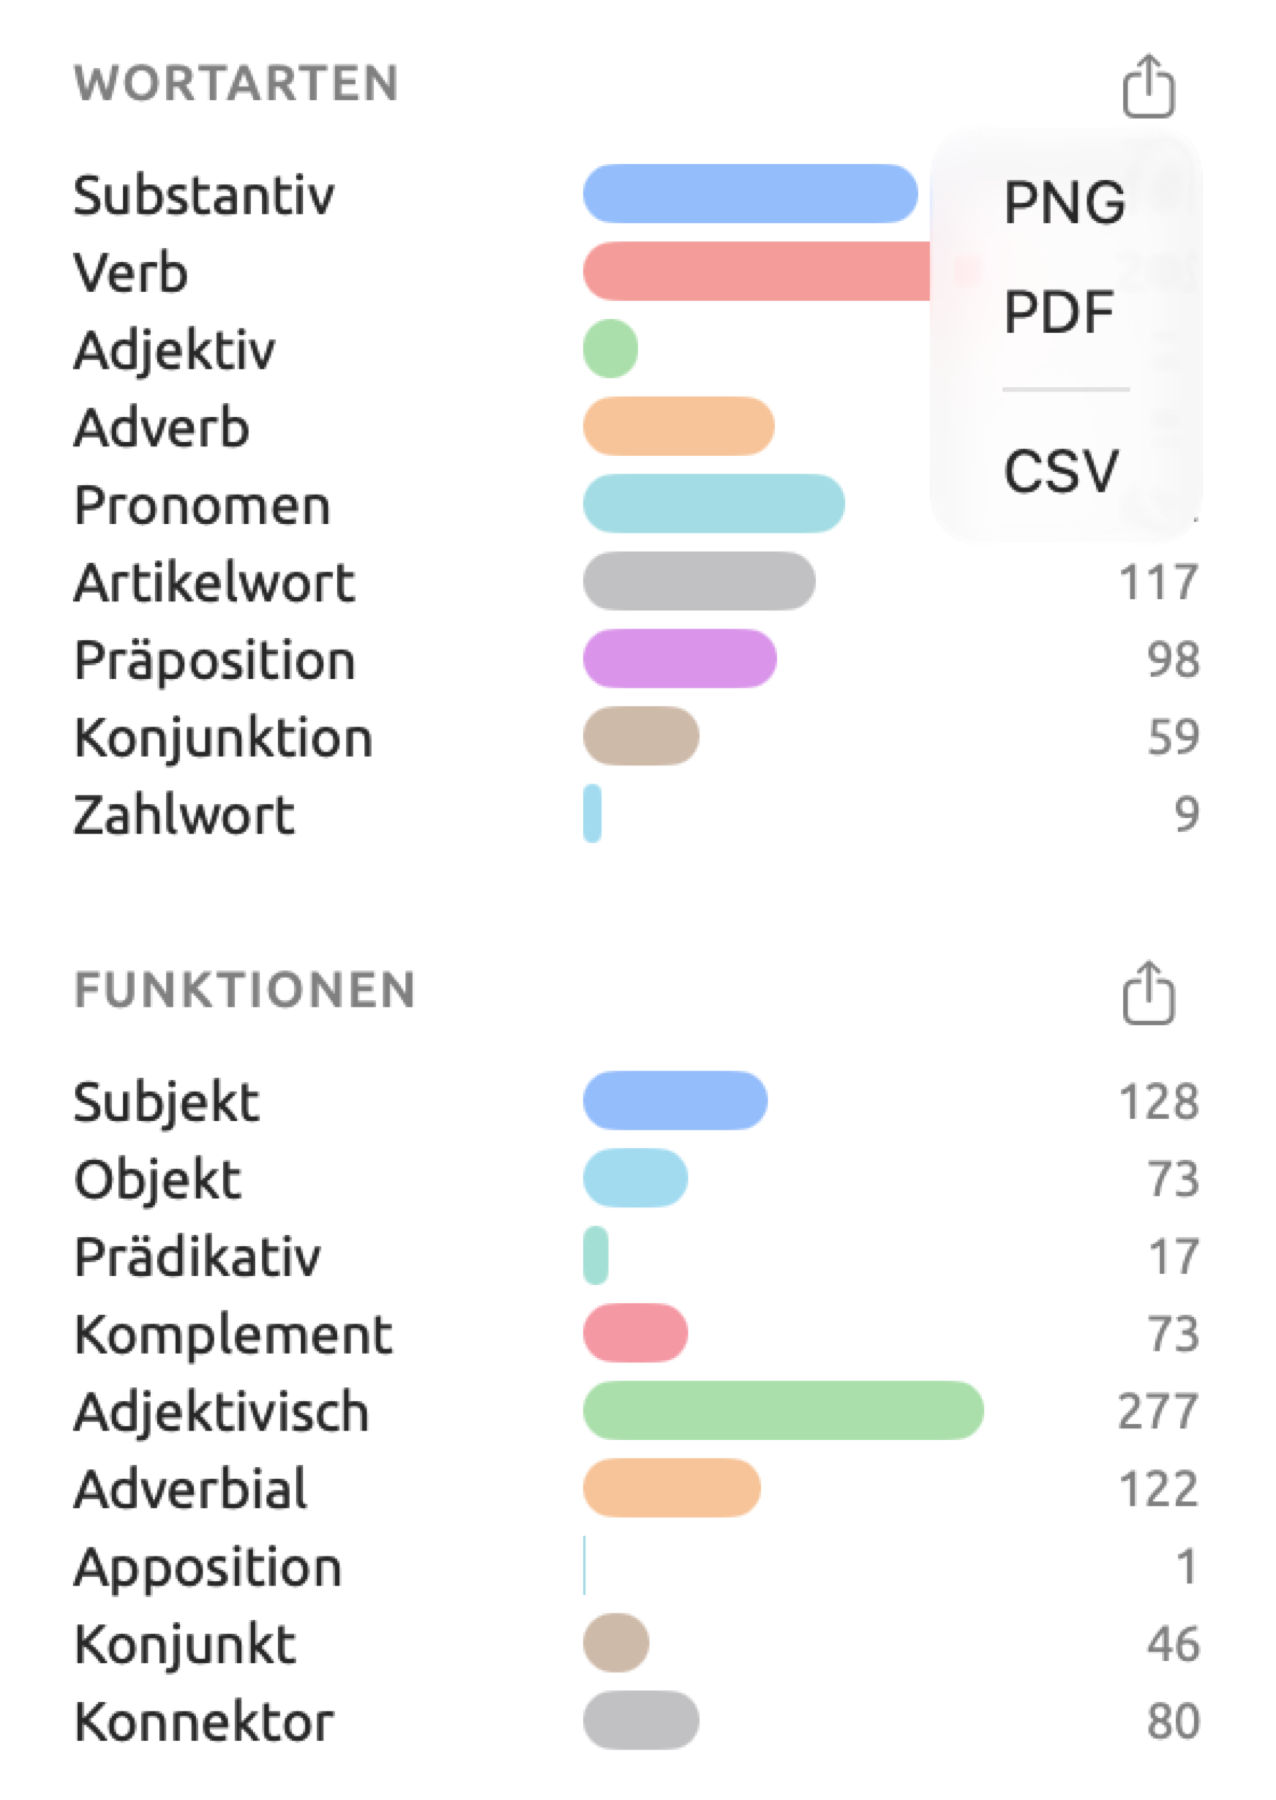
Im Beispielprojekt „Klimadebatte“ hat „Hitzebericht 2024“ einen deutlichen Schwerpunkt auf Substantiven und Präpositionen und verwendet im Vergleich zu den Meinungsbeiträgen oder „Radiodebatte“ sehr wenige Pronomen. Die Abbildung unten zeigt die Diagramme Wortarten und Funktionen des Dokuments „Uns läuft die Zeit davon“.
Um zu sehen, welche Wörter einen Balken bilden, aktivieren Sie die entsprechende Lens in der Leseansicht.
Die Facette Lesezeichen
Die Facette Lesezeichen zeigt die Lesezeichen des Dokuments in der Reihenfolge ihrer Position im Dokument. In „Klimadebatte“ hat „Uns läuft die Zeit davon“ zum Beispiel ein Lesezeichen im letzten Absatz, genauer bei der Frage Worauf warten wir eigentlich noch?, mit dem Kommentar „Rhetorische Frage am Übergang zum Schlussappell“. Die Überschrift zeigt, wie viele Lesezeichen das Dokument hat, in diesem Fall also Lesezeichen (1). Wie Sie Lesezeichen setzen, lesen Sie unter Lesezeichen in Kapitel 7, Kodieren.
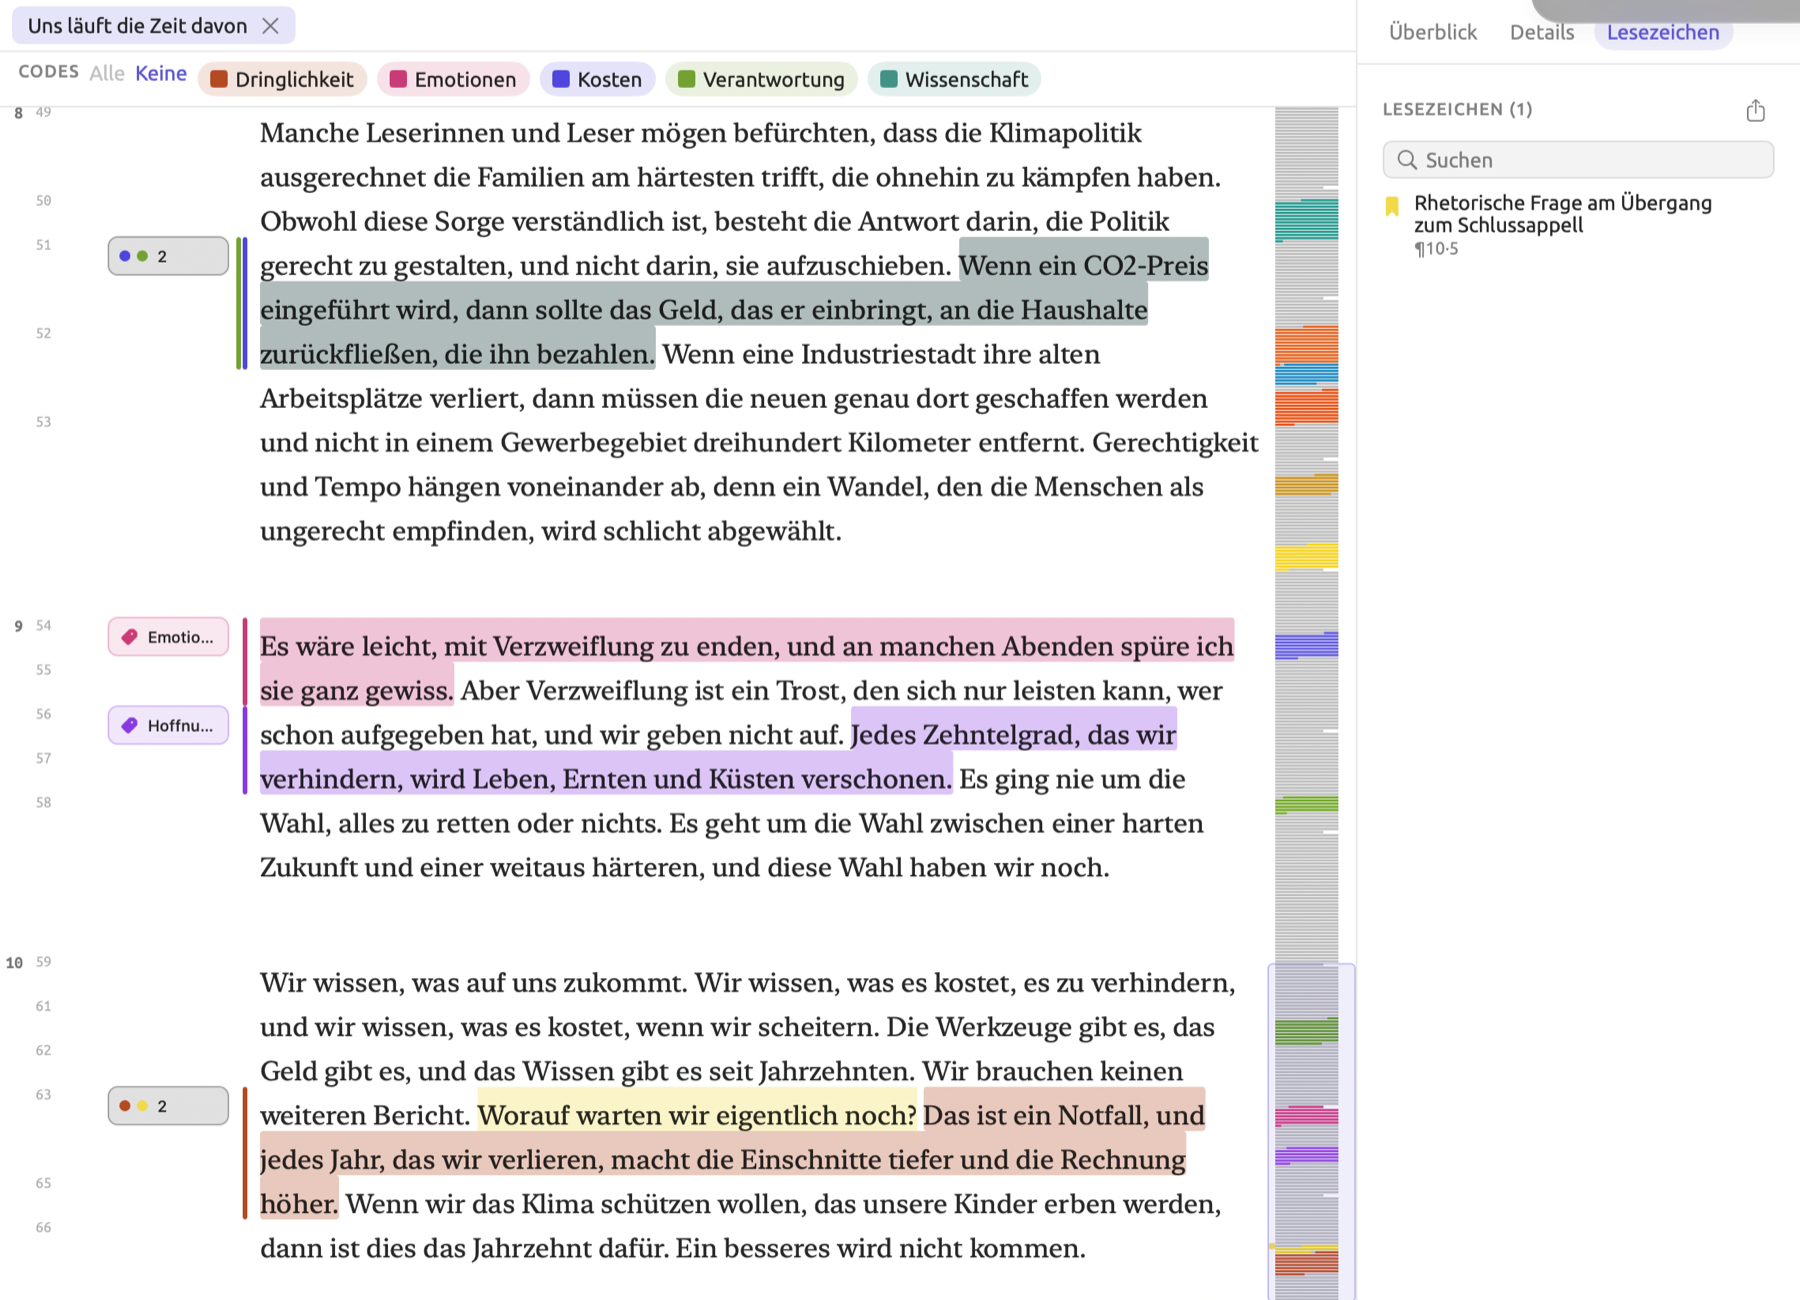
Jede Zeile zeigt:
- ein Lesezeichensymbol in der Farbe des Lesezeichens oder in Grau, wenn es Keine Farbe hat;
- den Kommentar des Lesezeichens oder, wenn es keinen gibt, den markierten Text selbst, höchstens drei Zeilen lang;
- und die Stelle des Lesezeichens, etwa ¶10·5 für den fünften Satz des zehnten Absatzes. Wenn Sie den Mauszeiger auf die Stelle halten, erscheint sie ausgeschrieben, etwa Absatz 10, Satz 5.
Klicken Sie auf eine Zeile, um zum Lesezeichen zu springen. Zeigt die Leseansicht nur annotierte Sätze und gehört das gewählte Lesezeichen nicht dazu, wird zuerst wieder das ganze Dokument angezeigt, bevor die Ansicht zum Lesezeichen springt.
Über der Liste steht das Feld Suchen. Was Sie hier eingeben, beschränkt die Liste auf die Lesezeichen, deren Kommentar oder Text die Eingabe enthält; Groß- und Kleinschreibung spielen dabei keine Rolle. Die Zahl in der Überschrift zählt aber weiterhin alle Lesezeichen.
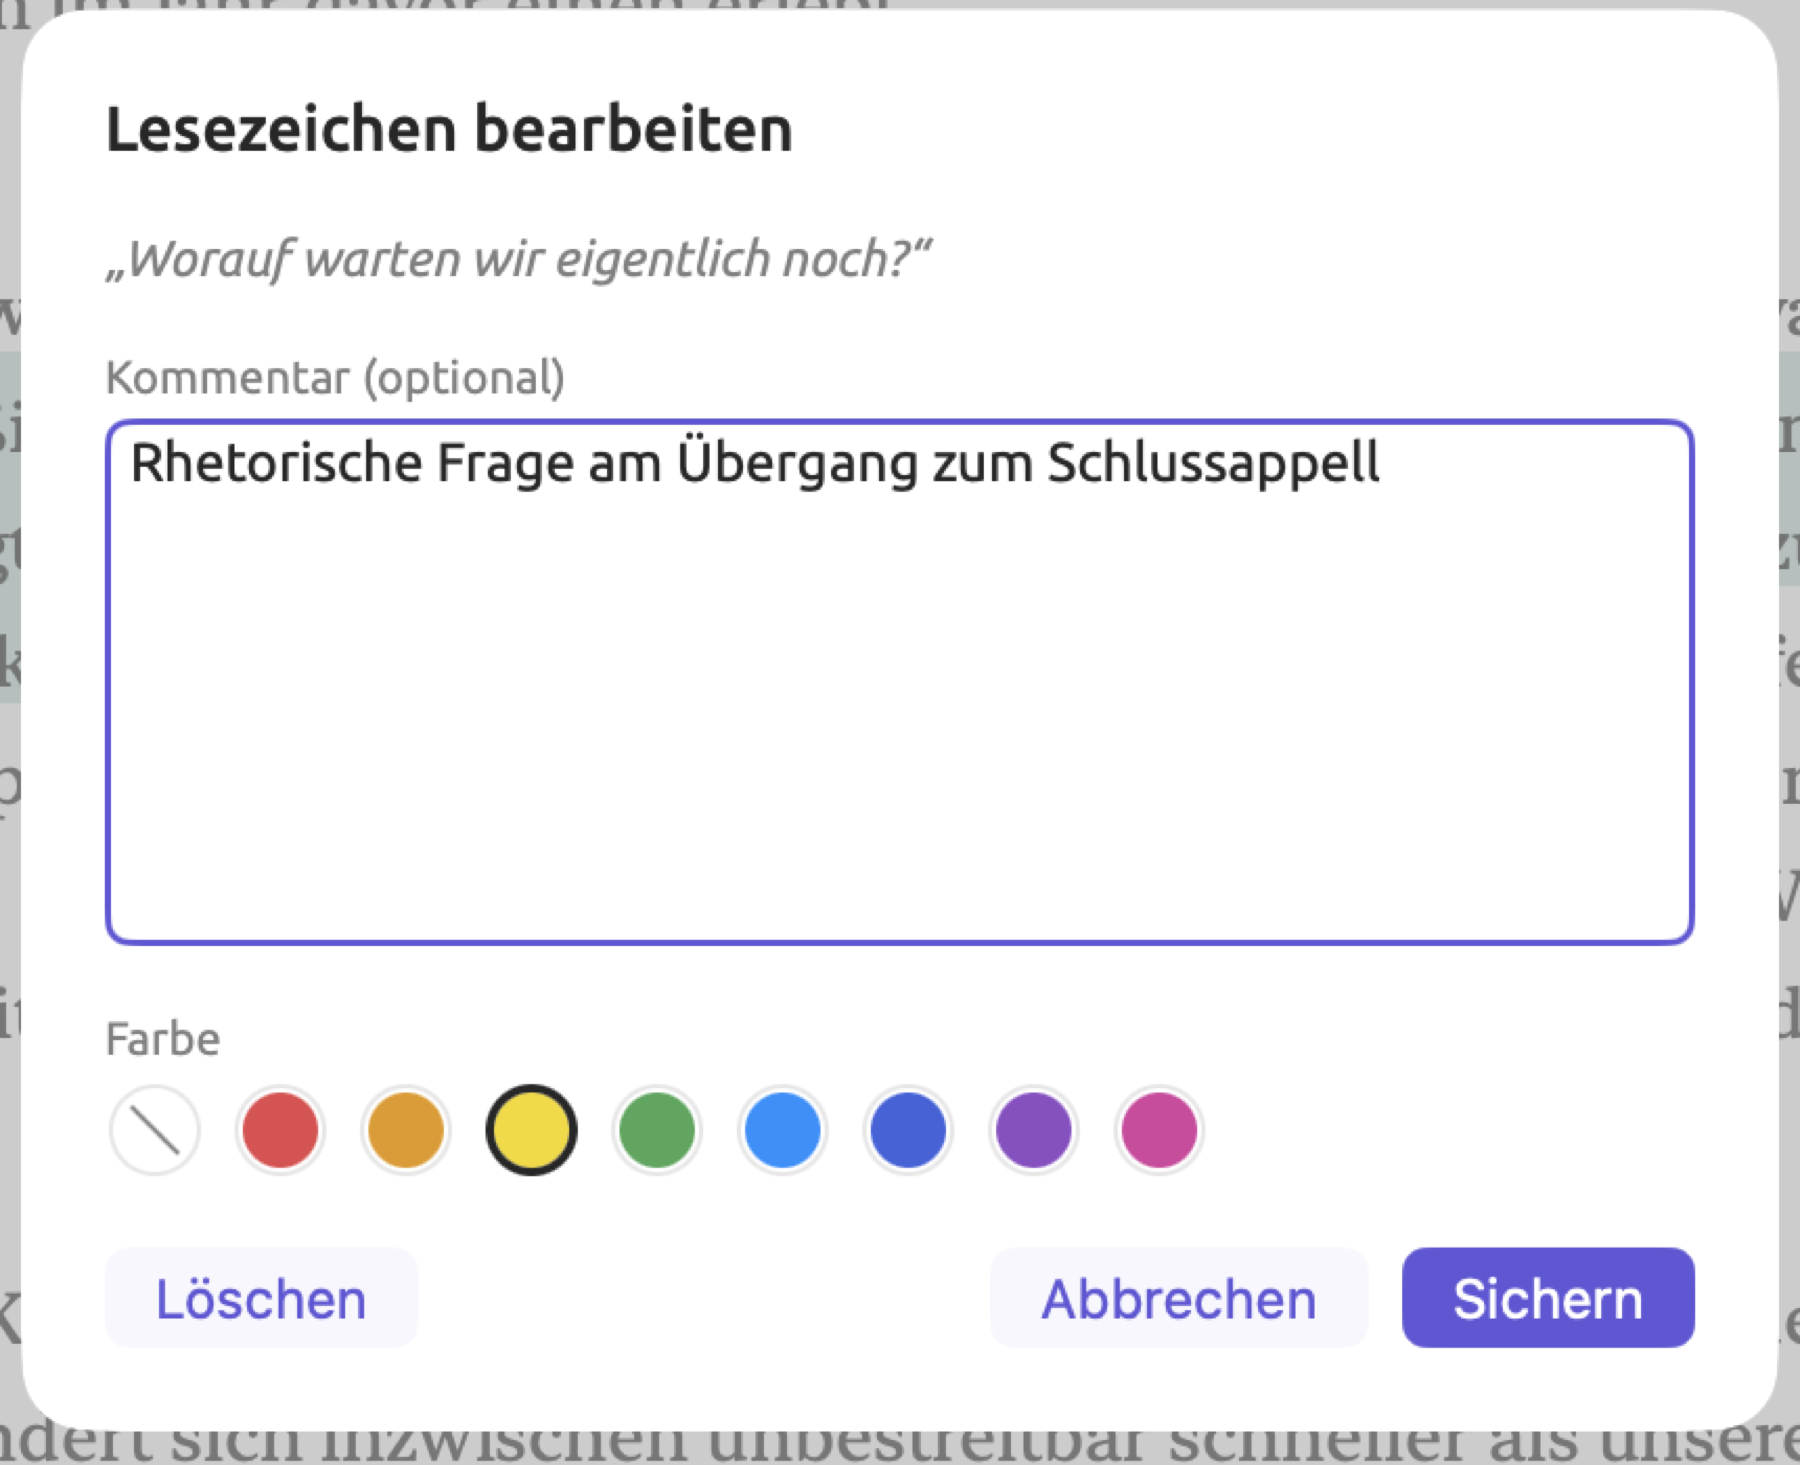
So ändern Sie Kommentar oder Farbe eines Lesezeichens:
- Klicken Sie mit der rechten Maustaste auf seine Zeile und wählen Sie Bearbeiten.
- Ändern Sie im Dialog Lesezeichen bearbeiten, der die markierte Textstelle zeigt, Kommentar (optional) oder Farbe.
- Klicken Sie auf Sichern.
Um ein Lesezeichen zu entfernen, klicken Sie mit der rechten Maustaste auf seine Zeile und wählen Löschen. Alternativ klicken Sie unten im Dialog Lesezeichen bearbeiten auf Löschen. Änderungen wirken sofort; mit Bearbeiten ▸ Lesezeichen entfernen widerrufen (⌘Z) stellen Sie ein gelöschtes Lesezeichen wieder her. Bearbeiten ▸ Lesezeichen bearbeiten widerrufen (⌘Z) macht eine Änderung an einem Lesezeichen rückgängig.
Hat ein Dokument Übersetzungen, erscheint jedes seiner Lesezeichen auch in jeder Übersetzung. Es ist dort jeweils mit der entsprechenden Textstelle verknüpft; Änderungen und Löschungen gelten für alle Fassungen. Lesezeichen, die Sie aus den Treffern einer Abfrage erzeugen (Treffer mit Lesezeichen versehen …), erscheinen hier wie gewöhnliche Lesezeichen (siehe Treffer mit Lesezeichen versehen in Kapitel 18, Abfrageergebnisse nutzen).
Um Lesezeichen zu exportieren, klicken Sie auf die Exportschaltfläche rechts neben der Überschrift (Als CSV exportieren). Die exportierte Datei hat drei Spalten (Stelle, Text und Kommentar) und enthält alle gerade aufgeführten Lesezeichen; nach einer Suche sind das also nur die passenden. Als Dateiname wird der Titel des Dokuments vorgeschlagen, gefolgt von -bookmarks.