Statistik im Überblick
Dieser Anhang stellt die Kennzahlen zusammen, die LemmaLoom an verschiedenen Stellen zeigt, etwa die Lesbarkeitswerte im Tab Text des Inspektors oder den p-Wert, der sich aus dem Vergleich der Texte der Aktivisten mit denen der Skeptiker ergibt. Jede Tabelle verwendet die Bezeichnungen der App und verweist auf die Kapitel, in denen die jeweilige Kennzahl an Beispielen erklärt wird.
Kurze Definitionen vieler dieser Kennzahlen finden Sie auch unter Hilfe ▸ Glossar in den Kategorien Textstatistik und Assoziationsmaße.
Wo die Zahlen erscheinen
| Ort | Zahlen | Erklärt in |
|---|---|---|
| Tab Text, Überblick | Zählungen, Lesbarkeit, Wortschatz, Satzbau und Struktur eines Dokuments | Kapitel 10, Der Text-Inspektor |
| Tab Grammatik, Kollokationen | Vier Assoziationsmaße; der CSV-Export ergänzt drei weitere und die erwartete Häufigkeit | Kapitel 11, Der Grammatik-Inspektor |
| Tab Grammatik, Wortskizze; Tab Kodierung, Code-Skizze; Ansicht und Fenster Wortskizze | f (Häufigkeit) und logDice für jeden Partner | Kapitel 12, Wortskizze |
| Tab Multimodus, Skizzenraum; der Modus Multimodus der Wortskizze | Anzahlen und Anteile der Verbindungen, das * und logDice in der Liste | Kapitel 14, Skizzenraum |
| Tab Kodierung, Code-Statistik | Segmente und Abdeckung jedes Codes; φ und * für überlappende Codes | Kapitel 13, Codes auswerten |
| Codebuch und Code-Statistik im Regal | Segmente, Dokumente, Abdeckung | Kapitel 7, Kodieren; Kapitel 13, Codes auswerten |
| Code-Matrix im Regal | Anzahlen; mit Spalten gruppieren nach Anzahlen oder Prozentwerte und ein Test für jeden Code | Kapitel 13, Codes auswerten |
| Beziehungen im Regal | φ und * für jedes Codepaar sowie die Zahl der Überschneidungen | Kapitel 13, Codes auswerten |
| Anzahl, Vergleichen und Im Zeitverlauf in Abfragen | Maße, Verbreitung, DP und Tests | Kapitel 16, Abfrageergebnisse und Statistik |
| Kollokationen und Schlüsselwörter in Abfragen | Sieben Assoziationsmaße; Log-Likelihood und Log-Ratio | Kapitel 16, Abfrageergebnisse und Statistik |
| Abfragen, sortiert nach Wert | Der Wert jeder Textstelle | Kapitel 17, Abfragemuster und Erkundung |
| Netzwerk in Abfragen | Anzahl der verknüpften Treffer für jedes Wertepaar | Kapitel 16, Abfrageergebnisse und Statistik |
| Form × Funktion, Diskurs, Kategorie-Häufigkeiten im Bereich Wörterbücher, Attribut-Aufschlüsselungen in Code-Statistik | Einfache Anzahlen | Kapitel 11, Der Grammatik-Inspektor; Kapitel 19, Wörterbücher; Kapitel 13, Codes auswerten |
Eine kurze Einführung
Diese Einführung setzt nicht mehr als Schulmathematik voraus. Die Beispiele dieser Einführung beziehen sich auf das Projekt „Klimadebatte“, das LemmaLoom als Beispielprojekt mitbringt. Das Beispiel zur Code-Matrix verwendet die tatsächlichen Kodierungen des Beispielprojekts; Sie können sie nachprüfen, indem Sie das Projekt über Ablage ▸ Importieren ▸ Beispielprojekt importieren. Die übrigen Zahlen sind erfunden, aber in sich stimmig und so gewählt, dass die Rechnung einfach bleibt.
Häufigkeiten, Anteile und Raten
Eine Häufigkeit gibt an, wie oft etwas vorkommt. Sie könnten zum Beispiel 20 Heckenausdrücke in „Radiodebatte“ zählen oder 6 Kodierungen mit „Dringlichkeit“ im Set „Aktivisten“. Alle Zahlen in LemmaLoom gehen direkt oder indirekt auf eine Häufigkeit zurück. Für sich genommen lassen sich Häufigkeiten jedoch schlecht vergleichen, denn ein längeres Dokument bietet Raum für größere Zahlen.
Ein Anteil dagegen setzt einen Teil ins Verhältnis zu dem Ganzen, in dem er enthalten ist. Anteile liegen zwischen 0 und 1 und werden meist als Prozentwerte angegeben. Zu den Anteilen in LemmaLoom gehören die Abdeckung, die Lexikalische Dichte, das Maß Anteil in Abfragen und die Prozentwerte einer Code-Matrix. Angenommen, die Kodierungen mit „Kosten“ umfassen 250 der 5.000 Zeichen von „Uns läuft die Zeit davon“. Die Abdeckung von „Kosten“ beträgt dann , also 5,0 %.
Eine Rate ist wie ein Anteil ein Verhältnis, doch ihr Nenner ist die Länge des Textes. Damit sie gut lesbar ist, wird sie hochskaliert:
Dabei ist die Häufigkeit und die Zahl der Wörter. Die Division ergibt Treffer pro Wort, eine sehr kleine Zahl. Mit 10.000 multipliziert wird daraus die Zahl der Treffer pro 10.000 Wörter, genau die Skala des Maßes Pro 10.000 Wörter in Abfragen.
Nehmen Sie als Beispiel „Radiodebatte“ mit 800 Wörtern und 20 Heckenausdrücken und „Keine Panik“ mit 600 Wörtern und 18 Heckenausdrücken. Das ergibt:
Das erste Dokument enthält mehr Heckenausdrücke, das zweite weniger, hat aber die höhere Rate. Die Partikeldichte berechnet Raten pro 100 Wörter, ebenso wie mehrere der Lesbarkeitsformeln. Pro 100 Wörter betragen die beiden Raten 2,5 und 3,0. Die Reihenfolge ändert sich also nicht.
Für eine ganze Gruppe von Dokumenten können Sie entweder eine gepoolte Rate oder Raten für jedes einzelne Dokument berechnen. Eine gepoolte Rate teilt die Gesamtzahl der Vorkommen durch die Gesamtzahl der Wörter. Lange Meinungsbeiträge haben dabei mehr Gewicht als kürzere Artikel. Die Zeilen einer Abfrage zeigen solche Raten. Bei der anderen Methode erhält jedes Dokument eine eigene Rate, und die Raten werden in eine Rangfolge gebracht. So arbeitet der Rangtest unter Vergleichen (siehe Tests weiter unten in diesem Kapitel).
Logarithmen
Der Logarithmus gibt den Exponenten an, mit dem eine Zahl, die Basis, potenziert werden muss, um eine andere Zahl zu erhalten. LemmaLoom verwendet drei Basen:
- Der Logarithmus zur Basis 10 von 1.000 ist 3 (), weil .
- Der Logarithmus zur Basis 2 (abgekürzt ) gibt die Zahl der Verdopplungen an; daher ist , denn .
- Der natürliche Logarithmus, abgekürzt , hat als Basis die Zahl , die mit 2,718 beginnt. Auf dem Taschenrechner ist das die Taste ln.
Unabhängig von der Basis ist der Logarithmus von 1 immer 0. Ein Wert über 1 hat einen positiven Logarithmus, ein Wert zwischen 0 und 1 einen negativen. Null und negative Zahlen haben keinen Logarithmus. Deshalb addieren manche Formeln 0,5 zur Häufigkeit oder lassen Nullen weg.
Beim Vergleich von Verhältnissen sind Logarithmen nützlich. „Viermal so oft“ und „ein Viertel so oft“ liegen gleich weit von „gleich oft“ entfernt. Auf einer linearen Skala beträgt der Abstand zwischen 4 und 1 aber 3 Punkte, der zwischen 1 und 0,25 dagegen weniger als einen Punkt. Logarithmen zur Basis 2 ergeben 2 und −2, die gleich weit von 0 entfernt liegen:
| Verhältnis | 1/8 | 1/4 | 1/2 | 1 | 2 | 4 | 8 |
|---|---|---|---|---|---|---|---|
| −3 | −2 | −1 | 0 | 1 | 2 | 3 |
Log-Ratio, MI und logDice verwenden den Logarithmus zur Basis 2 (), weil eine Einheit auf diesen Skalen doppelt oder halb so viel bedeutet. Die Log-Likelihood verwendet . Ob eine Log-Likelihood eine Grenze erreicht, lesen Sie an den Chi-Quadrat-Werten ab, die zu den Schwellen des p-Werts gehören (siehe p-Werte weiter unten).
Hat Ihr Taschenrechner keine Taste für , berechnen Sie mit der Taste ln den natürlichen Logarithmus und teilen das Ergebnis durch (). Da zum Beispiel und , ist , also etwas mehr als eine Verdopplung.
Erwartete Häufigkeiten
Viele Statistiken vergleichen, was Sie gefunden haben, mit dem, was Sie finden würden, wenn nichts die Gruppen voneinander unterschiede. Diesen zweiten Wert nennt man die erwartete Häufigkeit.
Angenommen, die Texte der Aktivisten umfassen zusammen 4.000 Wörter und die der Skeptiker 3.000, und das Wort Hoffnung kommt in den Texten der Aktivisten 12-mal vor, in denen der Skeptiker zweimal. In Tabellenform sieht das so aus:
| Hoffnung | Andere Wörter | Wörter | |
|---|---|---|---|
| Aktivisten | 12 | 3.988 | 4.000 |
| Skeptiker | 2 | 2.998 | 3.000 |
| Summe | 14 | 6.986 | 7.000 |
Verwenden beide Gruppen Hoffnung mit derselben Rate, sollten sich die 14 Vorkommen im Verhältnis der Wortzahlen verteilen. Die Dokumente der Aktivisten enthalten vier Siebtel aller Wörter, also sind bei ihnen 14 × 4/7 = 8 Vorkommen von Hoffnung zu erwarten, bei den Skeptikern 6. Allgemein erhalten Sie die erwartete Häufigkeit einer Zelle, indem Sie ihre Zeilensumme mit ihrer Spaltensumme multiplizieren und das Ergebnis durch die Gesamtsumme teilen:
Für Hoffnung bei den Aktivisten ist . Die Aktivisten haben 12 Vorkommen, 4 mehr als erwartet, die Skeptiker nur 2, also 4 weniger als erwartet. Eine erwartete Häufigkeit ist ein Durchschnitt und muss deshalb keine ganze Zahl sein.
Die Chi-Quadrat-Statistik χ² summiert die quadrierten Differenzen zwischen der Häufigkeit jeder Zelle und ihrer erwarteten Häufigkeit , jeweils geteilt durch :
Dabei ist die beobachtete Häufigkeit einer Zelle, ihre erwartete Häufigkeit, und das Zeichen bedeutet „über alle Zellen aufsummieren“. Durch das Quadrieren tragen Abweichungen in beide Richtungen positiv zum Ergebnis bei. Weil durch die erwartete Häufigkeit geteilt wird, zählt eine Differenz in kleinen Zellen mehr als in großen. Für die anderen Wörter sind 3.992 und 2.994 zu erwarten; beide weichen um 4 von den tatsächlichen Häufigkeiten ab. Damit ist
Schlüsselwörter, Kollokate, Chi-Quadrat-Tests, das * im Skizzenraum und das φ überlappender Codes gehen alle von erwarteten Häufigkeiten aus. Sie unterscheiden sich darin, wofür Zeilen und Spalten stehen. In Schlüsselwortlisten stehen die Zeilen für zwei Gruppen von Dokumenten, bei Kollokaten für die Wörter innerhalb und außerhalb der Fenster und bei überlappenden Codes für die Zeichen innerhalb und außerhalb jedes Codes.
p-Werte
Zwei Gruppen verwenden ein bestimmtes Wort fast immer mit etwas unterschiedlichen Raten, auch wenn nichts die eine Gruppe von der anderen unterscheidet. Ob eine solche Abweichung signifikant ist, lässt sich statistisch prüfen. Der p-Wert liegt zwischen 0 und 1 und gibt die Wahrscheinlichkeit für einen mindestens so großen Unterschied an, wenn sich die Gruppen in Wirklichkeit nicht unterschieden. Ist Ihr p-Wert niedrig, lässt sich die Abweichung kaum allein dem Zufall zuschreiben.
Die Log-Likelihood einer Schlüsselwortliste in den Abfragen von LemmaLoom (siehe Wie die beiden Werte berechnet werden in Kapitel 16, Abfrageergebnisse und Statistik) ist die doppelte Summe der Produkte aus jeder beobachteten Häufigkeit und dem natürlichen Logarithmus ihres Verhältnisses zur erwarteten Häufigkeit. Sie wird geschrieben; für Hoffnung sieht das so aus:
misst ungefähr dieselbe Abweichung von den erwarteten Häufigkeiten wie die Chi-Quadrat-Statistik. Rechenweg und Ergebnis unterscheiden sich nur wenig, wie der Vergleich von 5,34 mit den 4,68 von oben zeigt.
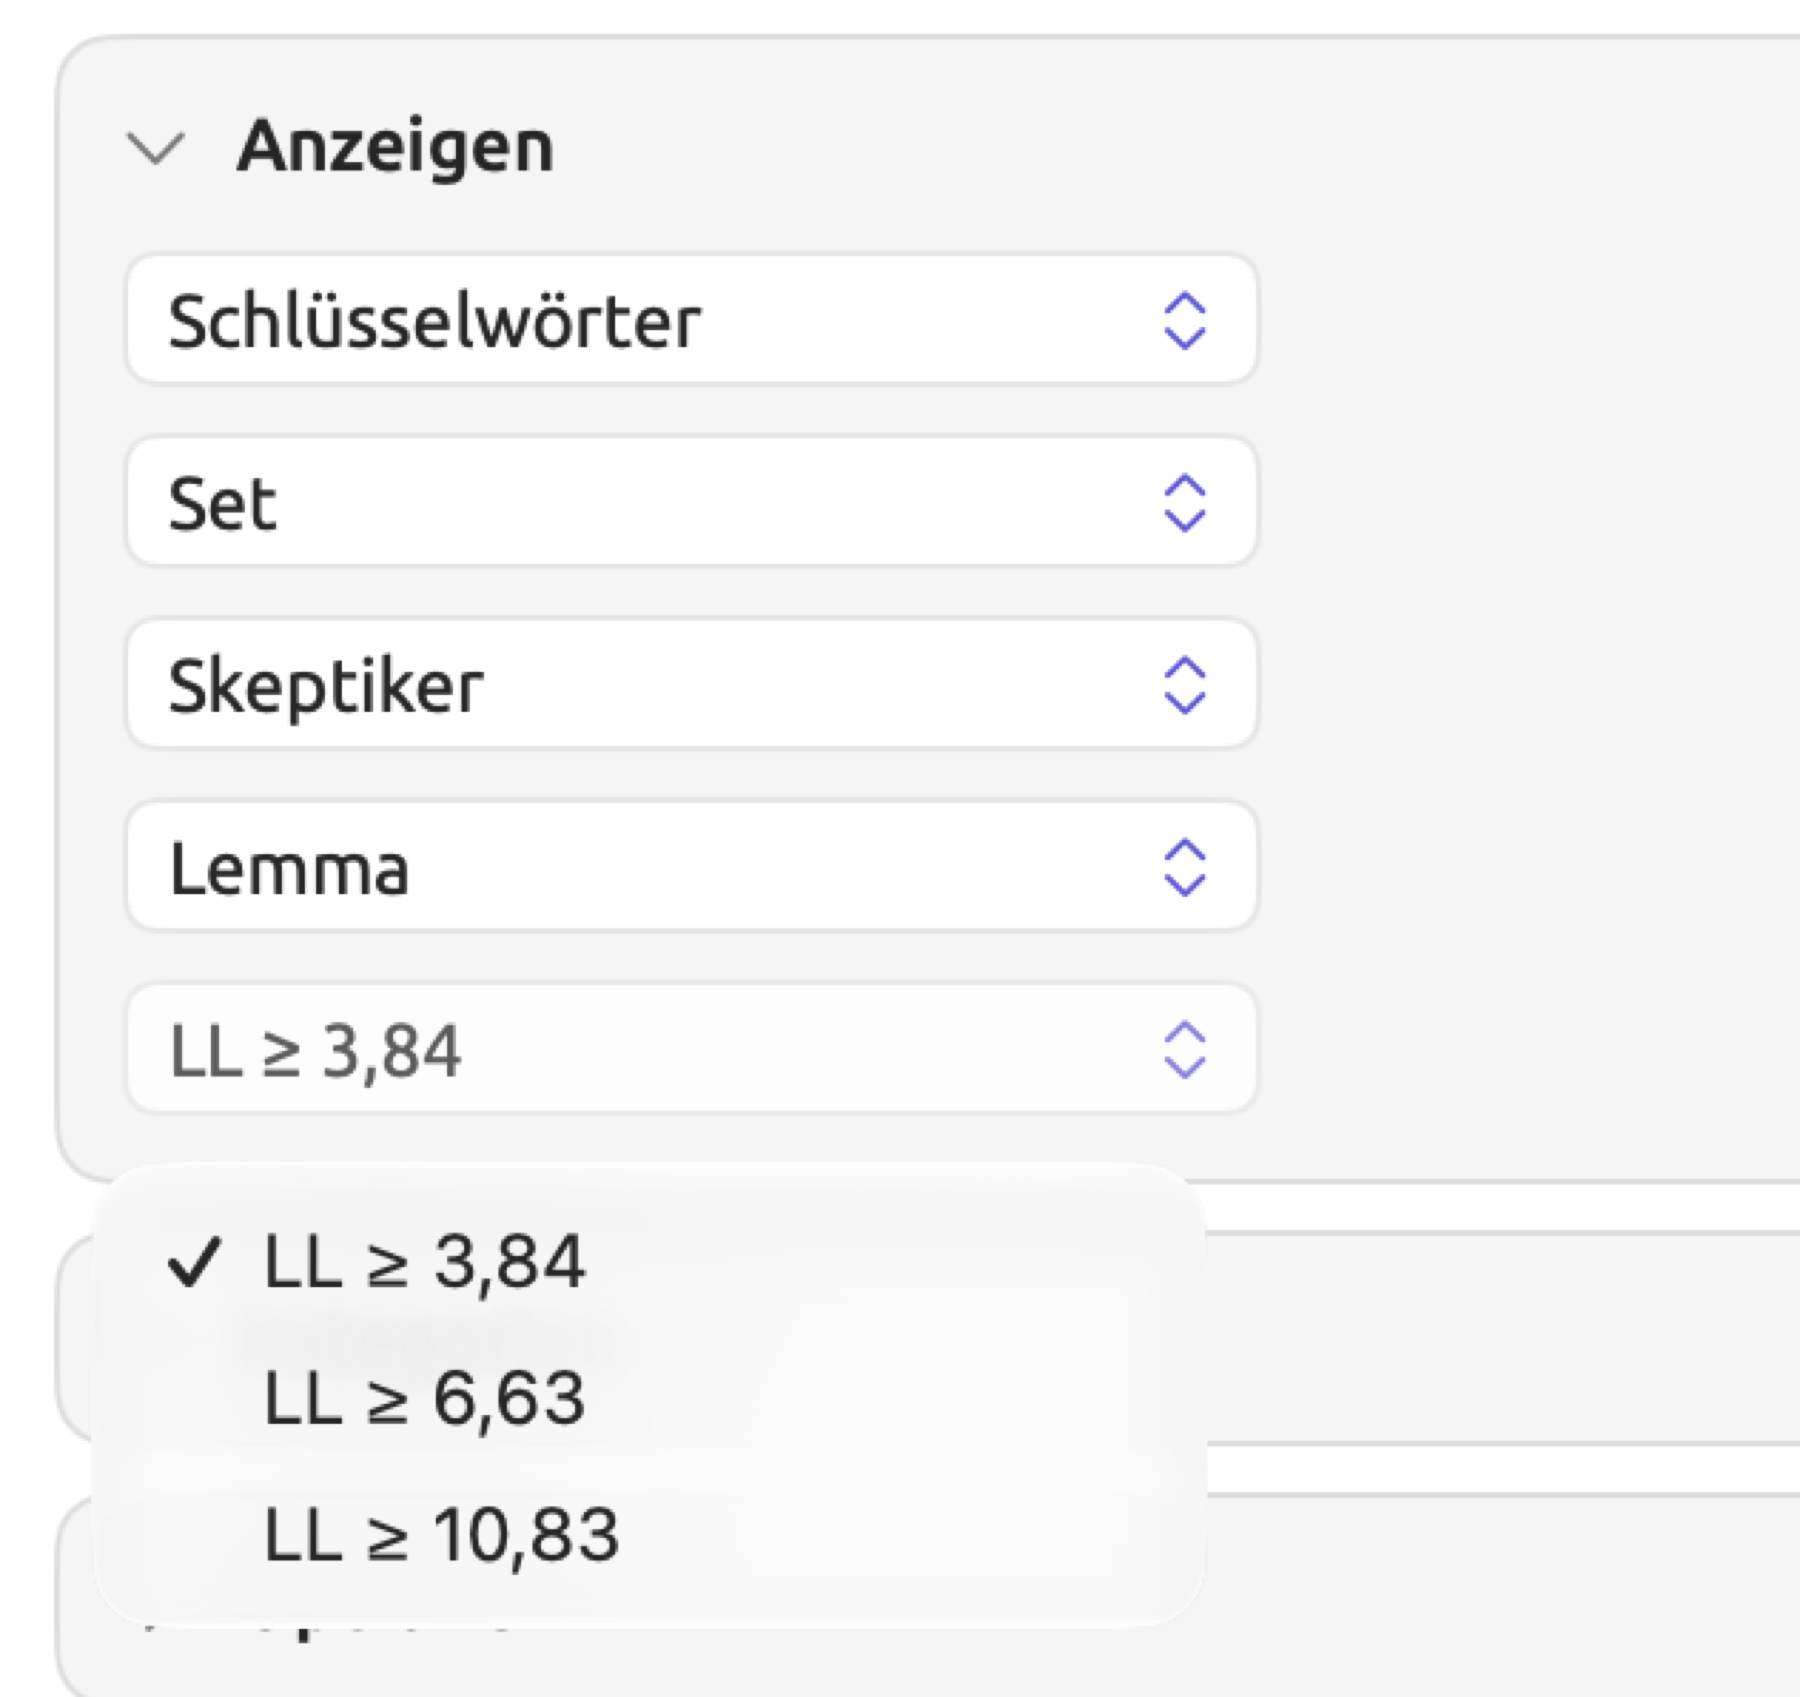
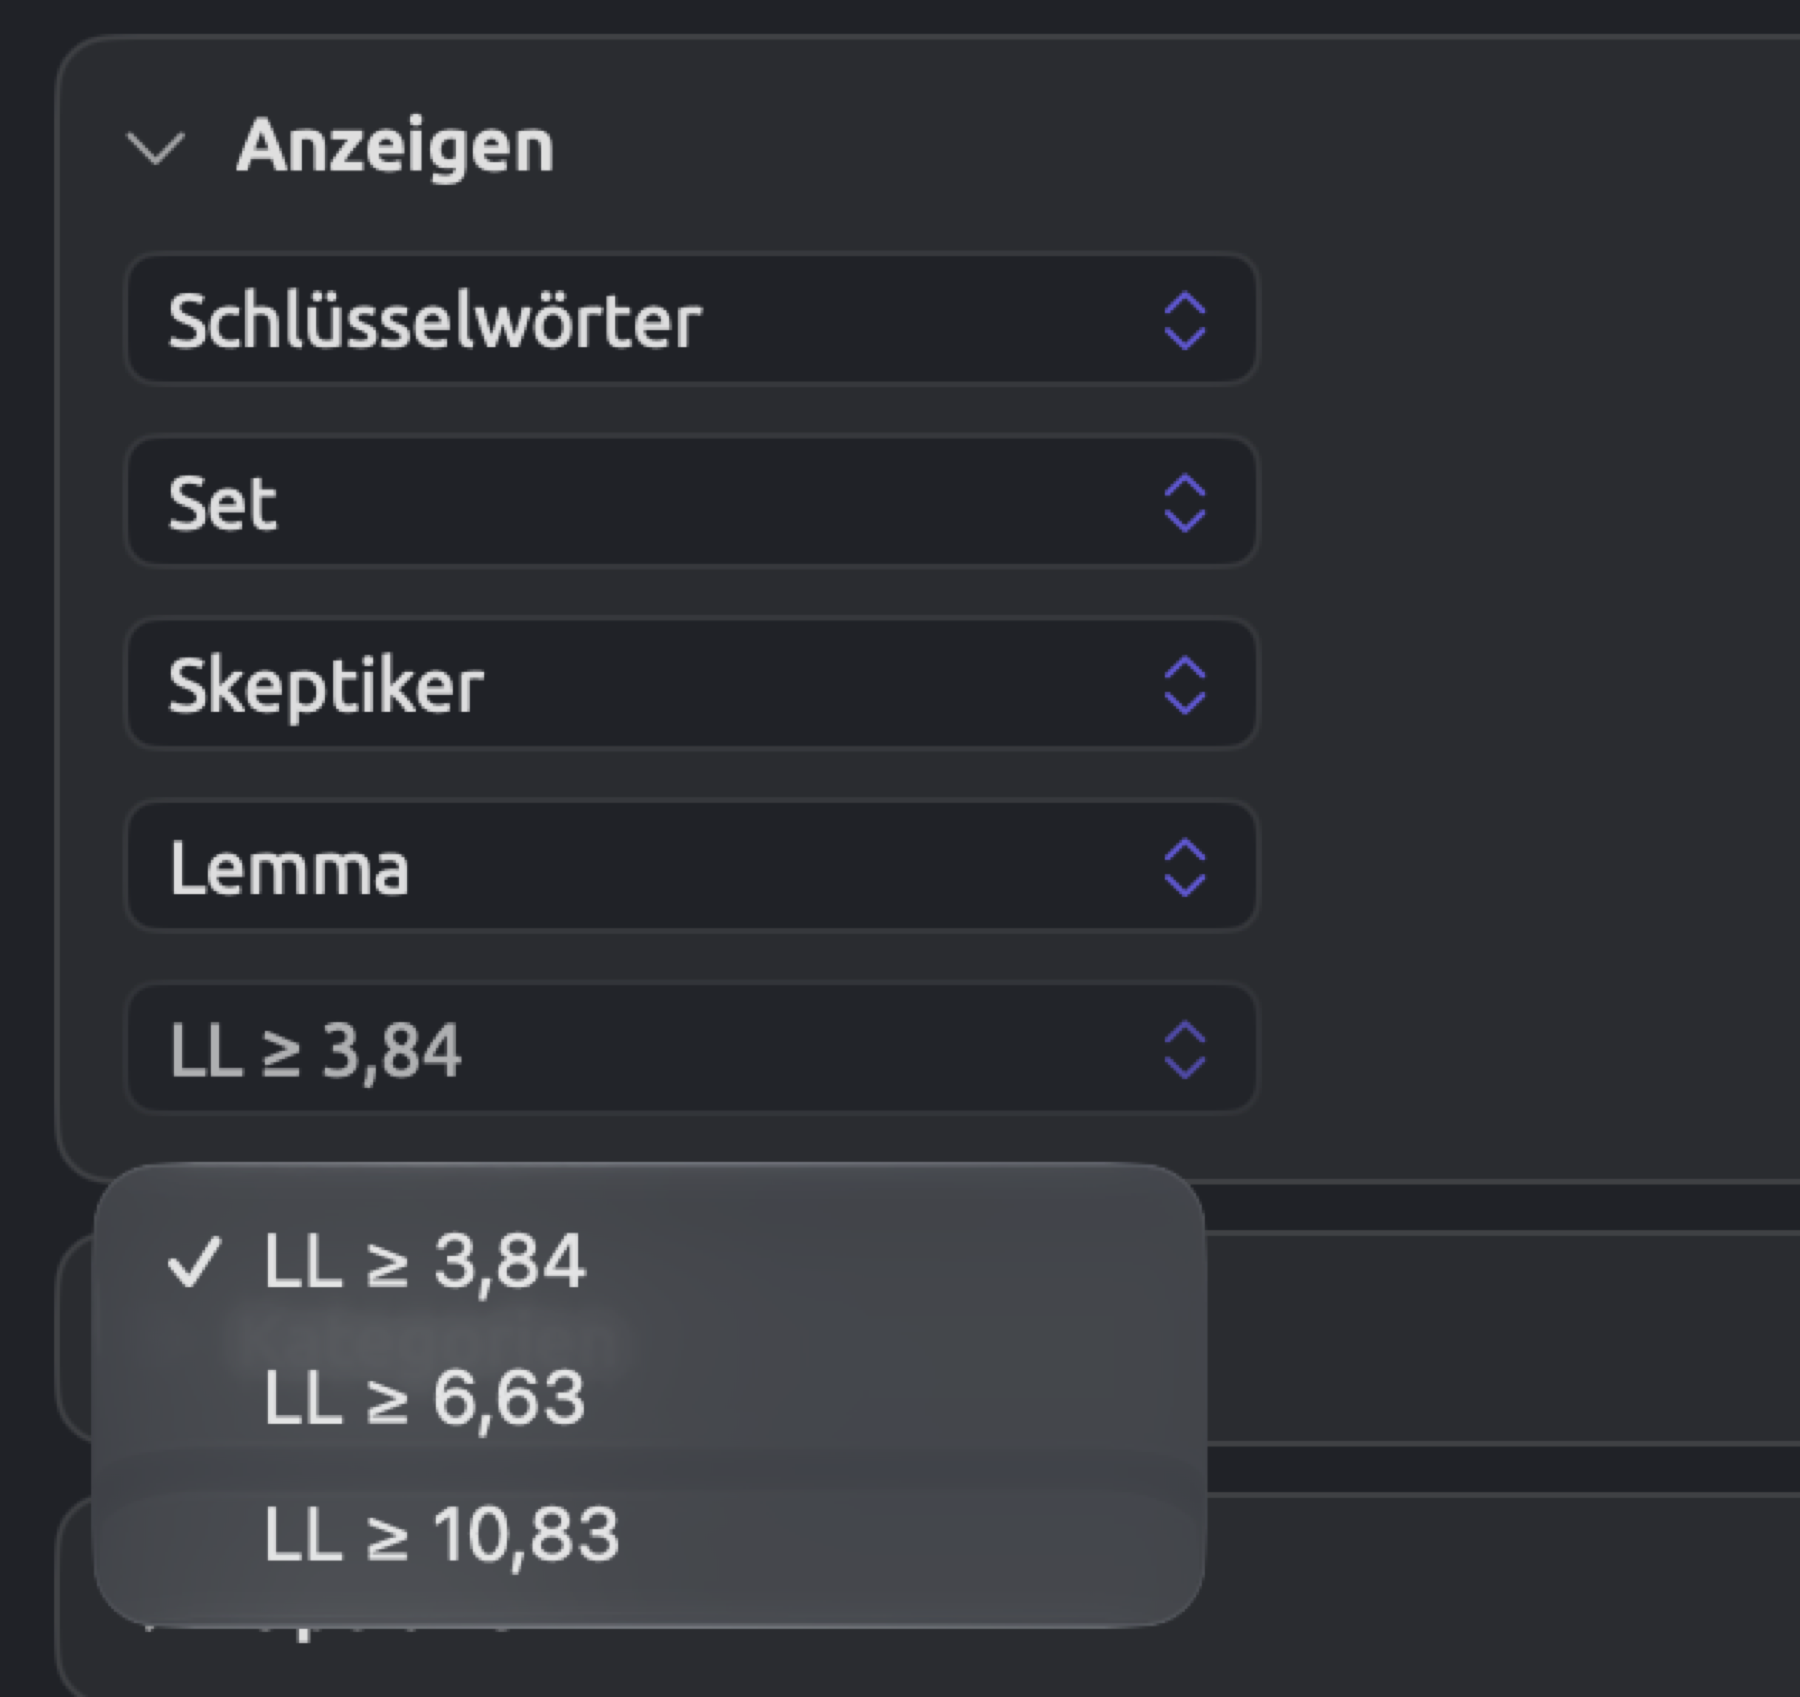
Bei einem beobachteten von 5,34 beträgt die Wahrscheinlichkeit, dass ein Unterschied dieser Größe oder ein größerer allein durch Zufall entsteht, etwa 0,021, sofern beide Gruppen Hoffnung mit derselben Rate verwenden. Unter 100 Fällen, in denen sich die Raten der beiden Gruppen nicht unterscheiden, wären also etwa zwei Fälle wie dieser zu erwarten. Hoffnung erreicht damit den Schwellenwert LL ≥ 3,84, nicht aber LL ≥ 6,63.
Als Grenzen für Signifikanz werden meist 0,05; 0,01 oder 0,001 gewählt, und ein p-Wert unter 0,05 gilt oft als statistisch signifikant. LemmaLoom verwendet überall, wo es Signifikanz anzeigt, die Grenze 0,05 (siehe Wie Signifikanz angezeigt wird weiter unten in diesem Kapitel).
Ein p-Wert von 0,021 bedeutet nicht, dass mit 98 % Wahrscheinlichkeit tatsächlich ein Unterschied besteht. Ein p-Wert sagt auch nichts über die Größe des Effekts; dafür dient die Effektstärke (siehe Effektstärken weiter unten). Ebenso wenig zeigt ein p-Wert über 0,05, dass sich die beiden Gruppen gleichen. Bei wenigen Dokumenten kann auch ein beträchtlicher Unterschied die statistische Signifikanz verfehlen.
Ein p-Wert setzt außerdem voraus, dass nur ein einziger Test durchgeführt wurde. Eine Schlüsselwortliste führt aber für jedes Wort einen durch. Werden zum Beispiel 1.000 Wörter getestet, die keinen echten Unterschied zeigen, erscheinen etwa 50 von ihnen (5 von 100) bei LL ≥ 3,84 rein zufällig als statistisch signifikant. Strengere Kriterien wie LL ≥ 6,63 lassen unter denselben Bedingungen nur etwa 10 Wörter durch, LL ≥ 10,83 etwa eines.
Die meisten Hypothesentests vergleichen den berechneten Wert mit einer Verteilung. Die Verteilung gibt für jeden Wert der Teststatistik an, wie wahrscheinlich genau dieses Ergebnis ist, wenn sich die Gruppen nicht unterscheiden; der p-Wert entspricht dem Teil der Verteilung jenseits des berechneten Werts. Der Rangtest für zwei Gruppen verwendet die Normalverteilung. Der Rangtest für mehr Gruppen, die Chi-Quadrat-Tests und die Schwellenwerte für Schlüsselwörter verwenden die Chi-Quadrat-Verteilung.
Anders als die übrigen Tests berechnet der exakte Fisher-Test den p-Wert genau, statt ihn näherungsweise zu schätzen. Er berücksichtigt alle Anordnungen der Zellen, die dieselben Randsummen haben, und addiert die Wahrscheinlichkeiten aller Ergebnisse, die nicht wahrscheinlicher sind als das beobachtete. Deshalb bleibt er auch dort zuverlässig, wo die Chi-Quadrat-Verteilung bekanntermaßen schlecht passt, nämlich bei relativ kleinen erwarteten Häufigkeiten (nach einer verbreiteten Faustregel unter etwa 5).
Ein zweiseitiger Test berücksichtigt Abweichungen von der Erwartung in beide Richtungen, ein einseitiger nur in eine. Vergleichen in Abfragen und die Code-Matrix verwenden den zweiseitigen exakten Fisher-Test. Der Skizzenraum und der Modus Multimodus der Wortskizze verwenden dagegen einseitige Tests, die nur nach mehr Verbindungen als erwartet suchen.
Die genaue Form einer Chi-Quadrat-Verteilung hängt von ihren Freiheitsgraden (df) ab. Eine Tabelle mit Zeilen und Spalten hat Freiheitsgrade, denn wenn die Zeilen- und Spaltensummen feststehen, können nur so viele Zellen frei variieren. Ein Rangtest mit Gruppen hat . Diese Mindestwerte muss eine Statistik für die einzelnen Grenzen erreichen:
| df | p = 0,05 | p = 0,01 | p = 0,001 |
|---|---|---|---|
| 1 | 3,84 | 6,63 | 10,83 |
| 2 | 5,99 | 9,21 | 13,82 |
| 3 | 7,81 | 11,34 | 16,27 |
| 4 | 9,49 | 13,28 | 18,47 |
Die erste Zeile enthält die drei Werte des Menüs, das in Schlüsselwortlisten LL ≥ 3,84 zeigt. Dieselben drei Werte sind auch die üblichen Grenzen, wenn Sie die Log-Likelihood eines Kollokats beurteilen.
Effektstärken
In einem p-Wert verbinden sich die Größe eines Unterschieds und die Menge der Belege dafür. Eine Effektstärke misst nur die Größe des Unterschieds, unabhängig von der Zahl der Dokumente.
Nehmen Sie die Code-Matrix von „Klimadebatte“ mit nach Gruppe gruppierten Spalten; das ergibt die beiden Gruppen „Print“ und „Online“. Der erste Umschalter, der festlegt, was jede Zelle zählt, steht auf Dokumente (siehe Die Spalten gruppieren in Kapitel 13, Codes auswerten). Sechs Dokumente gehören zu „Print“ und sechs zu „Online“. „Hitzebericht 2024“ und „Streit um die CO2-Steuer“ bilden die Spalte Nicht gruppiert, die der Test auslässt. Zwei der Print-Dokumente („Uns läuft die Zeit davon“ und „Netto-Null wird teuer“) und alle sechs Online-Dokumente enthalten eine Kodierung mit „Fristen“:
| Mit „Fristen“ | Ohne | Dokumente | |
|---|---|---|---|
| 2 | 4 | 6 | |
| Online | 6 | 0 | 6 |
| Summe | 8 | 4 | 12 |
Die erwartete Häufigkeit der ersten Zelle beträgt , die der übrigen Zellen 2, 4 und 2. Jede beobachtete Häufigkeit weicht um 2 von ihrer erwarteten ab, und ; das ergibt ein χ² von
Dieser Wert liegt über dem kritischen Wert von 3,84 für das Signifikanzniveau 0,05. Da es nur zwei Gruppen gibt, verwendet die Code-Matrix jedoch stattdessen den exakten Fisher-Test, der mit sehr kleinen erwarteten Häufigkeiten zurechtkommt. Er ergibt . Die Effektstärke beträgt , wobei für die Stichprobe von 12 Dokumenten steht. φ erscheint in der Spalte Cramérs V.
Stellen Sie sich nun vor, Sie wiederholen Ihre Studie mit zehnmal so vielen Fällen und denselben Anteilen. Sie beobachten dann 20 von 60 Print-Dokumenten und 60 von 60 Online-Dokumenten. Die Chi-Quadrat-Statistik wird dadurch zehnmal so groß, nämlich 60,0, und p fällt unter 0,001. φ bleibt dagegen bei 0,71, weil sich die Anteile nicht geändert haben.
| Effektstärke | Angegeben bei | Formel | Werte | Grobe Einordnung |
|---|---|---|---|---|
| r | Rangtest für zwei Gruppen | 0 bis unter 1 (siehe Kleine Gruppen weiter unten) | 0,1 klein, 0,3 mittel, 0,5 groß | |
| ε² | Rangtest für drei oder mehr Gruppen | 0 bis 1 | Auf einer quadrierten Skala 0,01 klein, 0,09 mittel, 0,25 groß | |
| φ | Exakter Fisher-Test in Vergleichen; überlappende Codes in der Facette Code-Statistik und in Beziehungen | 0 bis 1 | 0,1 klein, 0,3 mittel, 0,5 groß | |
| Cramérs V | Chi-Quadrat-Tests in Vergleichen, deren Testzeile es als V zeigt; die Code-Matrix | 0 bis 1 | Wie φ bei Tabellen mit zwei Spalten; in größeren Tabellen gelten schon kleinere Werte als groß | |
| Log-Ratio | Schlüsselwörter | Siehe Werte für Schlüsselwörter und Profile weiter unten | Ohne Grenze; 0 bedeutet keinen Unterschied | 1 heißt doppelt so oft, −1 halb so oft |
ist die Gesamtzahl der Beobachtungen, die der jeweilige Test zählt. In den Rangtests, im Präsenztest und in der Code-Matrix sind das Dokumente, bei Chi-Quadrat auf Häufigkeiten Wörter und bei einer Tabelle unter Vergleichen die Treffer in ihren Zellen. Beim Test auf signifikante Überschneidungen zwischen Codes sind es Zeichen. und χ² sind die Werte der Teststatistiken. ist die Zahl der Zeilen oder die Zahl der Spalten, je nachdem, welche kleiner ist. misst, wie weit U von dem Wert entfernt liegt, den der Zufall ergäbe, , und zwar in Standardabweichungen, dem typischen Abstand von U zu diesem Wert:
und sind die Dokumentzahlen der beiden Gruppen, und ist ohne Vorzeichen.
Ränge
Manche Tests beruhen auf Rangfolgen. Jeder Wert erhält dabei einen Rang nach seiner Position in der Reihenfolge. Vier Dokumente mit den Raten 22, 30, 30 und 41 erhalten die Ränge 1; 2,5; 2,5 und 4. Die beiden Raten 30 würden die Ränge 2 und 3 belegen und teilen sich deshalb deren Durchschnitt .
Ränge berücksichtigen nicht, wie weit die Werte auseinanderliegen. Steigt die höchste Rate von 41 auf 410, bleibt ihr Rang 4. Deshalb kann ein einzelnes Dokument mit einer extremen Rate das Ergebnis des Rangtests nicht allein bestimmen.
Kennzahlen eines Dokuments
Die Facette Überblick im Tab Text des Inspektors (⌥⌘1) zeigt die Statistiken des aktiven Dokuments, sobald es indiziert ist. Sie sind auf fünf Abschnitte verteilt, nämlich Überblick, Lesbarkeit, Lexik, Syntax und Struktur. Danach folgen Balkendiagramme für Wortarten, Funktionen und Phrasen. Type-Token-Verhältnis, MATTR und Mittlere Dependenzdistanz erscheinen mit zwei Nachkommastellen, LIX als ganze Zahl. Hapax-Anteil und die Anteile erscheinen als ganze Prozentwerte, alle übrigen Statistiken mit einer Nachkommastelle. In Abfragen stehen diese Statistiken über das Dokumentfeld Kennzahl zur Verfügung, sodass Sie Dokumente nach ihren statistischen Eigenschaften filtern oder gruppieren können (siehe Dokumente nach einer Kennzahl finden in Kapitel 10, Der Text-Inspektor).
Wörter bedeutet hier Wort-Tokens. Satzzeichen und andere Zeichen, die keine Wörter sind, etwa #, zählen nicht mit, Zahlen dagegen schon. Sätze sind die Sätze, die LemmaLoom bei der Indizierung erkannt hat.
Zählungen und Struktur
| Kennzahl | Was sie misst | Werte |
|---|---|---|
| Sätze | Die Sätze im Dokument | Ganze Zahl |
| Wörter | Die Wort-Tokens | Ganze Zahl |
| Verschiedene Wörter | Die unterschiedlichen Wörter, gezählt nach Lemma (Grundform); Frist und Fristen zählen also als ein Wort | Ganze Zahl, höchstens Wörter |
| Absätze | Die Absätze, getrennt an Leerzeilen, sofern der Text Leerzeilen enthält, sonst an jedem Zeilenumbruch | Ganze Zahl |
| Zeichen | Die Zeichen des Textes, Leerzeichen und Zeilenumbrüche eingeschlossen | Ganze Zahl |
| Durchschn. Satzlänge | Wörter geteilt durch Sätze | Wörter, mit einer Nachkommastelle |
| Dialoganteil | Der Anteil der Wörter innerhalb von Anführungszeichen, geschätzt, indem öffnende und schließende Zeichen einander zugeordnet werden | 0 % bis 100 % |
| Fragen und Ausrufe | Der Anteil der Sätze, die mit einem Fragezeichen oder einem Ausrufezeichen enden | 0 % bis 100 % |
| Sätze pro Absatz | Sätze geteilt durch Absätze | In der Praxis 1 oder mehr |
| Wortarten, Funktionen, Phrasen | Wörter nach Wortart und nach grammatischer Funktion; Phrasen nach ihrer Art | Ganze Zahlen |
Die ersten fünf Kennzahlen stehen unter Überblick. Durchschn. Satzlänge eröffnet den Abschnitt Lesbarkeit, und die nächsten drei folgen unter Struktur. Zählungen und Struktur in Kapitel 10, Der Text-Inspektor erklären im Einzelnen, wie jede Kennzahl funktioniert.
In Transkripten ergeben sich die Satzgrenzen aus der Transkription. Jede Kennzahl, die auf Sätzen beruht, hängt deshalb davon ab, wie die transkribierende Person Satzzeichen gesetzt hat.
Lesbarkeit
Eine Lesbarkeitsformel schätzt aus der durchschnittlichen Satz- und Wortlänge, wie schwer ein Text zu lesen ist. Welche Formeln erscheinen, hängt von der Sprache des Dokuments ab.
Alle Lesbarkeitsformeln verwenden die Schreibweise aus Kapitel 10, Der Text-Inspektor. ist die Zahl der Wörter und die Zahl der Sätze. ist die Zahl der Silben, die der Buchstaben und die der Buchstaben und Ziffern. zählt die Wörter mit drei oder mehr Silben, dieselben ohne Eigennamen. zählt die Wörter mit mehr als sechs Buchstaben und die einsilbigen Wörter.
| Kennzahl | Sprache | Formel | Lesart |
|---|---|---|---|
| Flesch Reading Ease | Englisch | Höher bedeutet leichter. Fleschs eigene Skala reicht von sehr schwer (0–30) bis sehr leicht (90–100); der Hinweis in der App setzt einfaches Englisch bei 60–70 an. Werte können außerhalb von 0–100 liegen | |
| Flesch-Kincaid-Stufe | Englisch | Eine US-Schulstufe (Stufe 8 entspricht etwa einem Alter von 13 bis 14 Jahren) | |
| Gunning Fog | Englisch | Schuljahre | |
| SMOG | Englisch | Eine US-Schulstufe | |
| Coleman-Liau | Englisch | Eine US-Schulstufe, ohne Silbenzählung | |
| ARI | Englisch | Eine US-Schulstufe, ohne Silbenzählung | |
| Flesch-Amstad | Deutsch | Zu lesen wie Flesch Reading Ease; höher bedeutet leichter | |
| Wiener Sachtextformel | Deutsch | Eine Schulstufe deutschsprachiger Schulsysteme, von etwa 4 für sehr leichte bis 15 für sehr schwere Texte | |
| LIX | Englisch, Deutsch | Der Hinweis in der App setzt mittlere Schwierigkeit bei 40 an. Unter 30 gilt meist als leicht, über 60 als sehr schwer | |
| Zeichen pro Satz | Chinesisch | Zeichen in Wörtern geteilt durch Sätze, Satzzeichen und Ziffern ausgenommen | Höher bedeutet längere Sätze |
| Durchschn. Wortlänge | Chinesisch | Dieselben Zeichen geteilt durch Wörter | In Zeichen, mit einer Nachkommastelle |
| Partikeldichte | Chinesisch | Aspektpartikeln wie 了, die Partikeln 的, 地 und 得 und Zählwörter wie 个, jeweils pro 100 Wörter | Eine Nachkommastelle |
In Lesbarkeit in Kapitel 10, Der Text-Inspektor berechnen die verschiedenen Formeln Lesbarkeitswerte für eine Textstelle aus drei Sätzen. Für diese Textstelle reichen die geschätzten Schulstufen von 2,4 bei ARI bis 8,8 bei SMOG. Jede Formel gewichtet Wortlänge und Satzlänge anders. SMOG und Gunning Fog zählen nur mehrsilbige Wörter (mit drei oder mehr Silben), ARI und Coleman-Liau zählen Buchstaben, und die Flesch-Formeln messen die Gesamtzahl der Silben. Wenn Sie mehrere Dokumente vergleichen, wenden Sie auf alle dieselbe Formel an.
Silben werden über Vokalgruppen gezählt; Familien ergibt deshalb drei Silben, obwohl es vier hat (siehe Buchstaben, Zeichen und Silben in Kapitel 10, Der Text-Inspektor). Bei großen Textmengen gleicht sich das aus, kürzere Texte kann es aber verzerren. Außerdem gehen die Formeln von geschriebenem Text aus; in Transkripten wie „Radiodebatte“ verzerren die kürzeren Sätze der einzelnen Beteiligten die Werte.
Wortschatz
Der Abschnitt Lexik untersucht die Vielfalt des Wortschatzes, den Anteil der Inhaltswörter und die durchschnittliche Wortlänge (siehe Wortschatz in Kapitel 10, Der Text-Inspektor).
| Kennzahl | Was sie misst | Werte und Lesart |
|---|---|---|
| Type-Token-Verhältnis | Verschiedene Wörter geteilt durch Wörter | 0 bis 1; höher bedeutet einen abwechslungsreicheren Wortschatz. Es sinkt, je länger ein Text wird; vergleichen Sie deshalb nur Texte ähnlicher Länge |
| MATTR | Das Type-Token-Verhältnis jedes Abschnitts von 100 aufeinanderfolgenden Wörtern, gemittelt | 0 bis 1; vergleichbar zwischen Texten unterschiedlicher Länge. Bei einem Text mit 100 Wörtern oder weniger gleich dem Type-Token-Verhältnis |
| Lexikalische Dichte | Der Anteil der Wörter, die nicht auf der Stoppwortliste der Sprache stehen; Stoppwörter sind kurze Funktionswörter wie der, von und ist | 0 % bis 100 %; höher bedeutet mehr Inhaltswörter und weniger Funktionswörter |
| Hapax-Anteil | Der Anteil der verschiedenen Wörter, die genau einmal vorkommen | 0 % bis 100 % |
| Durchschn. Wortlänge | Buchstaben pro Wort; chinesische Dokumente zeigen stattdessen Zeichen pro Wort unter Lesbarkeit | Buchstaben, mit einer Nachkommastelle |
| Stoppwort-Anteil | Der Anteil der Wörter, die auf der Stoppwortliste stehen | 0 % bis 100 %; zusammen mit dem Wert Lexikalische Dichte ergibt er immer 100 % |
Type-Token-Verhältnis (TTR), MATTR und Hapax-Anteil werden anhand der Lemmata berechnet. Ein Bericht mit 4.000 Wörtern, darunter 800 verschiedenen, hat ein TTR von . Kommen 400 dieser Wörter im Bericht nur einmal vor, beträgt sein Hapax-Anteil . Die ersten 200 Wörter desselben Berichts verwenden vielleicht 110 Lemmata, was ein TTR von 0,55 ergibt, weil sich in diesem kurzen Abschnitt erst wenige Wörter wiederholt haben. MATTR vermeidet diese Verzerrung, indem es das TTR immer in gleich langen Abschnitten misst.
Syntax
Der Abschnitt Syntax erscheint, sobald LemmaLoom die grammatische Struktur der Sätze analysiert hat (siehe Syntax in Kapitel 10, Der Text-Inspektor). Die Dependenzanalyse ermittelt in jedem Satz, von welchem Wort, seinem Kopf, jedes Wort abhängt; so hängen etwa Adjektive von Substantiven und Subjekte von Verben ab. Jedes Wort ist mit einem Kopf verbunden, außer der Wurzel, meist dem Hauptverb des Satzes.
| Kennzahl | Was sie misst | Werte und Lesart |
|---|---|---|
| Mittlere Dependenzdistanz | Der durchschnittliche Abstand in Positionen zwischen einem Wort und seinem Kopf | 1 oder mehr; höhere Werte bedeuten meist Sätze, denen schwerer zu folgen ist |
| Durchschn. Baumtiefe | Die längste Kette von Abhängigkeiten ab der Wurzel des Satzes, gemittelt über alle Sätze | 0 oder mehr; höher bedeutet tiefer verschachtelte Sätze |
| Teilsätze pro Satz | Die Teilsätze, die die Phrasenanalyse gefunden hat, geteilt durch Sätze | 0 oder mehr; höher bedeutet komplexere Sätze |
| Anteil eingebetteter Teilsätze | Der Anteil der Teilsätze, die innerhalb eines anderen Teilsatzes liegen | 0 % bis 100 % |
| Passivsätze | Der Anteil der Sätze mit einer Passivkonstruktion | 0 % bis 100 % |
In Wir blockieren die Straßen hängt wir von blockieren ab, eine Position entfernt, die von Straßen, ebenfalls eine Position entfernt, und Straßen von blockieren, zwei Positionen entfernt. Das ergibt eine mittlere Dependenzdistanz von . Blockieren ist die Wurzel dieses Baums und liegt in Tiefe 0, wir und Straßen zweigen in Tiefe 1 davon ab. Die zweigt in Tiefe 2 ab, und damit hat der Satz die Tiefe 2.
Für Anteil eingebetteter Teilsätze nimmt LemmaLoom an, dass jeder Satz, der einen Teilsatz enthält, genau einen Hauptsatz hat. Alle weiteren Teilsätze gelten als eingebettet; ein Satz mit drei Teilsätzen ergibt also zwei eingebettete.
Assoziationsmaße für Wörter
Kollokationslisten und Wortskizzen messen mit verschiedenen Maßen, wie stark ein Wort seine Partner anzieht. In beiden ist das Knotenwort das Wort, das Sie nachschlagen; ein Kollokat ist jedes Wort, das in der Nähe des Knotenworts vorkommt. Kollokate stammen aus einem kleinen Fenster von einigen Wörtern vor und nach dem Knotenwort, Wortskizzen dagegen verwenden die grammatische Relation des Partners (etwa das Objekt eines Verbs). Alle Werte in Kollokationslisten und Wortskizzen hängen von den folgenden vier Größen ab:
- ist das f oder die Anzahl einer Zeile. Dieser Wert gibt an, wie oft das Kollokat in der Nähe des Knotenworts vorkam, bei Kollokaten in dessen Fenstern, bei Wortskizzen in der jeweiligen Relation.
- ist die Zahl der Wörter in allen Fenstern zusammen. Bei einer Wortskizze ist es die Gesamtzahl der Fälle, in denen das skizzierte Wort in der betreffenden grammatischen Relation vorkommt.
- ist die Häufigkeit des Kollokats im gesamten Text. In der Kollokationsliste einer Abfrage ist das die Spalte Häufigkeit.
- ist die Zahl der Wörter im Text.
Die erwartete Häufigkeit ist dann . Die Beispielspalte verwendet die erfundenen Zahlen aus Die Assoziationsmaße in Kapitel 11, Der Grammatik-Inspektor, nach denen das Verb schützen in einer Magazinreportage mit 5.000 Wörtern 8-mal in der Nähe von Klima vorkommt. Sie lauten , , und , also .
| Maß | Formel | schützen | Werte und Lesart |
|---|---|---|---|
| Häufigkeit | 8 | Eine ganze Zahl. Minimum blendet in einer Abfrage die Kollokate darunter aus | |
| Erwartete Häufigkeit | 0,4 | Über 0 | |
| MI | 4,32 | 0 bedeutet so oft wie zufällig erwartet, und jeder Punkt mehr verdoppelt das. Bevorzugt seltene Partner. In der Korpuslinguistik achtet man oft auf Werte ab 3 | |
| MI3 | 10,32 | Keine feste Skala. Gibt häufigen Paaren mehr Gewicht als MI | |
| t-Wert | 2,69 | 0 bedeutet so oft wie zufällig erwartet; 2 oder mehr ist die übliche Faustregel für eine echte Verbindung. Bevorzugt häufige Partner | |
| z-Wert | 12,02 | 0 bedeutet so oft wie zufällig erwartet. Wird bei seltenen Wörtern sehr groß | |
| Log-Likelihood | über vier Zellen | 36,76 | 0 oder mehr. 3,84; 6,63 und 10,83 entsprechen p = 0,05; 0,01 und 0,001 |
| Dice | 0,133 | Über 0 | |
| logDice | 11,09 | Jeder Punkt weniger halbiert Dice. Werte unter 0 sind selten. Ändert sich kaum mit der Länge des Textes |
Die Log-Likelihood vergleicht die Beobachtungen in vier Zellen, nämlich das Kollokat innerhalb und außerhalb der Fenster und die übrigen Wörter innerhalb und außerhalb davon. ist die Häufigkeit einer Zelle, und jede Zelle hat ihre eigene erwartete Häufigkeit. Im Beispiel schützen enthalten die Zellen 8, 92, 12 und 4.888, bei erwarteten Häufigkeiten von 0,4; 99,6; 19,6 und 4.880,4. Die Statistik ergibt sich dann so:
Die Maße erscheinen an diesen Stellen:
- Die Facette Kollokationen im Tab Grammatik zeigt Log-Likelihood, MI, t-Wert und logDice für ein Dokument. Log-Likelihood und t-Wert rundet sie auf eine Nachkommastelle (36,8 und 2,7 für schützen). Der CSV-Export der Facette ergänzt Erwartet, MI3, z-Wert und Dice. Das Fenster der Facette reicht von ± 1 bis ± 10 und steht zu Beginn auf ± 4. Satzzeichen und Stoppwörter belegen Positionen, und jedes andere Wort im Fenster ist ein Kollokat.
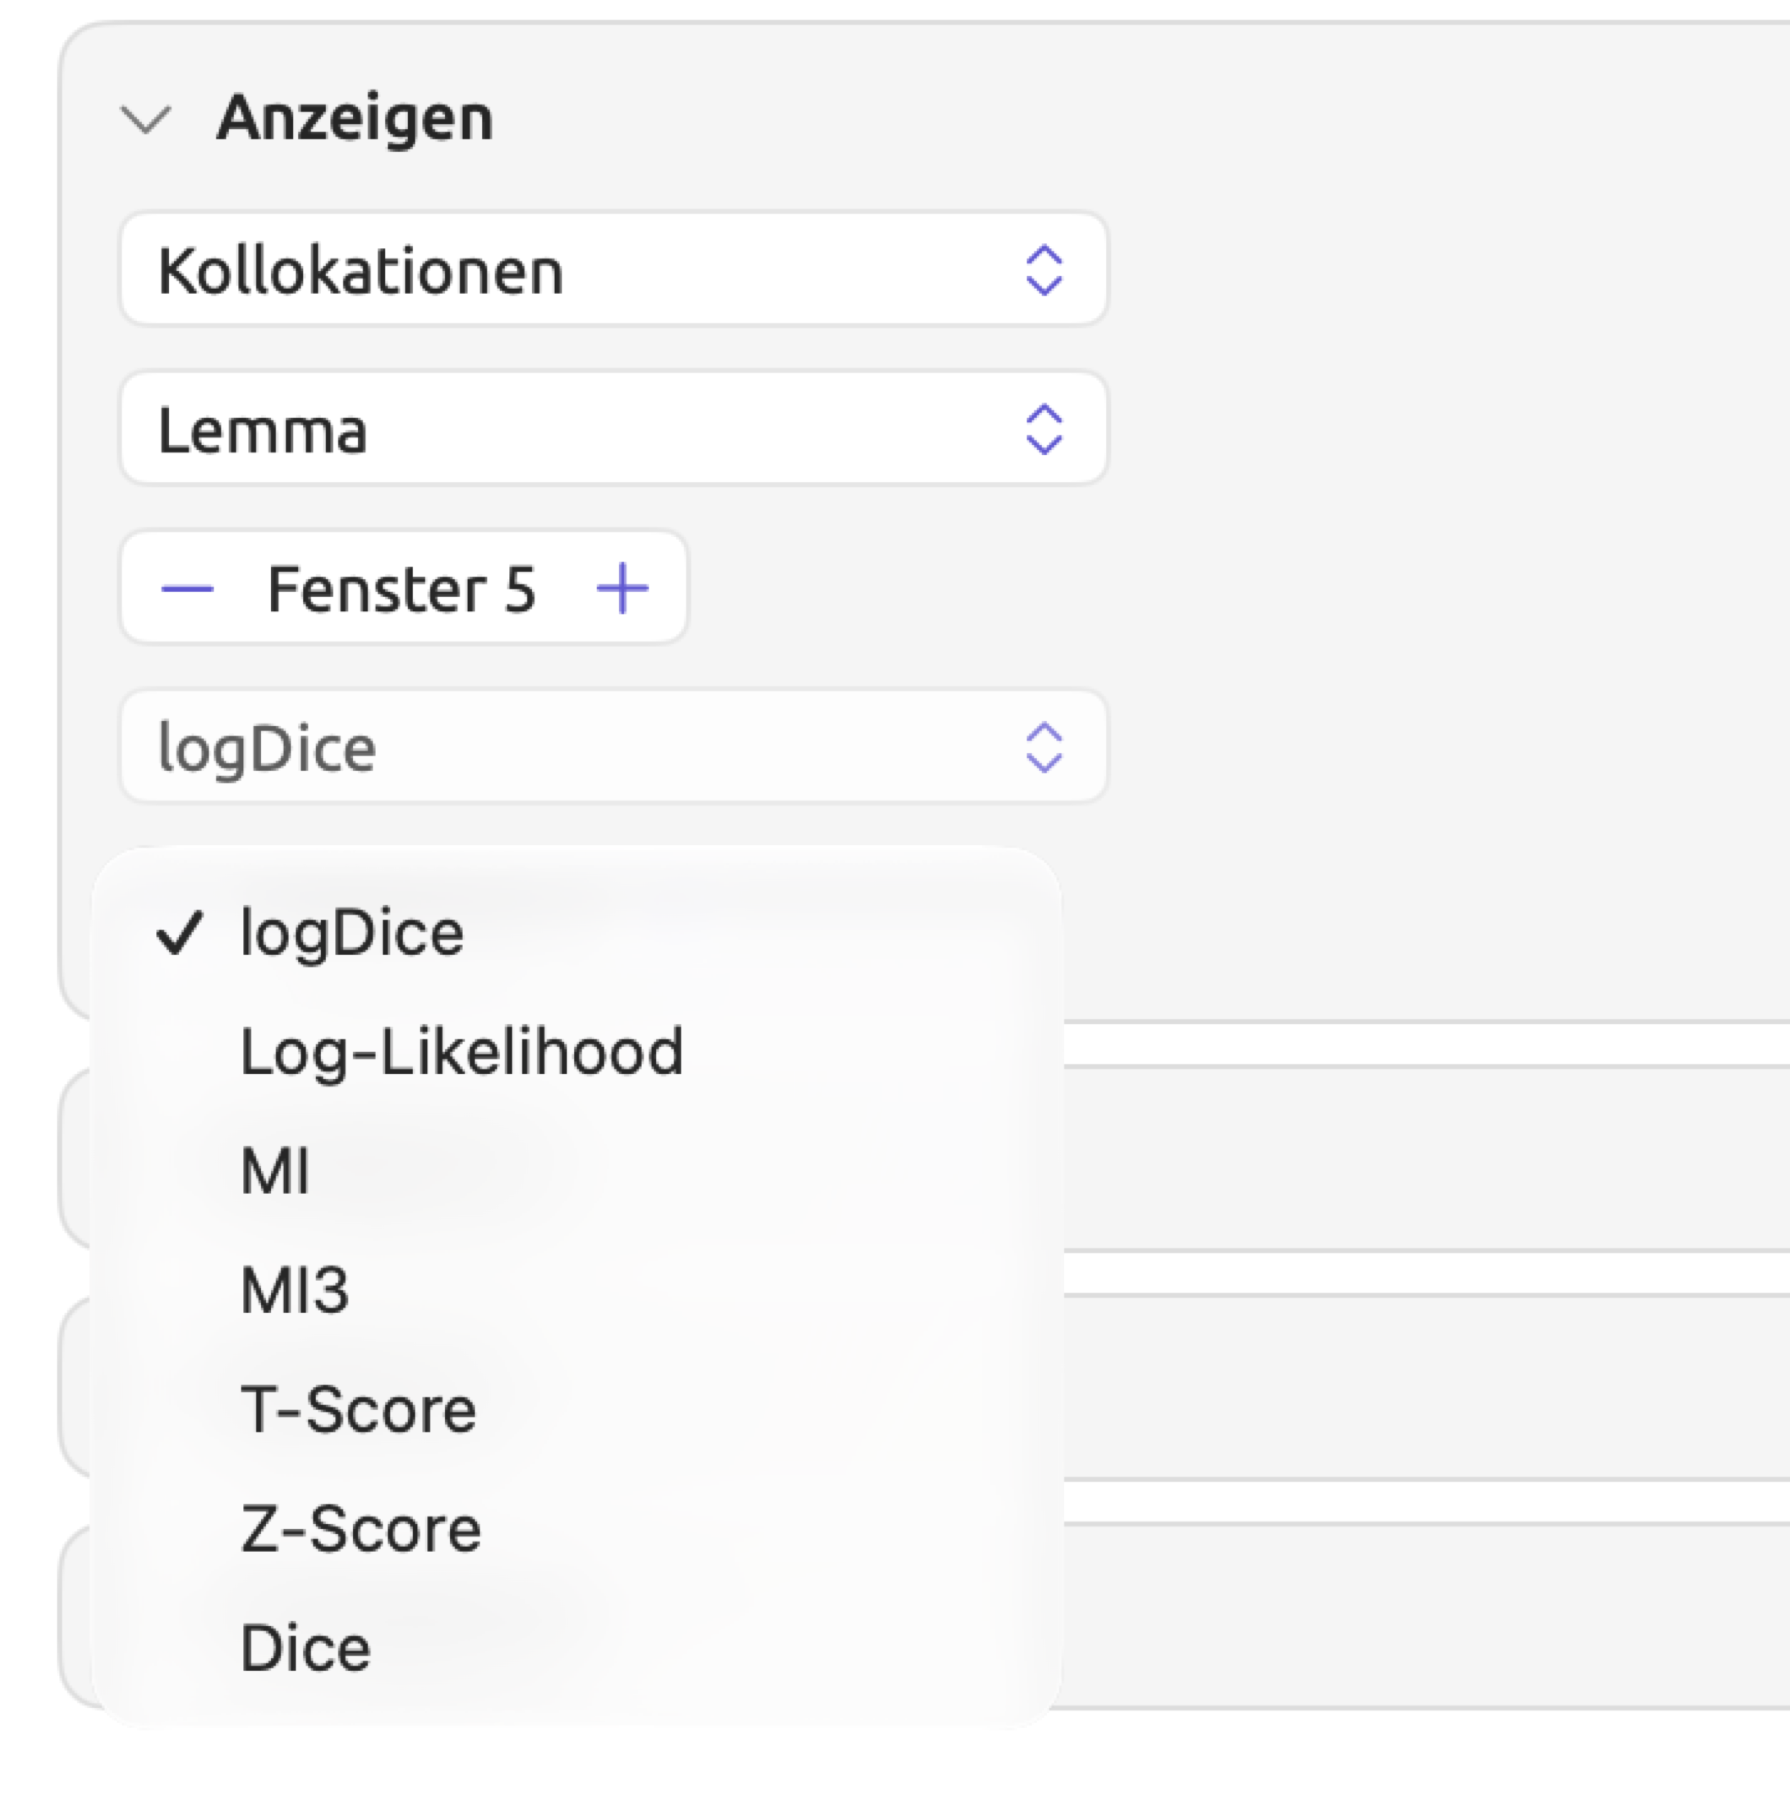
- Im Ergebnis Kollokationen einer Abfrage können Sie im Menü, das logDice zeigt, jedes der sieben Maße wählen, nämlich logDice, Log-Likelihood, MI, MI3, T-Score, Z-Score und Dice, jeweils mit zwei Nachkommastellen. Voreingestellt ist logDice. Das Fenster reicht von 1 bis 10 und steht zu Beginn auf 5; Satzzeichen werden übersprungen, und Stoppwörter zählen als Kollokate. Minimum reicht von 1 bis 50 und steht zu Beginn auf 3, und die Liste zeigt bis zu 200 Kollokate.
- Wortskizzen, die Code-Skizze und die Liste des Skizzenraums verwenden nur Häufigkeit und logDice. In einer Wortskizze ist die Gesamtzahl der Verbindungen dieser Relation. In einer Zelle des Skizzenraums ist die Gesamtzahl der Verbindungen dieser Relation unter dem betreffenden Code. In der Code-Skizze ist die Zahl der Verbindungen aller Relationen in den Textstellen, die mit diesem Code kodiert sind. ist die Häufigkeit des Partners in seiner Wortklasse (siehe logDice in Kapitel 12, Wortskizze).
In der Facette wie in Abfragen endet ein Fenster immer am Satzende. Ansonsten zählen Facette und Abfragen ihre Fenster unterschiedlich, sodass dasselbe Paar nach demselben Maß in beiden leicht verschiedene Werte erhalten kann. Für den Vergleich von Listen aus zwei unterschiedlich langen Texten ist logDice das sicherste Maß ( geht in logDice nicht ein).
Werte für Schlüsselwörter und Profile
Schlüsselwortlisten vergleichen Ihr Ziel mit einer Referenz. Passagen wie ein Code verwendet dieselben Maße, um die Wörter innerhalb der Kodierungen eines Codes mit denen außerhalb zu vergleichen. In den Formeln sind und die Vorkommen eines Wortes auf den beiden Seiten und und die Wortzahlen der beiden Seiten. und sind die erwarteten Häufigkeiten. Bei Passagen wie ein Code werden Stoppwörter bei der Berechnung übersprungen.
| Maß | Wo | Formel | Werte und Lesart |
|---|---|---|---|
| Log-Likelihood | Die Spalte Log-Likelihood der Schlüsselwörter; die Gewichte eines Profils | 0 oder mehr. Schlüsselwortlisten behalten Wörter mit LL ≥ 3,84, LL ≥ 6,63 oder LL ≥ 10,83. Häufige Wörter erreichen leicht hohe Werte | |
| Log-Ratio | Die Spalte Log-Ratio der Schlüsselwörter; die Regeln eines Profils | Ohne Grenze; 0 bedeutet dieselbe Rate, 1 doppelt so oft, −1 halb so oft. Ein Betrag von mindestens 1 in die eine oder andere Richtung gilt oft als Mindestmaß für einen beachtenswerten Unterschied | |
| Wert | Listen, sortiert nach Wert | Ohne Grenze. Vergleichen Sie Werte nur innerhalb einer Liste |
Die Log-Likelihood von Hoffnung (siehe Erwartete Häufigkeiten weiter oben in diesem Kapitel) beträgt 5,34. Die Log-Ratio ist
Die Aktivisten verwenden Hoffnung also fast viermal so häufig wie die Skeptiker. Die rohen Raten von 30,0 und 6,7 Vorkommen pro 10.000 Wörter ergeben ein Verhältnis von 4,5. Die 0,5, die zu jeder Häufigkeit addiert wird, zieht die Log-Ratio in Richtung 0, besonders bei kleinen Häufigkeiten.
Eine Schlüsselwortliste besteht aus zwei Listen. Die Liste Positive Schlüsselwörter enthält die Wörter, die das Ziel häufiger verwendet, Negative Schlüsselwörter die Wörter, die es seltener verwendet, mit negativer Log-Ratio. In die Listen kommen nur Wörter, die den Schwellenwert erreichen und auf ihrer eigenen Seite mindestens dreimal vorkommen, also im Ziel bei positiven und in der Referenz bei negativen Schlüsselwörtern. Jede Liste zeigt bis zu 200 Wörter, geordnet nach Log-Likelihood. Mehr dazu, wie die Werte der Einträge zustande kommen, finden Sie unter Wie die beiden Werte berechnet werden in Kapitel 16, Abfrageergebnisse und Statistik.
Das Profil von Passagen wie ein Code wird aus den Wörtern gebildet, die mindestens dreimal innerhalb der Kodierungen vorkommen und eine Log-Ratio von mindestens 1 haben. Die 50 Wörter mit der höchsten Log-Likelihood kommen ins Profil, jeweils mit ihrer Log-Likelihood als Gewicht. Mehr dazu, wie das Profil eines Codes entsteht, finden Sie unter Wie das Profil gelernt wird in Kapitel 17, Abfragemuster und Erkundung.
In der Formel für den Wert sind bis die Gewichte der verschiedenen Profilwörter, die in einer Textstelle vorkommen, jedes einmal gezählt, und ist die Zahl der Wörter dieser Textstelle. Damit eine Textstelle aufgeführt wird, muss sie mindestens zwei verschiedene Profilwörter enthalten; besteht das Profil nur aus einem Wort, genügt eines. Ein Satz aus neun Wörtern mit zwei Profilwörtern der Gewichte 20 und 16 erhält den Wert .
Werte einfrieren macht aus den ersten 200 Zeilen eines Kollokations- oder Schlüsselwortergebnisses eine eingefrorene Liste; bei Schlüsselwörtern wird nur die Liste Positive Schlüsselwörter übernommen. Jedes Wort behält seinen Wert aus dem Ergebnis als Gewicht. Eine Abfrage, die auf der Liste aufbaut, kann die passenden Textstellen dann auf dieselbe Weise nach Wert sortieren, wobei eine Textstelle mindestens zwei verschiedene Wörter der Liste enthalten muss. Siehe Werte einfrieren in Kapitel 18, Abfrageergebnisse nutzen.
Maße in Abfragen
Anzahl, Vergleichen und Im Zeitverlauf zeigen eines von fünf Maßen. Sie wählen es im Menü, das Treffer zeigt (siehe Maße in Kapitel 16, Abfrageergebnisse und Statistik).
| Maß | Was es zeigt | Werte |
|---|---|---|
| Treffer | Die Zahl der Treffer | Ganze Zahl |
| Dokumente | Die Zahl der Dokumente mit mindestens einem Treffer | 0 bis zur Zahl der gelesenen Dokumente |
| Pro 10.000 Wörter | , gepoolt über die Dokumente der Zeile | 0 oder mehr |
| Abdeckung | Die Zeichen, die mindestens ein Treffer abdeckt, geteilt durch die Zeichen der Dokumente der Zeile | 0 % bis 100 % |
| Anteil | Die Treffer der Zeile geteilt durch alle Treffer | 0 % bis 100 %; zusammen können die Zeilen mehr als 100 % ergeben, wenn ein Treffer mehrere Werte hat |
Bei einem Schlüssel auf Dokumentebene wie „Haltung“ sind die Wörter und Zeichen einer Zeile die der Dokumente mit diesem Wert. Bei jedem anderen Schlüssel, etwa Code, sind es die Wörter und Zeichen aller Dokumente, die die aktuelle Abfrage gelesen hat.
Mit dem Schlüssel Position im Dokument, den Im Zeitverlauf einsetzt, wenn kein Schlüssel gewählt ist, wird für jedes Dokument ein Streifen mit seinen Treffern gezeichnet. Über den Streifen stehen zwei Zahlen, die beschreiben, wie sich die Treffer auf die Dokumente verteilen (siehe Wo die Treffer in jedem Dokument liegen in Kapitel 16, Abfrageergebnisse und Statistik). Ist der Schlüssel ein Datumsfeld oder Medienzeit, zeichnet Im Zeitverlauf das gewählte Maß als Liniendiagramm.
| Zahl | Was sie zeigt | Werte |
|---|---|---|
| Verbreitung | Dokumente mit mindestens einem Treffer im Verhältnis zu allen gelesenen Dokumenten, etwa 5 / 6 | 0 bis zur Zahl aller Dokumente |
| DP | 0 bis knapp unter 1 |
DP ergibt sich aus der Zahl der Treffer () und der Größe () jedes Dokuments , mit den Summen und . Die Größe wird in Wörtern gemessen oder in Zeichen, wenn die Abfrage keine Wörter zählt. Ein DP von 0 bedeutet, dass sich die Treffer genau im Verhältnis der Dokumentgrößen verteilen. Der höchste mögliche DP beträgt 1 abzüglich des Anteils, den das kleinste Dokument am gesamten Text hat. Zwei gleich große Dokumente, bei denen alle Treffer in nur einem liegen, erreichen , den höchsten Wert, den zwei solche Dokumente zulassen.
Statistiken zu Kodierungen
Die Ansichten des Regals zählen nur Originaldokumente; eine Kodierung, die in eine Übersetzung kopiert wurde, zählt also nur einmal. Was die Ansichten zählen in Kapitel 13, Codes auswerten erklärt die übrigen Regeln.
| Kennzahl | Wo | Was sie misst | Werte |
|---|---|---|---|
| Segmente | Codebuch; Code-Statistik im Regal; die Zahl neben jedem Code in der Facette Code-Statistik | Die Kodierungen eines Codes. In der Facette Code-Statistik zählt auch ein kodiertes Memo mit, und seine Textstelle geht in Abdeckung und φ ein | Ganze Zahl |
| Dokumente | Codebuch; Code-Statistik im Regal | Die Dokumente mit mindestens einer Kodierung des Codes | 0 bis zur Zahl der Dokumente im Geltungsbereich |
| Abdeckung | Codebuch; Code-Statistik im Regal und in der Facette | Die Zeichen, die ein Code abdeckt, Überschneidungen einmal gezählt, geteilt durch die Zeichen des Geltungsbereichs oder Dokuments | 0 % bis 100 % |
| TRITT GEMEINSAM AUF MIT | Codebuch | Die überlappenden Segmentpaare dieses Codes mit jedem anderen Code | Ganze Zahl |
| Überschneidungen | Paare in Beziehungen im Regal; der Tooltip einer Zelle im Raster | Die überlappenden Segmentpaare zweier Codes im Geltungsbereich | Ganze Zahl |
| Zellen der Code-Matrix | Code-Matrix im Regal | Die Segmente jedes Codes in jedem Dokument; mit Spalten gruppieren nach die Kodierungen, Dokumente oder abgedeckten Zeichen jeder Gruppe, je nach Wahl im ersten Umschalter | Anzahlen; mit Spalten gruppieren nach Anzahlen (#) oder Prozentwerte (%) |
| φ | Kookkurrenzen in der Facette Code-Statistik; Beziehungen im Regal | Wie stark sich zwei Codes überlappen, gemessen in Zeichen (in Beziehungen in den Zeichen aller Dokumente im Geltungsbereich) | 0 bis 1 |
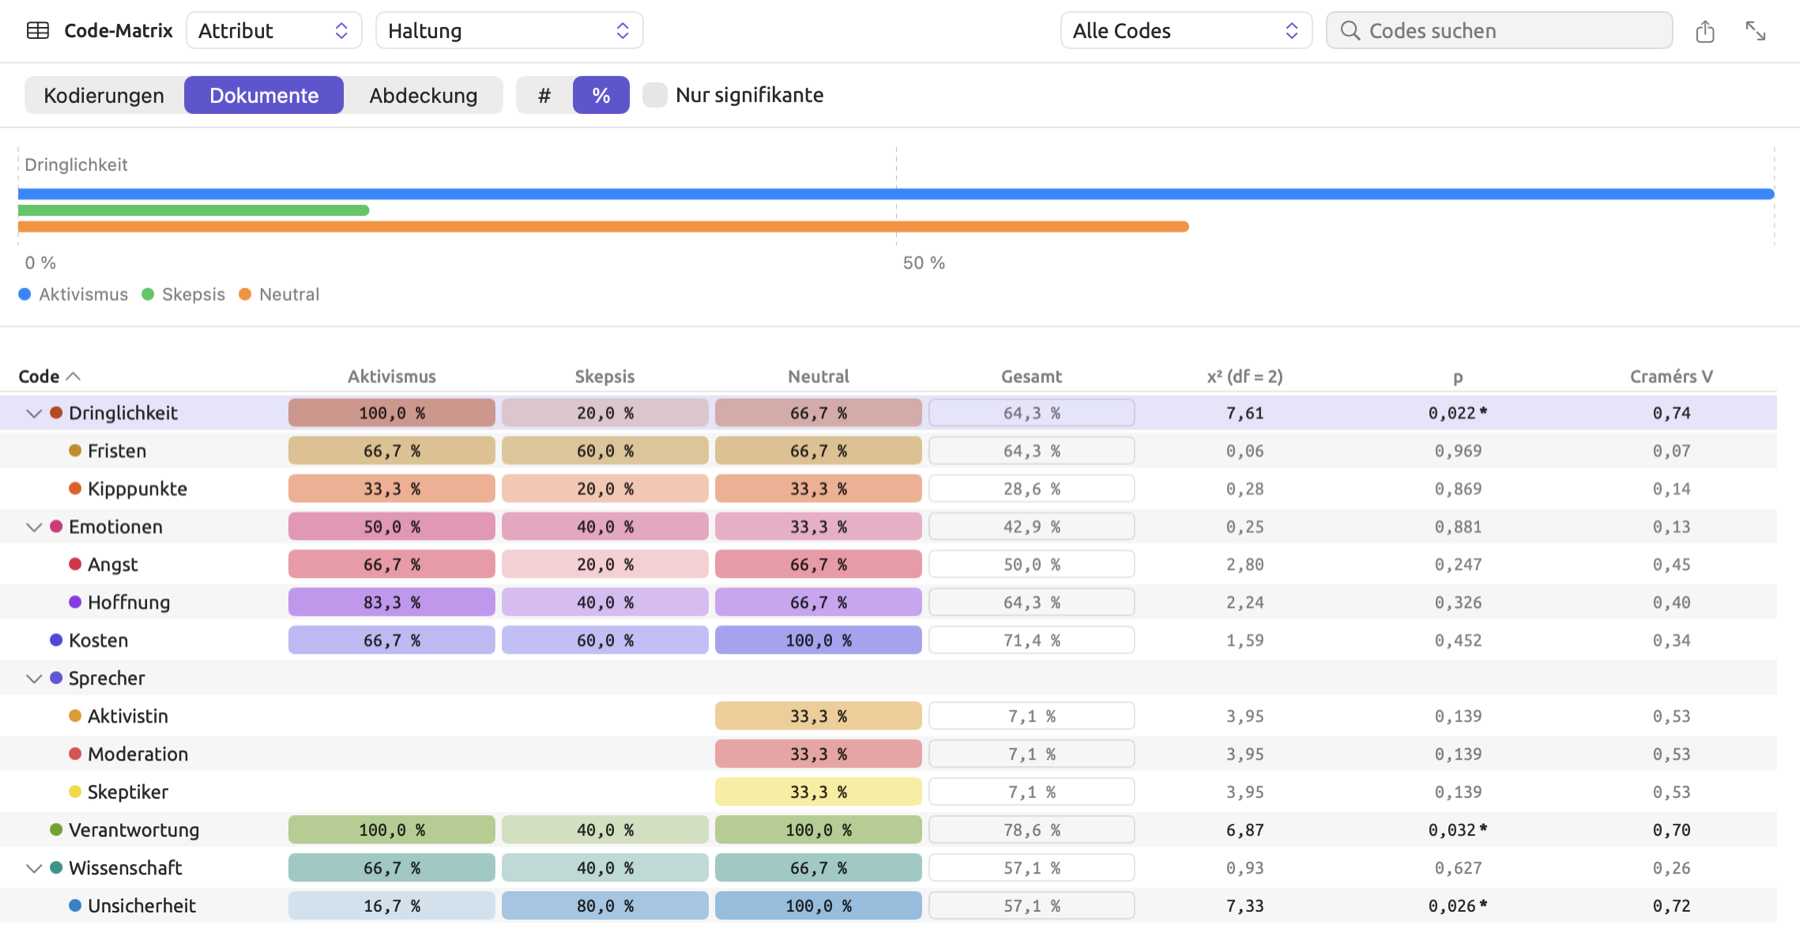
In der Code-Matrix mit % wird jeder Zellwert relativ zur Basis seiner Spaltengruppe berechnet. Die Basis einer Spaltengruppe sehen Sie, wenn Sie den Mauszeiger auf die Überschrift der Gruppe halten. Aus Kodierungen wird der Prozentanteil an allen Kodierungen der Gruppe, aus Dokumente der Prozentanteil der Dokumente der Gruppe, die den Code haben, und aus Abdeckung der Prozentanteil der Zeichen der Gruppe, den der Code abdeckt (siehe Die Spalten gruppieren in Kapitel 13, Codes auswerten).
φ für überlappende Codes
Der Abschnitt Kookkurrenzen der Facette Code-Statistik listet jedes Codepaar auf, dessen Segmente sich im Dokument überlappen, geordnet nach φ, den höchsten Wert zuerst. Jede Zeile zeigt φ und die Zahl der überlappenden Segmentpaare, und jedes Paar mit einem p-Wert unter 0,05 erhält ein * hinter seinen Namen. Kookkurrenzen in einem Dokument in Kapitel 13, Codes auswerten rechnet das Beispiel Schritt für Schritt durch. In der Ansicht Beziehungen des Regals wird φ auf dieselbe Weise berechnet, aus den Zeichen aller Dokumente im Geltungsbereich.
Die Tabelle hinter φ behandelt jedes einzelne Zeichen des Dokuments als eine Beobachtung. Der Einfachheit halber nimmt das Beispiel an, dass „Uns läuft die Zeit davon“ 5.000 Zeichen umfasst, dass „Kosten“ 250 davon abdeckt und „Verantwortung“ 200 und dass sich beide 100 Zeichen teilen:
| In „Verantwortung“ | Nicht in „Verantwortung“ | Summe | |
|---|---|---|---|
| In „Kosten“ | 100 | 150 | 250 |
| Nicht in „Kosten“ | 100 | 4.650 | 4.750 |
| Summe | 200 | 4.800 | 5.000 |
Die erwartete Überlappung beträgt Zeichen. Die Codes überlappen sich zehnmal so stark wie erwartet. Für die anderen drei Zellen sind 240, 190 und 4.560 zu erwarten; jede Zelle weicht also um 90 von ihrer erwarteten Häufigkeit ab:
Für φ teilen Sie χ² durch und ziehen die Quadratwurzel. ist hier die Zahl der Zeichen im Dokument.
Der p-Wert stammt aus der Chi-Quadrat-Verteilung mit einem Freiheitsgrad und liegt weit unter 0,001.
Mit Tausenden von Zeichen als Beobachtungen wird der p-Wert bei fast jeder Überlappung winzig, und benachbarte Zeichen sind kaum unabhängig voneinander. In einem langen Dokument hat nahezu jedes Paar ein *. Beurteilen Sie Paare deshalb nach ihrem φ und nicht nach dem *. Das gilt in Beziehungen noch stärker, weil dort die Zeichen aller Dokumente im Geltungsbereich zusammengefasst werden.
φ hat kein Vorzeichen. Überlappt sich ein Paar seltener, als der Zufall erwarten ließe, erhält es trotzdem ein φ über 0 und oft ein *. Hätten sich „Kosten“ und „Verantwortung“ nur 2 Zeichen geteilt, ein Fünftel der erwarteten 10, läge ihr φ bei etwa 0,04, mit *. Um Anziehung von Meidung zu unterscheiden, vergleichen Sie die beobachtete mit der erwarteten Überlappung. Die beobachtete finden Sie im CSV-Export in der Spalte Zeichen. Die erwartete Überlappung ist die Zeichenzahl des einen Codes mal die des anderen, geteilt durch die Zeichenzahl des Dokuments.
Tests
| Test | Wo | Angegeben als | Effektstärke | Erklärt in |
|---|---|---|---|---|
| Mann-Whitney-U-Test | Vergleichen, Rangtest für Raten, zwei Gruppen | U, p | r | Kapitel 16, Abfrageergebnisse und Statistik |
| Kruskal-Wallis-H-Test | Vergleichen, Rangtest für Raten, drei oder mehr Gruppen | H, df, p | ε² | Kapitel 16, Abfrageergebnisse und Statistik |
| Chi-Quadrat-Test auf Häufigkeiten | Vergleichen, Chi-Quadrat auf Häufigkeiten | χ², df, p | Cramérs V | Kapitel 16, Abfrageergebnisse und Statistik |
| Exakter Fisher-Test, zweiseitig | Vergleichen, Präsenztest, zwei Gruppen; Code-Matrix mit zwei Gruppen | χ², df, p in Vergleichen, wobei p aus dem Fisher-Test stammt und χ² zum Vergleich angegeben ist; p (Fisher) in der Code-Matrix | φ in Vergleichen; Cramérs V in der Code-Matrix | Kapitel 16, Abfrageergebnisse und Statistik; Kapitel 13, Codes auswerten |
| Chi-Quadrat-Test auf Präsenz | Vergleichen, Präsenztest, drei oder mehr Gruppen; Code-Matrix mit drei oder mehr Gruppen | χ², df, p | Cramérs V | Kapitel 16, Abfrageergebnisse und Statistik; Kapitel 13, Codes auswerten |
| Chi-Quadrat-Test einer Tabelle | Vergleichen mit zwei Gruppierungsschlüsseln | χ², df, p | Cramérs V | Kapitel 16, Abfrageergebnisse und Statistik |
| Chi-Quadrat-Test auf Zeichen | Kookkurrenzen in der Facette Code-Statistik; Beziehungen im Regal | * bei p < 0,05; p im CSV-Export von Kookkurrenzen und in Beziehungen | φ | Kapitel 13, Codes auswerten |
| Exakter Fisher-Test, einseitig | Skizzenraum; der Modus Multimodus der Wortskizze | * | Keine | Kapitel 12, Wortskizze; Kapitel 14, Skizzenraum |
| Schwellenwert der Log-Likelihood | Schlüsselwörter | Log-Likelihood | Log-Ratio | Kapitel 16, Abfrageergebnisse und Statistik |
Die Statistiken der Tests beantworten diese Fragen:
| Statistik | Was sie fragt | Werte |
|---|---|---|
| U | Haben die Dokumente der einen Gruppe tendenziell höhere Raten als die der anderen? | 0 bis . LemmaLoom gibt den kleineren der beiden möglichen Werte an; ein kleineres U bedeutet also eine klarere Trennung. 0 heißt, dass jedes Dokument der einen Gruppe vor jedem Dokument der anderen liegt |
| H | Dieselbe Frage für drei oder mehr Gruppen | 0 oder mehr; je größer, desto weiter liegen die mittleren Ränge der Gruppen auseinander |
| χ² | Liegen die Häufigkeiten der Tabelle weiter von ihren erwarteten Häufigkeiten entfernt, als der Zufall erwarten ließe? | 0 oder mehr; je größer, desto stärker die Abweichung. Beim exakten Fisher-Test lesen Sie p und betrachten χ² nur als Vergleichswert |
| G² | Unterscheidet sich die Häufigkeit eines Wortes zwischen Ziel und Referenz stärker, als der Zufall erwarten ließe? | 0 oder mehr; wird mit dem Wert im Menü, das LL ≥ 3,84 zeigt, verglichen |
Einen Test wählen in Kapitel 16, Abfrageergebnisse und Statistik legt dar, welcher Test zu welcher Frage passt.
Vergleichen, die Code-Matrix und der Skizzenraum sind drei Werkzeuge in LemmaLoom, die Tests durchführen. Was jedes davon testet, beschreibt die folgende Liste:
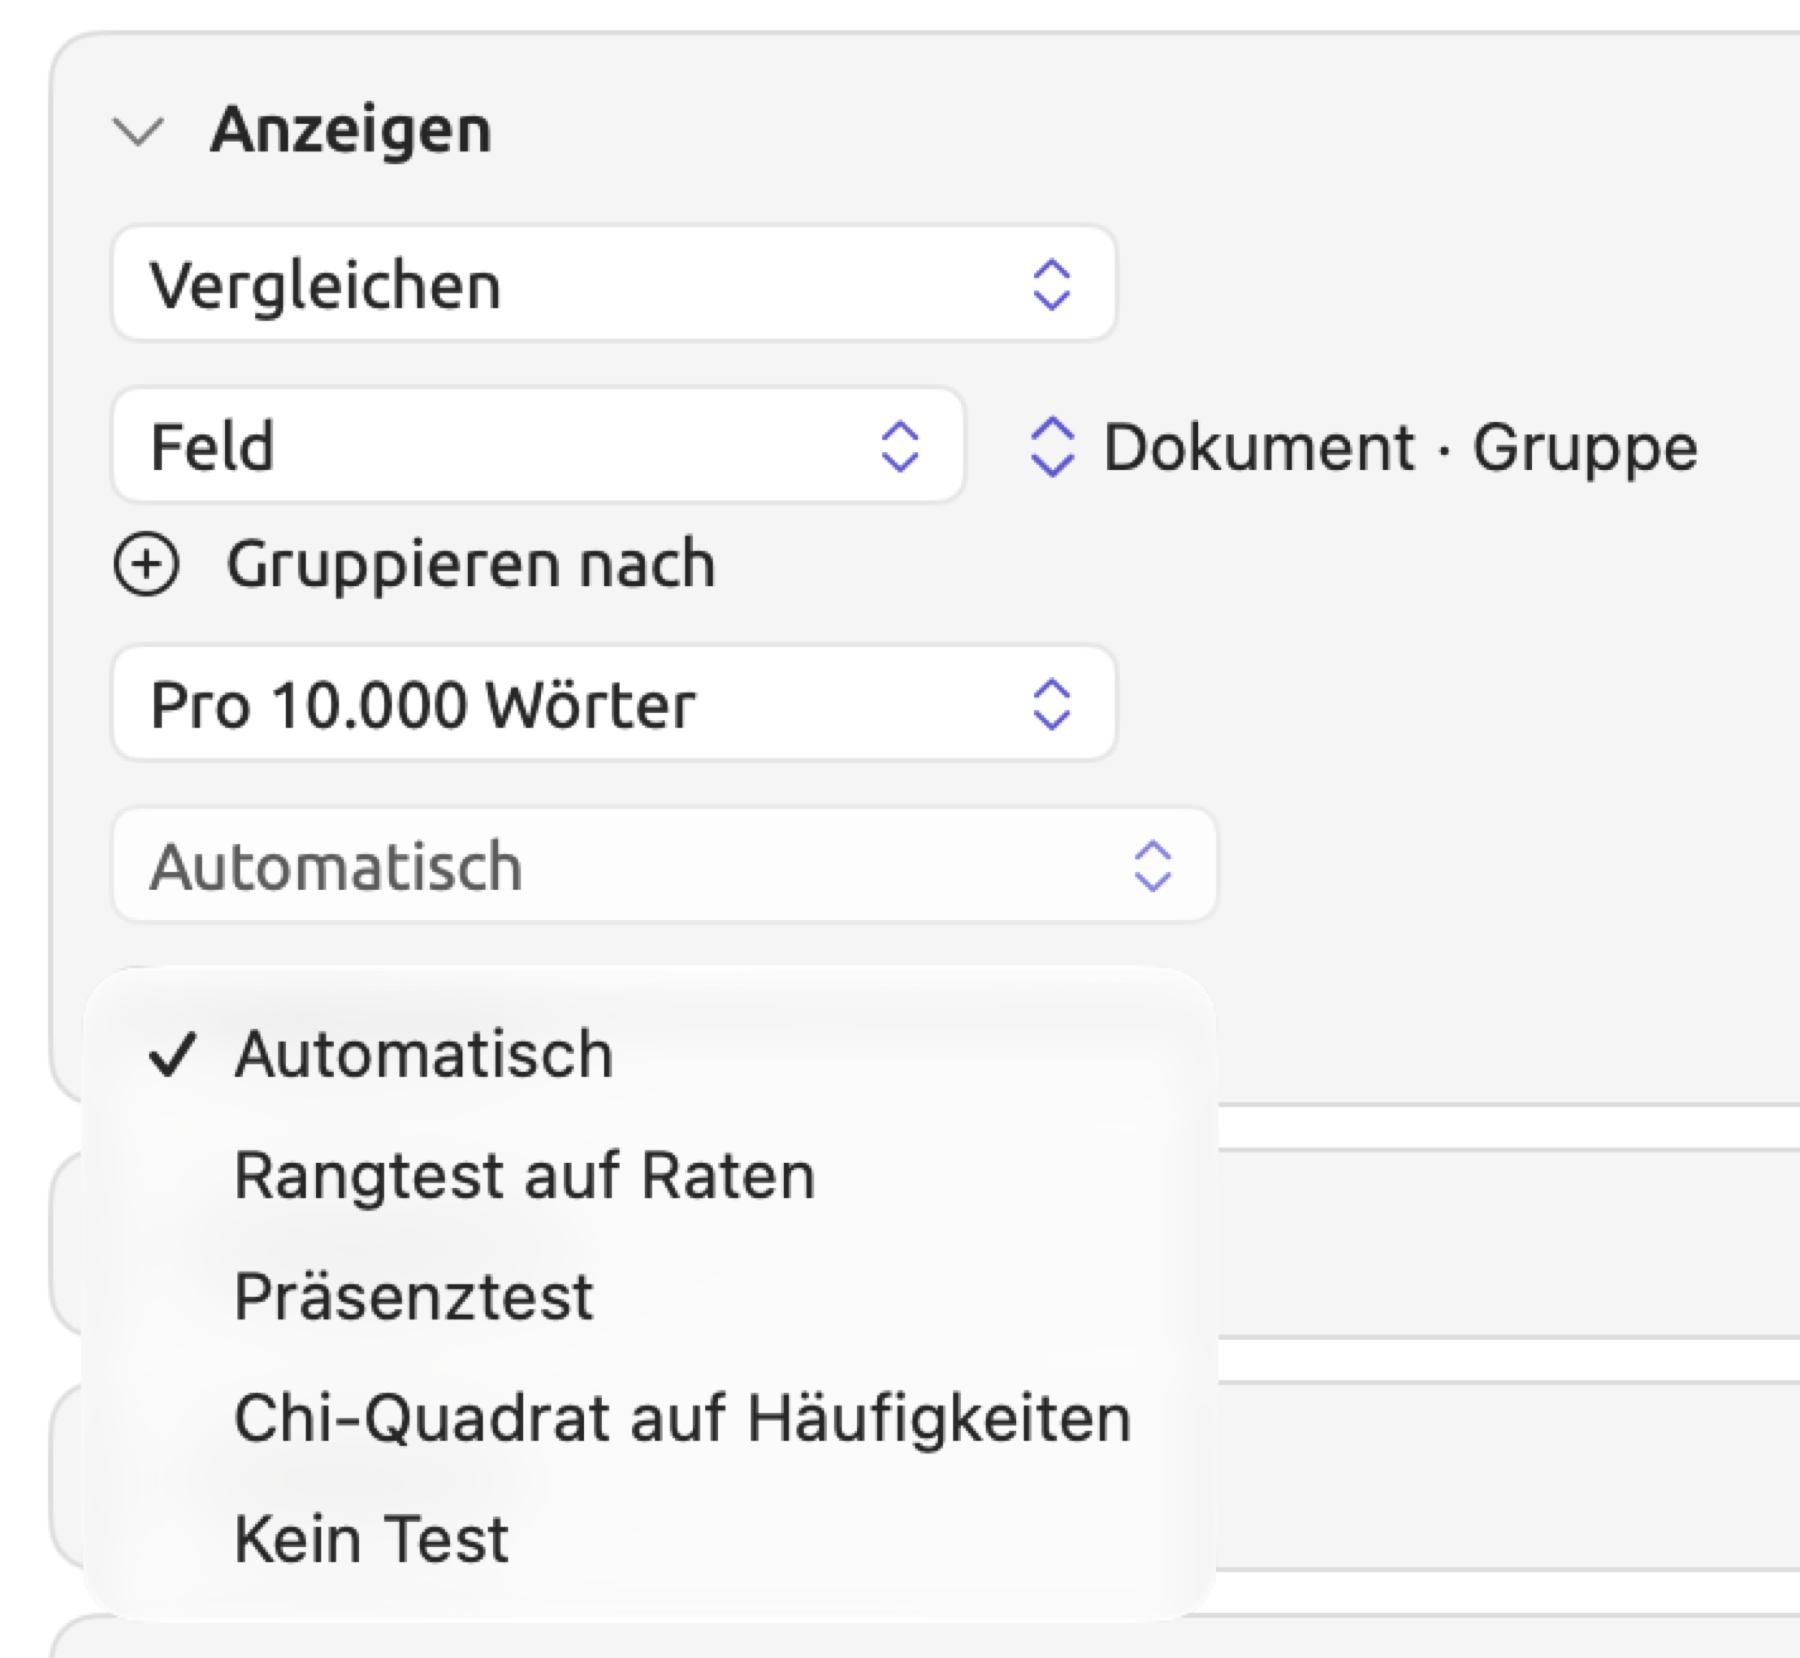
- Vergleichen testet Dokumente. Mit einem einzigen Gruppierungsschlüssel testet Vergleichen nur, wenn der Schlüssel auf Dokumentebene liegt, etwa ein Attribut wie „Haltung“ oder die Gruppe des Dokuments selbst. Das Menü, das Automatisch zeigt, bietet Automatisch, Rangtest für Raten, Präsenztest, Chi-Quadrat auf Häufigkeiten und Kein Test. Ist das Maß Dokumente, wählt Automatisch den Präsenztest, sonst den Rangtest.
- Der Rangtest misst die Rate jedes Dokuments pro 10.000 Wörter oder, wenn die Abfrage keine Wörter gezählt hat, pro 10.000 Zeichen, unabhängig davon, was die Zeilen zeigen. Genauer beschreibt das Einen Vergleich ausführen in Kapitel 16, Abfrageergebnisse und Statistik. Alle Dokumente werden gezählt, ob mit oder ohne Treffer; Dokumente ohne Treffer haben die Rate 0. Der Präsenztest zählt, wie viele Dokumente Treffer haben und wie viele keine. Damit der Test läuft, muss es also von beiden mindestens eines geben.
- Geben Sie zwei Gruppierungsschlüssel an, testet Vergleichen statt der einzelnen Dokumente die Tabelle, die sich aus den beiden Schlüsseln ergibt. Automatisch führt dann den Chi-Quadrat-Test nur aus, wenn unter Suchen Dokumente oder eine andere Einheit der Gruppe Bibliothek gewählt ist, während Chi-Quadrat auf Häufigkeiten und Präsenztest den Test auf den Tabellenzellen ausführen. Rangtest für Raten funktioniert nur mit einem Schlüssel.
- Die Code-Matrix testet jeden Code einzeln, unabhängig davon, was die beiden Umschalter zeigen. Die Nullhypothese lautet dabei, dass sich der Anteil der Dokumente mit dem jeweiligen Code zwischen den Gruppen nicht unterscheidet. Gruppen mit Kein Wert (bei Dokumentgruppen Nicht gruppiert) lässt der Test aus, während Vergleichen sie als eigene Gruppe behandelt. Kommt ein Code in allen oder in keinem der getesteten Dokumente vor, zeigen seine Testzellen einen Strich.
- Der Skizzenraum versieht eine Zelle nur dann mit einem *, wenn sie mindestens 3 Verbindungen enthält, mehr, als zu erwarten wäre. Außerdem muss dieser Unterschied so deutlich sein, dass der einseitige Test einen p-Wert unter 0,05 ergibt.
Wie Signifikanz angezeigt wird
Überall, wo LemmaLoom Signifikanz hervorhebt, gilt die Grenze p < 0,05. Die Darstellung unterscheidet sich je nach Ort:
- Vergleichen zeigt die Testzeile dunkler, wenn p unter 0,05 liegt, sonst grau. Die Statistik erscheint auf zwei Nachkommastellen gerundet, p-Wert und Effektstärke auf drei. Ein p unter 0,001 erscheint als p < 0,001.
- Die Code-Matrix zeigt die Testwerte eines Codes dunkler, wenn sie signifikant sind (p < 0,05), und hängt an den p-Wert ein * an. Statistik und Cramérs V erscheinen mit zwei Nachkommastellen, p-Werte mit drei, außer Werten unter 0,001, die als < 0,001 erscheinen.
- Beziehungen kennzeichnet signifikante Werte im Raster (mit einem * in der Ecke der Zelle) und unter Paare (mit einem * hinter dem p-Wert); unter Paare erscheinen p-Werte unter 0,05 außerdem dunkler.
- Die Facette Code-Statistik setzt ein * hinter die Namen eines Codepaars.
- Der Skizzenraum und der Modus Multimodus der Wortskizze setzen in den Zellen des Rasters ein * neben die Zahl. Eine Zeile unter dem Raster erklärt, was das Zeichen bedeutet.
In Schlüsselwortlisten werden alle Wörter ausgeblendet, die die im Menü, das LL ≥ 3,84 zeigt, gewählte Log-Likelihood nicht erreichen.
Kleine Gruppen
Bei wenigen Dokumenten kann der Rangtest keinen niedrigen p-Wert liefern, so groß der Unterschied auch erscheinen mag. Sein niedrigster p-Wert ergibt sich, wenn jedes Dokument der einen Gruppe einen höheren Rang hat als jedes Dokument der anderen:
| Dokumente in den beiden Gruppen | Kleinstes p | Größtes r |
|---|---|---|
| 2 und 2 | 0,121 | 0,775 |
| 3 und 2 | 0,083 | 0,775 |
| 4 und 2 | 0,064 | 0,756 |
| 4 und 3 | 0,034 | 0,802 |
| 6 und 4 | 0,011 | 0,809 |
| 7 und 4 | 0,008 | 0,798 |
| 10 und 10 | < 0,001 | 0,845 |
Das Set „Skeptiker“ enthält drei Print-Dokumente („Die Modelle liegen daneben“, „Netto-Null wird teuer“ und „Wissenschaft ist nie abgeschlossen“) und zwei Online-Dokumente („Keine Panik“ und „Wer bezahlt die Wende“). Solange keine zwei dieser Dokumente dieselbe Rate haben, kann ein Rangtest nach Gruppe in diesem Set keinen p-Wert unter 0,083 ergeben. Eine graue Testzeile ist dort allein wegen der Zahl der Dokumente im Set zu erwarten, selbst wenn sich die Skeptiker in Print- und Online-Medien deutlich darin unterscheiden, wie häufig sie Heckenausdrücke verwenden. Die Zahlen der Tabelle setzen voraus, dass keine zwei Dokumente dieselbe Rate haben; gleiche Raten können p deutlich senken und r deutlich erhöhen. Bei vier Dokumenten ohne Treffer gegen zwei Dokumente mit unterschiedlichen Raten ist p zum Beispiel 0,028 und r 0,894.
Auch der größtmögliche Wert von r hängt von der Größe der beiden Gruppen ab. Ohne gleiche Raten erreicht er nie 0,87 und bleibt weit darunter, wenn sich die Gruppen in ihrer Größe stark unterscheiden.