文本检查器
检查器中的文本标签页从整体上描述当前文档。这个标签页有三个分面。概览显示文档的统计数据,包括句数和词数、可读性数值、词汇、句子结构,以及词类频次、语法功能和短语数量的图表。详细信息包含与文档关联的属性值和标签,书签则显示你在文档中加了书签的段落。
统计数据只描述文本的表层。它们可以帮你描述文档,帮你挑选需要细读的文档,还能帮你发现数据集中的异常(例如从头到尾没有断句的转写文本)。但统计数据无法告诉你作者写作时的意图,也无法解释两篇评论文章为什么不同。
关键术语
LemmaLoom 为文档建立索引时,会把文档切分成句子和词符;词符指单个的词和标点符号(见第 21 章“分析与索引”)。统计数据都由这种切分得出。
- 词指不属于标点或符号的任何词符。数字词符也算作词。
- LemmaLoom 按每个词的词典形式(即词元)识别不同词:model 和 models 算作一个不同词,was 和 were 也是如此。在语言学文献中,这类单位称为类符(type),“类符形符比”一词即由此而来。
- 音节数是仅根据每个词的拼写作出的粗略估计。
- LemmaLoom 把超过六个字母的词定义为长词。
- 停用词是每种语言预先确定的词表中的词,指 the、of 和 is 这类常用词。不在表中的词称为实义词。
- 比例指以百分数表示的比值。例如,30 个词中有 17 个停用词,比例为 ,显示为 57%。
打开文本标签页
本章的示例来自本指南附带的示例项目“气候辩论”;选取文件 ▸ 导入 ▸ 示例项目,即可把它添加到你的资料库中(见第 1 章“简介”中的示例项目)。下图是“时间不多了”的文本标签页,这是一篇出自活动人士之手的评论文章,共有 964 个词,分布在 63 个句子中。
概览分面只有一列。它从上到下依次是五个度量部分(即概览、可读性、词汇、句法和结构),接着是三个条形图(词类、句法功能和短语)。第一个部分与分面同名,也叫概览,包含与文本有关的简单计数。
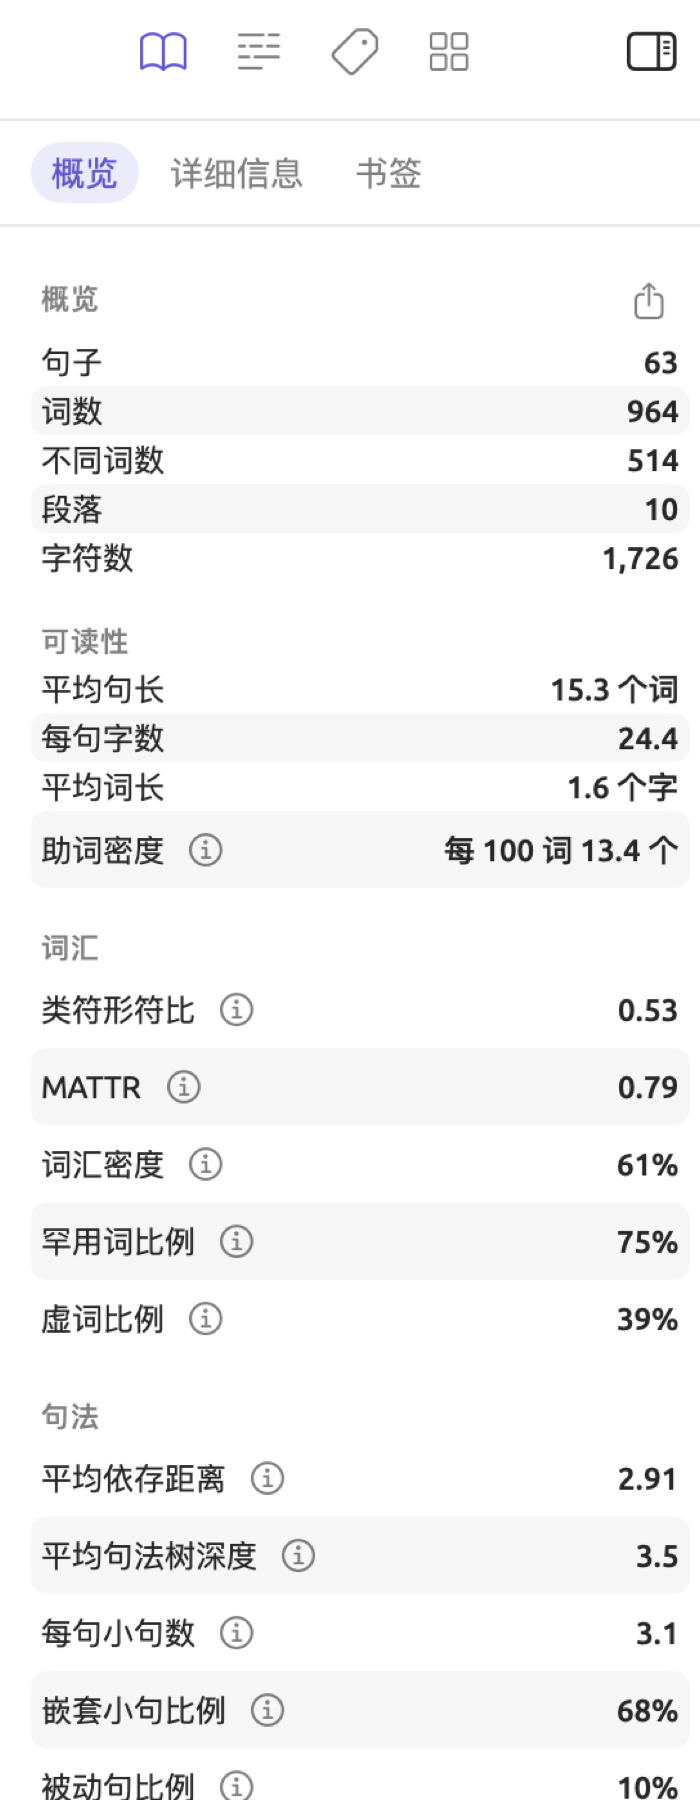
要打开文本标签页:
- 在阅读器中打开一个文档。
- 如果检查器处于隐藏状态,请选取显示 ▸ 显示/隐藏检查器(⌃⌘I)。
- 点按检查器顶部的书本图标,或者选取显示 ▸ 检查器 ▸ 文本(⌥⌘1)。
- 在图标下方的那排分面中,点按概览、详细信息或书签。
默认情况下,文档会显示文本标签页和概览分面,直到你手动更改为止。你在文档标签页之间切换时,每个文档会各自记住你对标签页和分面所做的更改。在分屏浏览中并排查看文档时,检查器显示当前窗格中的文档。点按另一个窗格,就能查看另一个文档的统计数据,而之前选中的标签页和分面保持不变。当前标签页是详细视图或文档集时,检查器保持关闭;每个单独的文档窗口都有各自的检查器。
统计数据只有在文档建立索引后才会显示。如果文本的第一部分还没有完成索引,你会看到占位文字索引完成后即可查看统计数据。无论统计数据是否已经可用,详细信息分面都照常工作。索引进行期间,统计数据只涵盖已经处理的部分。只有英语、德语和汉语文档才有文档统计数据;其他语言的文档会一直显示这条占位文字。
详细信息分面
示例项目“气候辩论”中的每个文档都有四个属性的值。“立场”属性的值表明文本出自活动人士、怀疑论者还是中立的一方。“读者数”“发表日期”和“媒体”分别表示受众规模、文章的发表时间和发表的媒体。在“时间不多了”文档的详细信息分面中,属性显示“立场”为“行动派”,“读者数”为 412,000,“发表日期”为 2024 年 8 月 21 日,“媒体”为“北方先驱报”。属性部分下方的标签中列出了这个文档唯一的标签“评论”。
属性列出当前文档已有的每个属性及其值,并为这些属性提供编辑栏。浏览单个文档时,你可以在这里为它填写和修改属性值。要同时为多个文档设置属性值,请参阅第 8 章“文档集、分组、标签和属性”中的为多个文档设置同一个值。
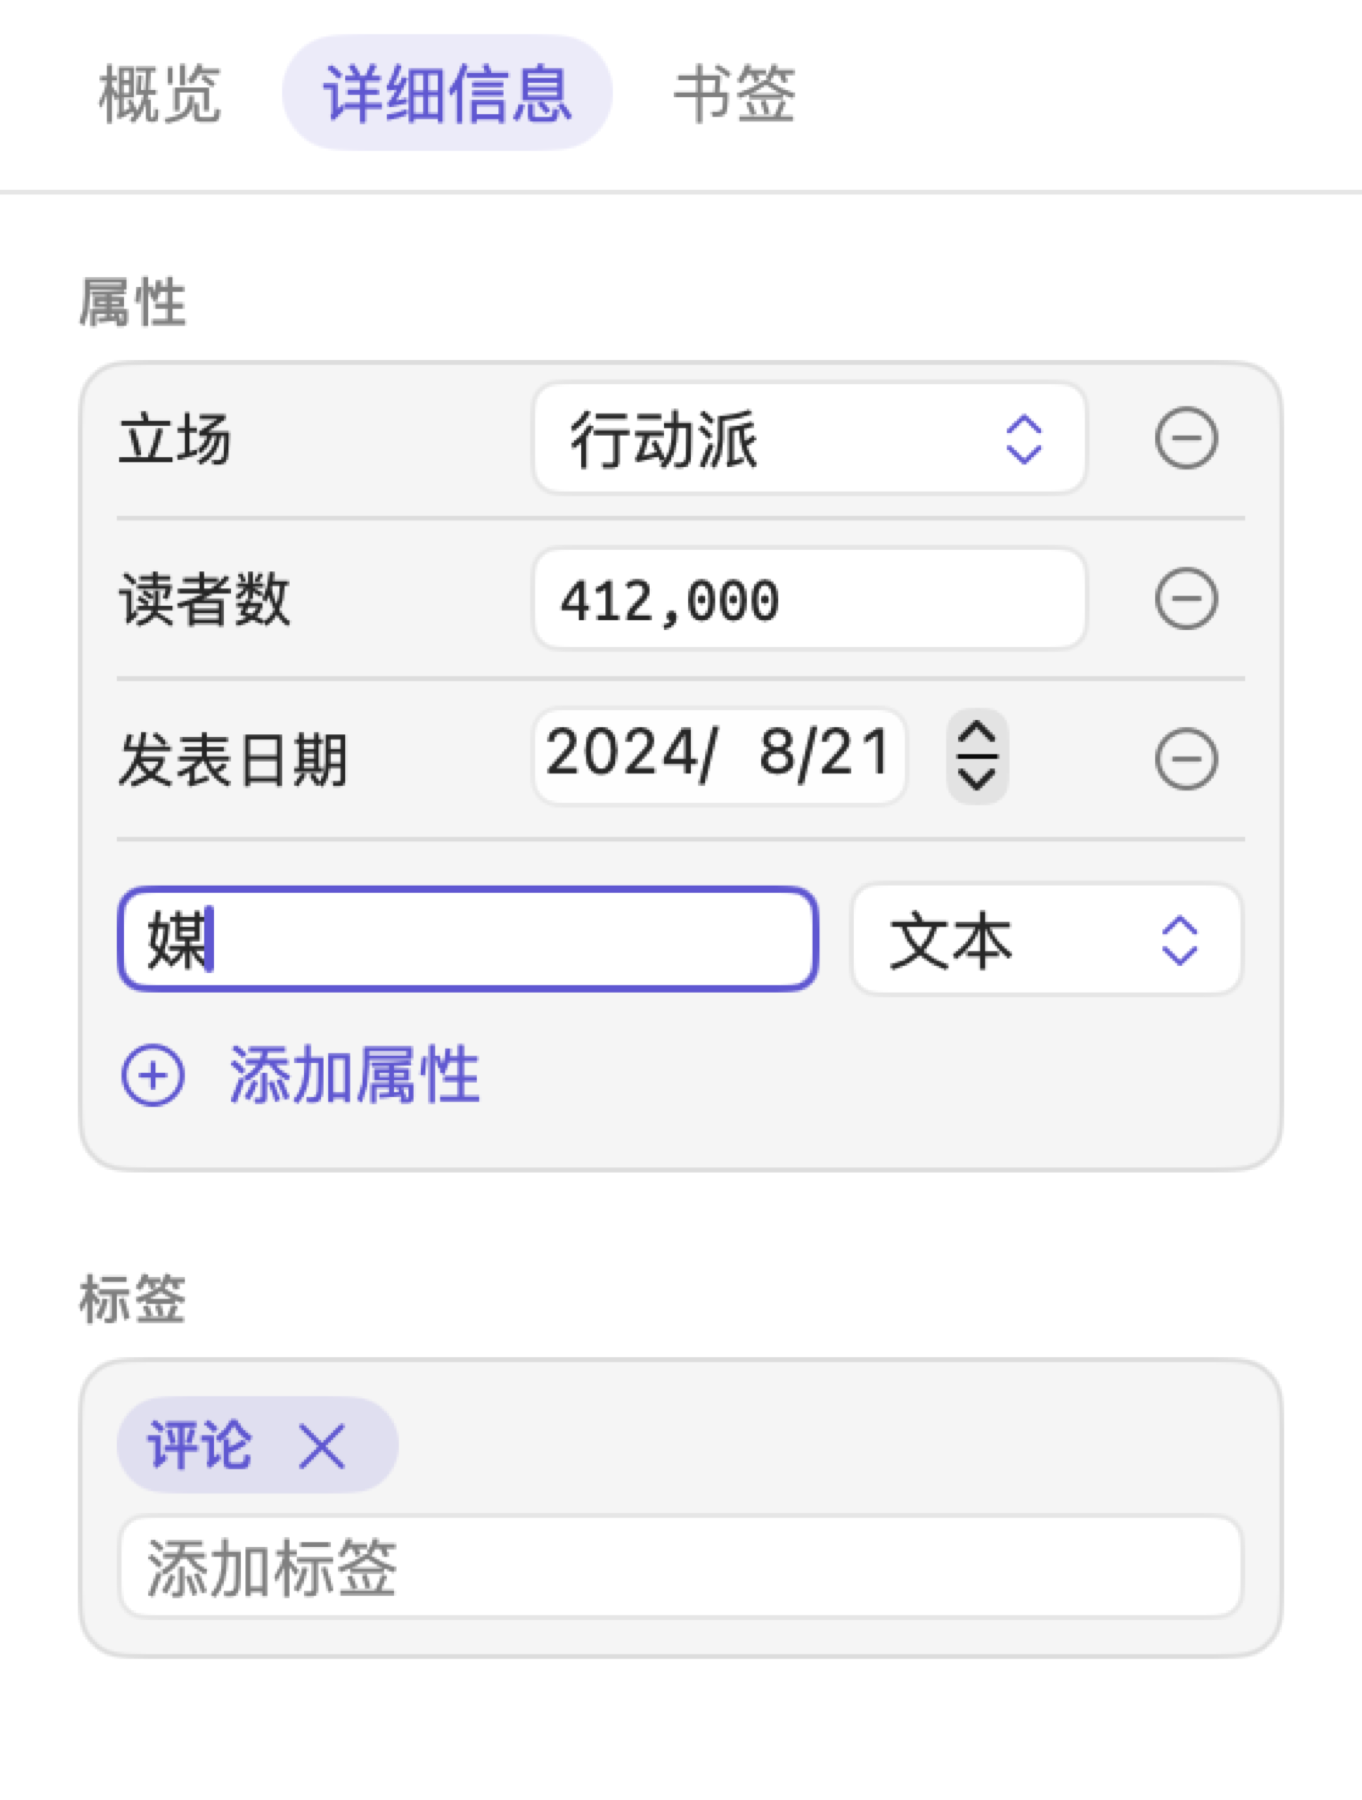
要为文档中尚未列出的属性设置值:
- 在列表下方的栏中输入属性的名称。LemmaLoom 会提示你的项目中已经在用的名称,并附上类型,例如“发表日期” · 日期。
- 如果项目中没有这个名称的属性,请选取类型。如果是选择器,还要输入它的选项,每行一个。
- 点按添加属性,或者按下 Return 键。
- 在新出现的一行中输入值。
每个属性在一个文档中只列出一次。如果你试图添加文档中已经列出的属性,添加属性会保持不可用,它的提示文字为已添加。
要清除某个值,请点按该值所在行末尾的移除按钮(移除属性)。标签在显示添加标签的栏中输入。输入所需的标签后按下 Return 键;也可以在标签后输入英文逗号,接着输入下一个。输入时会出现已有标签的建议。要删除标签,点按标签上的 ×。
所有编辑都会立即生效,并且同样作用于文档的译文。编辑值和标签都可以撤销,分别使用编辑 ▸ 撤销设置值和编辑 ▸ 撤销编辑标签(⌘Z);要撤销新添加的属性,请使用编辑 ▸ 撤销添加属性。关于填写值和为文档添加标签的更多内容,请参阅第 8 章“文档集、分组、标签和属性”。
统计数据一览
显示哪些度量取决于文档的语言。其中大多数在英语、德语和汉语文档中都相同,但可读性公式各不相同,因为大多数公式在制定时只考虑了一种语言。
| 部分 | 度量 | 英语 | 德语 | 汉语 |
|---|---|---|---|---|
| 概览 | 句子、词数、不同词数、段落、字符数 | 有 | 有 | 有 |
| 可读性 | 平均句长 | 有 | 有 | 有 |
| Flesch 易读度、Flesch-Kincaid 年级、Gunning Fog 指数、SMOG 指数、Coleman-Liau 指数、ARI 指数 | 有 | |||
| Flesch-Amstad 指数、维也纳实用文公式 | 有 | |||
| LIX 指数 | 有 | 有 | ||
| 每句字数、平均词长(按字计)、助词密度 | 有 | |||
| 词汇 | 类符形符比、MATTR、词汇密度、罕用词比例、虚词比例 | 有 | 有 | 有 |
| 平均词长(按字母计) | 有 | 有 | ||
| 句法 | 平均依存距离、平均句法树深度、每句小句数、嵌套小句比例、被动句比例 | 有 | 有 | 有 |
| 结构 | 对话比例、疑问句与感叹句、每段句数 | 有 | 有 | 有 |
句法部分只列出语法分析所提供的度量。如果文档中句子的语法结构未知,就不显示这个部分。
所有数值都经过四舍五入后显示。计数和 LIX 指数是整数。类符形符比、MATTR 和平均依存距离保留两位小数。罕用词比例和各项比例显示为整数百分比。其余度量保留一位小数。
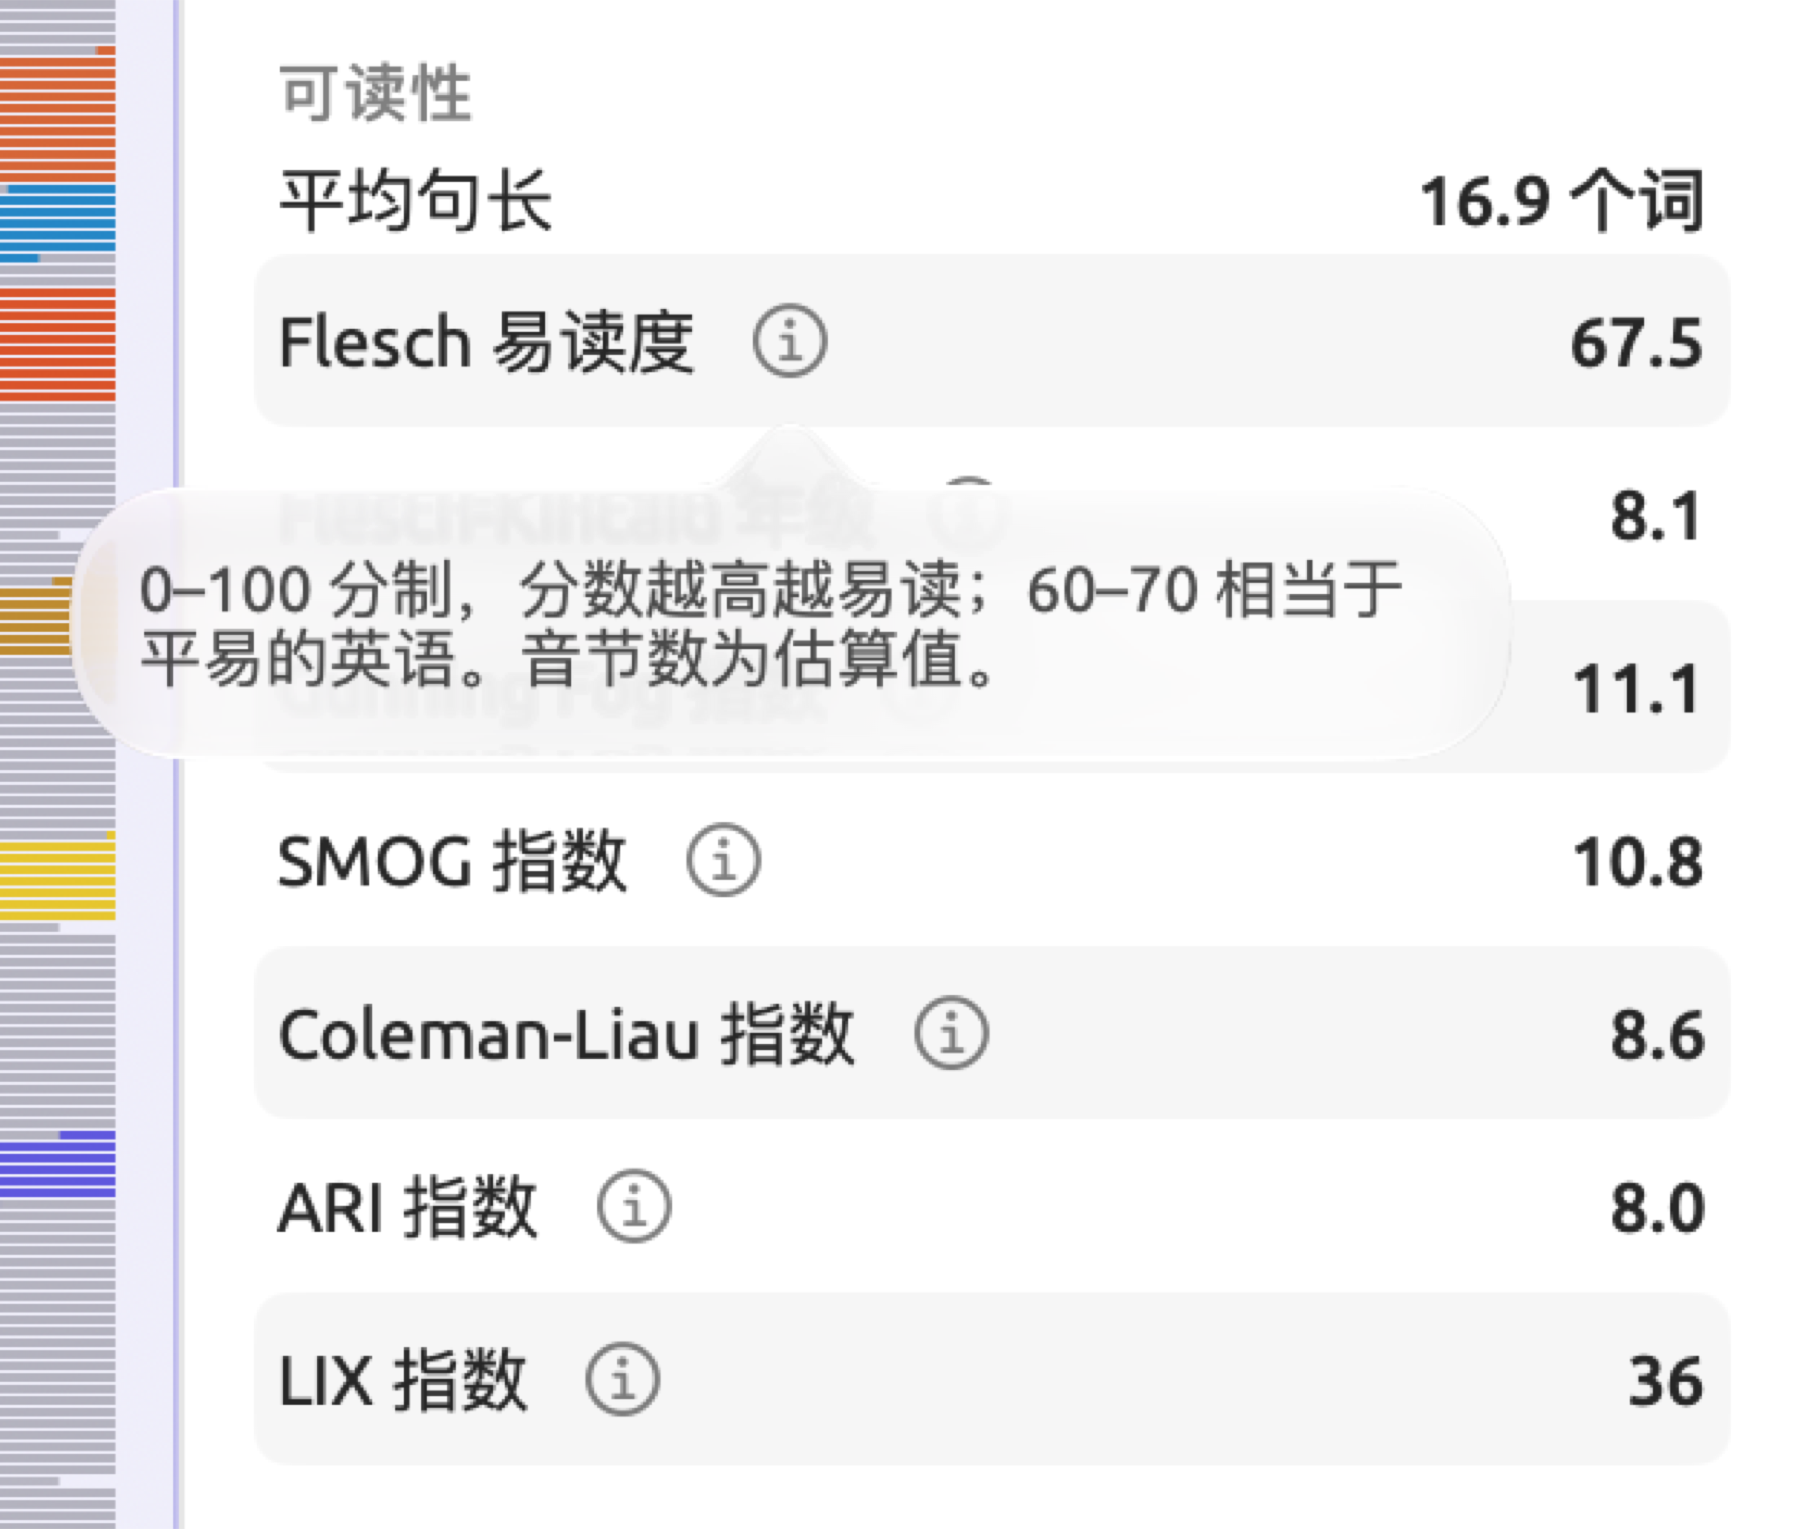
许多度量的名称旁边有一个 ⓘ 按钮。点按它可以看到简短的说明,介绍这项度量表示什么以及它的标度;点按其他地方即可关闭。
导出统计数据
要把文档的全部统计数据导出到一个文件中:
- 在概览分面中,找到概览部分的标题,它位于分面顶部。
- 点按标题右侧的导出按钮(导出为 CSV)。
- 输入名称,选择文件夹,然后点按保存。建议的名称是文档标题后接
-statistics,例如时间不多了-statistics.csv。
文件有部分、度量和值三列;显示的每个度量占一行,三个图表的每个条形也各占一行。值的写法与检查器中的显示相同(包括四舍五入和单位),例如 57% 或 10.0 个词。
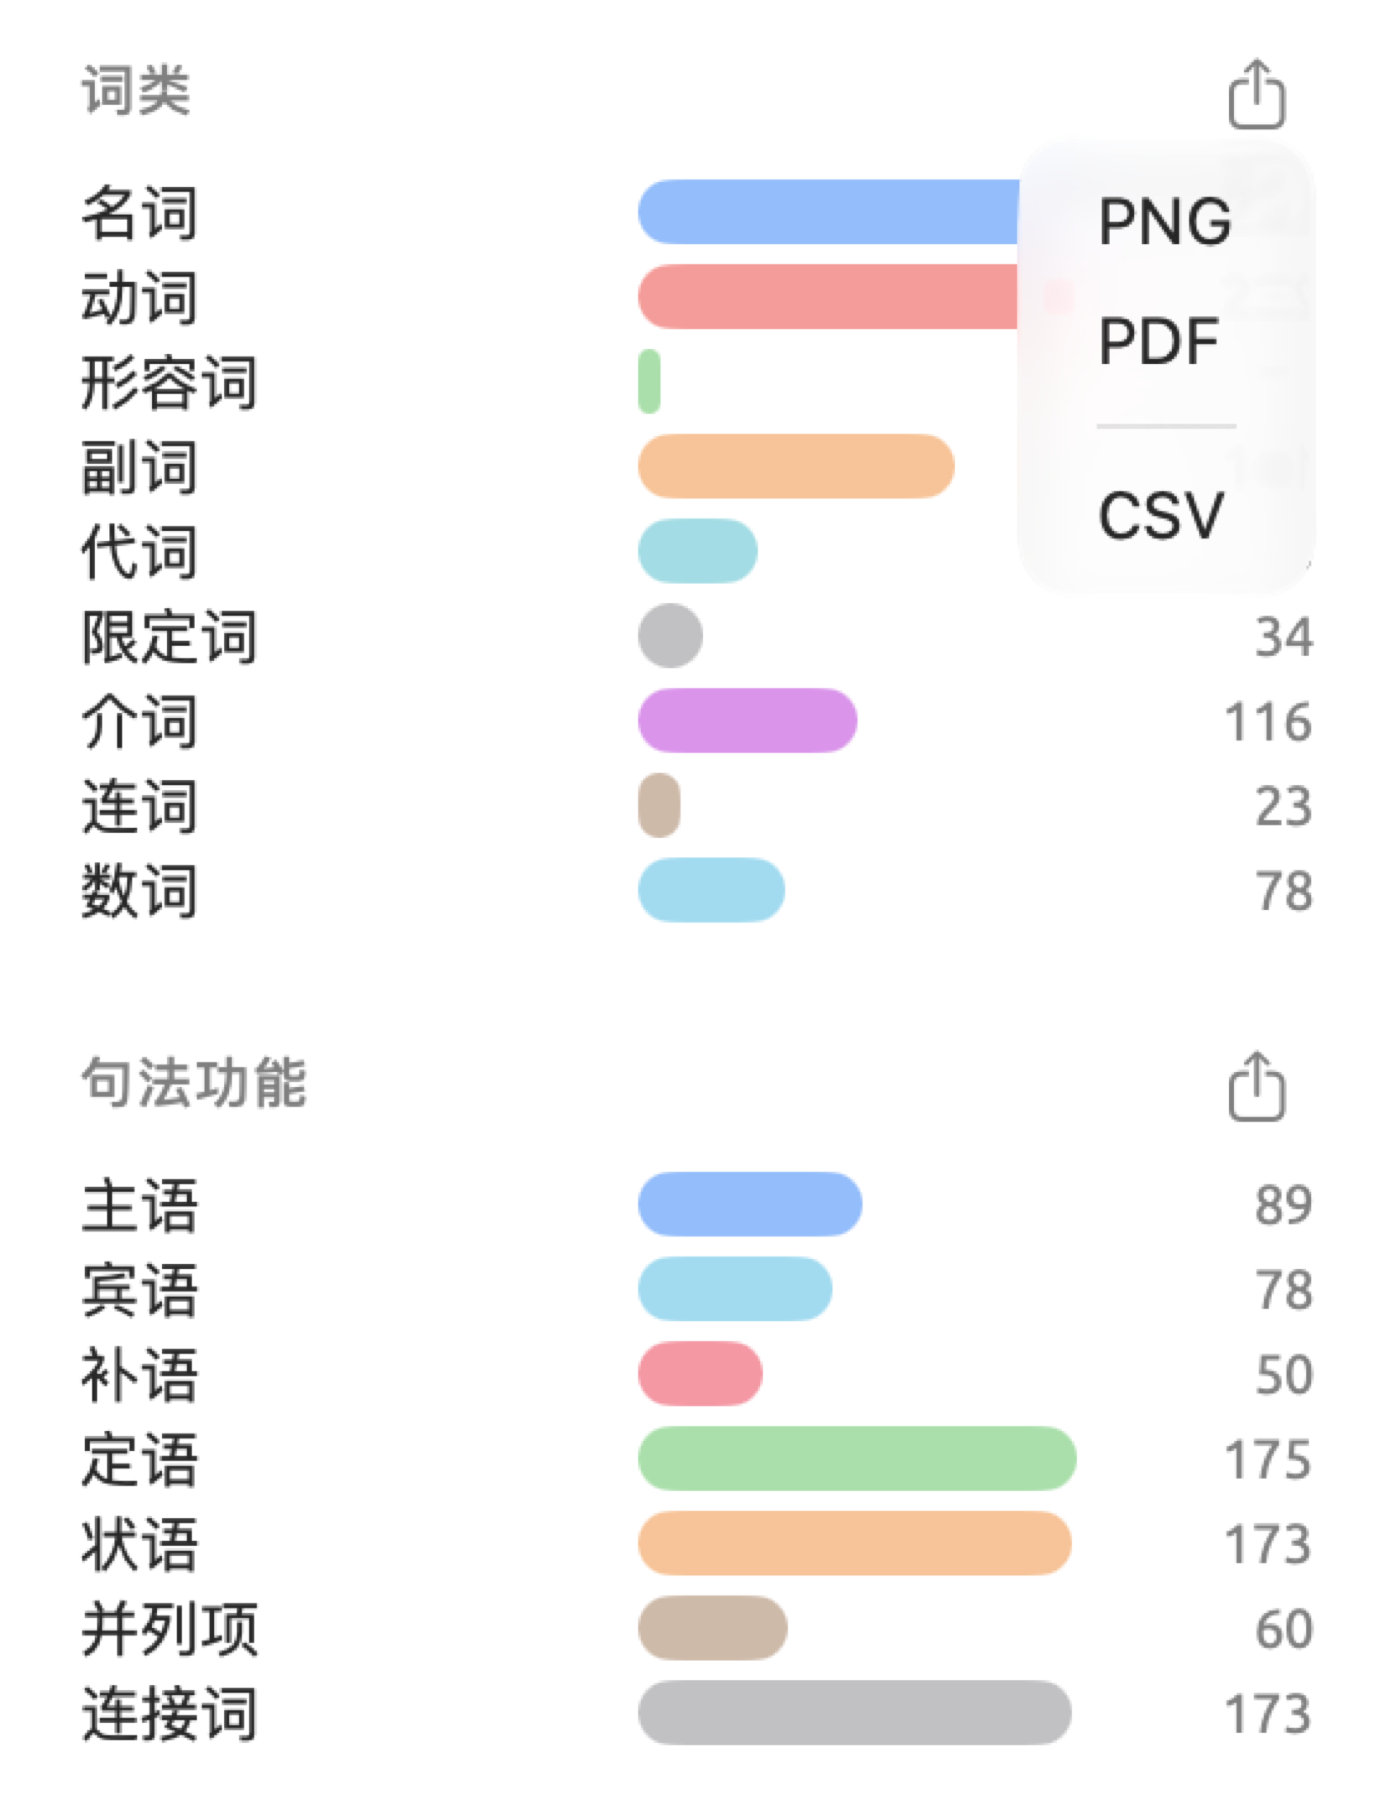
每个图表标题的右侧都有一个导出按钮。点按它会打开一个菜单,其中的 PNG 和 PDF 用来导出图表(带有图表标题),CSV 只导出各类别的数量(分为类别和数量两列)。
建议的名称由文档标题和图表标题组合而成,例如 时间不多了-词类.png。
检查器一次只能显示一个文档。要把多个文档的统计数字汇总到电子表格中进行比较,请先把每个文档分别导出到单独的文件,再合并这些文件,并在计算之前去掉单位符号和百分号。
按统计量查找文档
上表中的每个度量都可以用作查询的规则。这类查询可以帮你挑出符合该规则的特定文档,例如比平易的英语更难读的文档,或者被动句比例特别高的文档。
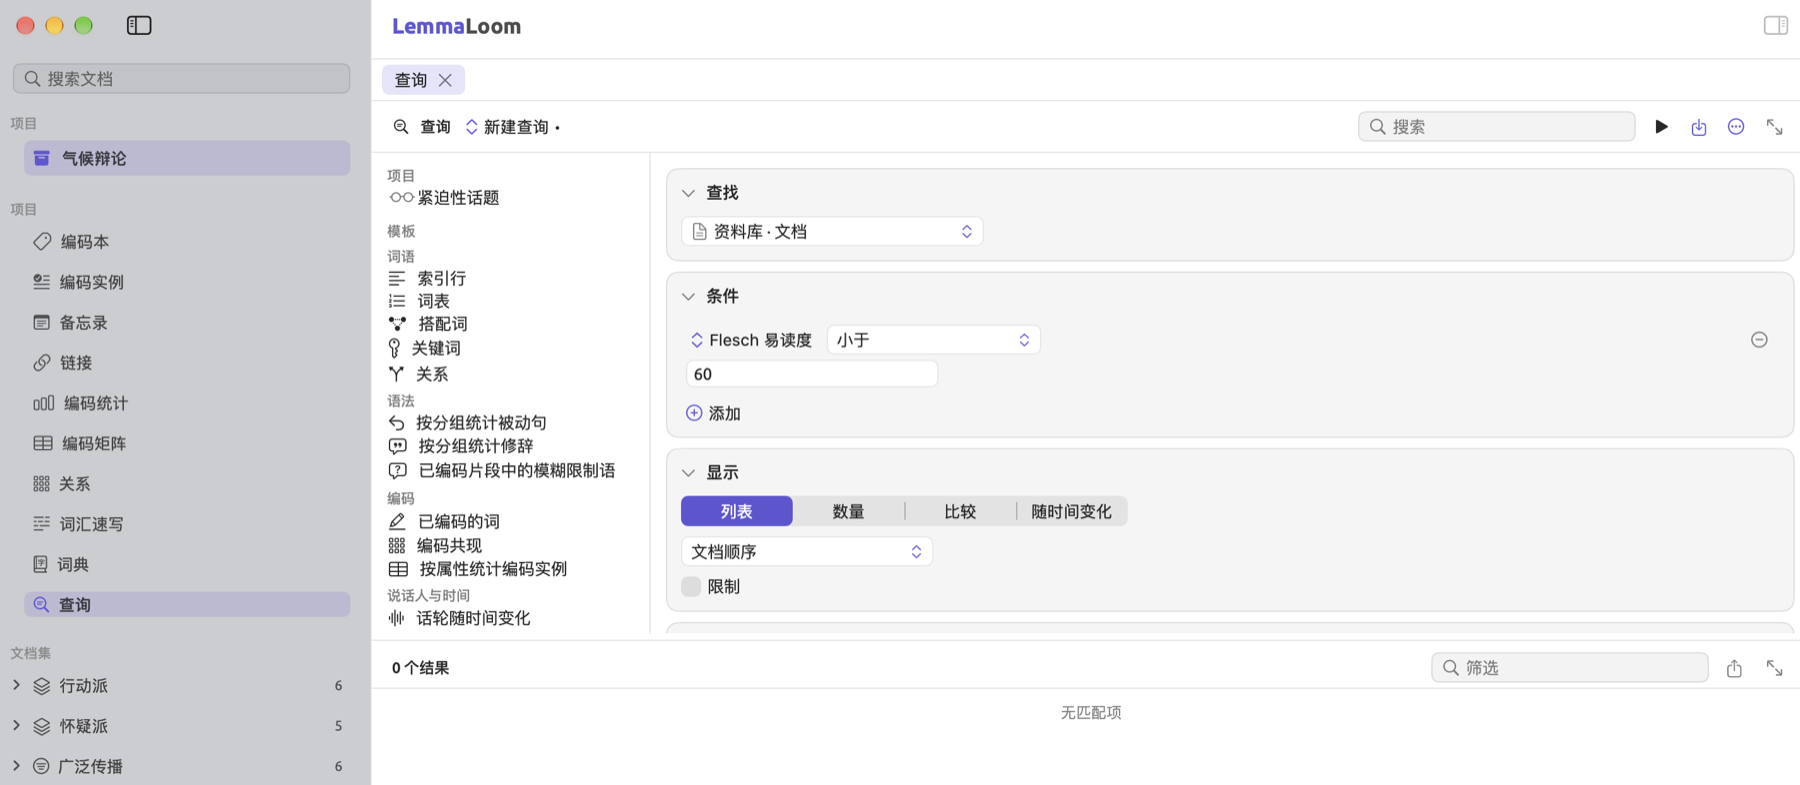
下图是“气候辩论”项目中的这样一个查询,它查找 Flesch 易读度低于 60(Flesch 所说的平易英语区间的下限)的文档。在这个项目中,查询显示无匹配项:Flesch 易读度只针对英语文档计算,而项目中唯一的英语文档是译文“时间不多了 (英语)”;只要语料设为原文,它就不在查询范围之内,而且它的 67.5 分本来也高于 60。
要按统计量查询文档:
- 在导航栏中,点按项目下的查询。
- 在查找中选取资料库 · 文档。
- 在条件中点按添加,然后选取添加规则。
- 点按字段,选取统计量,再选取度量,例如 Flesch 易读度。
- 选取比较方式,例如小于,然后在值中输入数字。
查询中的统计量字段有以下几条规则:
- 统计量字段只能用于针对文档集、项目和所有项目的查询。查询提供全部统计量字段,而智能文档集中只有词符、句子和字符数这几个统计量字段,LemmaLoom 在文档建立索引后就会记录这些值。词符连标点符号也计算在内,所以词符会比词数多。每个统计量字段在哪里提供,请参阅第 15 章“构建查询”中的字段。
- 查询比较的是未经四舍五入的数值。例如,显示为 86.7 的分数实际上可能是 86.705,所以请使用小于、至少为或介于之类的比较方式,而不要用是。
- 以百分比显示的度量(包括罕用词比例)在查询中表示为 0 到 1 之间的小数。要查找词汇密度至少为 45% 的文档,应输入
0.45。 - 规则会跳过在其度量上没有值的文档。Flesch 易读度之类的度量只针对英语文档计算,所以像小于
60这样的规则在求值时会跳过所有非英语文档。正在建立索引的文档不参与求值,直到它们的统计数据可用为止。
统计数据何时计算
LemmaLoom 会计算文档的统计数据,并与文档一起保存。文本标签页和查询中的统计量字段都使用这些统计数据,所以两者显示的数字始终一致。即使阅读器只显示有标注的句子,文档统计数据也针对整个文档(见第 6 章“透镜”中的只显示有标注的句子)。
只有当文档的文本或索引设置发生变化时,LemmaLoom 才会重新计算统计数据。这类变化包括编辑并存储文档的文本、更改文档的语言设置,以及修改把文本排除在索引之外的模式。如果你打开文本标签页时统计数据尚未算出,会短暂显示一个旋转图标,直到 LemmaLoom 处理完毕。
译文文档(例如“时间不多了 (英语)”)的统计数据属于译文文档本身,并按译文语言的度量计算。
计数
概览部分列出五项:
| 度量 | 统计的内容 |
|---|---|
| 句子 | 句子,以索引的切分为准 |
| 词数 | 词,不含标点和符号 |
| 不同词数 | 词中互不相同的词元 |
| 段落 | 段落,以空行或换行分隔 |
| 字符数 | 文本中的每个字符,包括空格、换行和标点 |
词数和不同词数
词是指去掉标点符号和特殊字符之后的索引词符,以索引在相应语言中对词符的界定为准。例如在英语中,索引会拆开缩约形式(don’t = do + n’t),带连字符的词会在连字符这个标点处拆开(eighty-four = eighty + four)。汉语书面文本的词与词之间没有分隔,所以计数时由索引决定一个词在哪里结束、下一个词从哪里开始。
不同词数忽略大小写,所以 The(句首大写)和 the(句中)算作同一个不同词。
被排除在索引之外的文本(例如转写文本中的时间戳)只计入字符数,自成一个段落时还计入段落(见第 21 章“分析与索引”中的排除在分析之外的文本)。
句子和段落
在书面文本中,句子的边界通常由句号、问号和感叹号标示。在转写文本中,转写时在哪里加上这类标点,哪里就是句子边界。
段落的划分取决于文本中的换行。如果文本中任何地方有空行,就以空行分隔段落,只隔着一个换行的相邻几行则构成同一个段落。否则,每个换行都会开始一个新段落。空行指只含空白字符的行。在 LemmaLoom 生成的转写文本中,每当说话人改变,或者出现超过 1.5 秒的停顿,都会自动插入段落分隔。
字母、字符和音节
字母数统计文本中的每个字母,汉字也计算在内。数字、标点符号和撇号不计入字母数。在所有可读性公式中,只有 ARI 指数把字母和数字一起计算。
音节数的估算方法是统计词中连在一起的元音组。元音包括 a、e、i、o 和 u 五个字母,英语和德语中还有字母 y,德语中还有变元音 ä、ö 和 ü。例如 heat 含有 ea,again 含有 a 和 ai,families 含有 a、i 和 ie。估算英语音节数时,跟在其他元音组之后的词尾 e 被视为不发音,以 le 结尾的词除外。因此,wave 和 were 这样的词估算为一个音节,而 people 是两个音节。每个词至少有一个音节,所以即使是没有元音的 2050 也算一个音节。
出错的例子有 warned,它因为 -ed 词尾被估算为两个音节;还有 science,它被估算为一个音节,而不是两个。像 mayor 这样 a、y、o 三个元音相连的词也会出错,它被估算为一个音节。在德语中,Familien 因为含有元音组 ie,被错误地算成三个音节。为整个文档计算总分时,这类错误在实际中可能部分相互抵消。
示例段落
下面几节给出示例。这些示例使用一段虚构的文字,内容与你在行动派文章中可能读到的相似。计算时把下面这段文字当作一个完整的文档。
We were hit by the heat again this summer. So the schools shut for a week and nobody could sleep. The families felt that our mayor had already given up.
它的计数如下:
| 句子 | 词数 | 音节数 | 字母数 | 长词数 | 三音节及以上的词数 | 单音节词数 |
|---|---|---|---|---|---|---|
| We were hit by the heat again this summer. | 9 | 11 | 33 | 0 | 0 | 7 |
| So the schools shut for a week and nobody could sleep. | 11 | 13 | 43 | 1 | 1 | 10 |
| The families felt that our mayor had already given up. | 10 | 15 | 44 | 2 | 2 | 7 |
| 整段 | 30 | 39 | 120 | 3 | 3 | 24 |
长词是 schools、families 和 already。三音节的词是 nobody、families 和 already。音节数中,mayor 按估算的 1 个音节计入(它实际上有 2 个音节)。这段文字中没有数字,所以字母数加上数字数仍是 120。the 重复出现了三次,因此不同词数是 28。
可读性
可读性公式只根据两个指标(句子的长度和词的长度)来计算文本读起来有多容易,这两个指标都比较容易从文本中客观地提取。句子越长,对工作记忆的要求越高,所以长句更难读。词越长,往往也越少见、越抽象。研究者把测试文本交给受试者(例如在校儿童)阅读,评估他们的理解能力,从而找出这两种长度与理解程度之间的关系。公式中那些看似古怪又十分精确的常数(例如 206.835),就来自用数学函数拟合这些观察结果。
在研究中,你可以用可读性分数把某个媒体机构的文本与其他机构的文本相比较,甚至评估辩论中哪一方使用的语言结构比另一方更简单或更复杂。
某些公式给出的年级,表示需要上几年学,才能不费太大力气、不产生明显困惑地读懂这段文本。如果没有注明其他学制,年级都指美国的教育体系,其中 8 年级大致相当于 13 或 14 岁。
即使一个句子完全由短词组成,也仍可能难以理解;而读者熟悉、能够理解的专业词汇,在这些公式中照样按长度计算,与读者对术语的实际理解无关。
可读性公式中的符号如下:
| 符号 | 含义 | 在示例段落中 |
|---|---|---|
| 词数 | 30 | |
| 句数 | 3 | |
| 音节数 | 39 | |
| 字母数 | 120 | |
| 字母和数字 | 120 | |
| 三音节及以上的词数 | 3 | |
| 长词数(超过六个字母) | 3 | |
| 单音节词数 | 24 |
有两个量会反复出现。 指每句的平均词数,这里 = 30 ÷ 3 = 10。 表示每个词的平均音节数,这里 = 39 ÷ 30 = 1.3。
平均句长
平均句长是每句的平均词数,按 计算。三种语言都提供这项度量,例如示例段落的平均句长为 10.0 个词。下面介绍的大多数评分指标都依赖这个统计量,所以它在很大程度上决定了这些指标的表现。把一个长句拆成两句,各项分数都会显示文本变得更容易读。
Flesch 易读度
Flesch 易读度由 Rudolf Flesch 提出,是一种针对英语文本的评分方法,依据的是文本的平均句长和每个词的平均音节数。它的数值通常在 0 到 100 之间,数值越高,文本越容易读。公式如下:
、 和 是你的文本在上表中的各项指标。实际上,起始分数相当高,但公式会因为句子长、词的音节多而扣分。音节的分量远远大于句长;平均每词音节数每增加 0.1,大约扣 8.5 分,大致相当于平均句长增加 8 个词。
在这个例子中:
检查器显示 86.7。Rudolf Flesch 把他的分数划分为以下区间:
| 分数 | 描述 |
|---|---|
| 90–100 | 非常容易 |
| 80–90 | 容易 |
| 70–80 | 比较容易 |
| 60–70 | 标准;平易的英语 |
| 50–60 | 比较难 |
| 30–50 | 难 |
| 0–30 | 非常难 |
这里的分数是 86.7,说明这段文字容易读。这在意料之中,因为句子都比较短,而且大多由单音节词组成。本章后文图中的“时间不多了 (英语)”得 67.5 分,属于标准难度。句子非常长的文本得分可能低于 0,词非常短的文本得分则可能高于 100。
Flesch-Kincaid 年级
Flesch-Kincaid 年级指数是为美国海军使用的教学手册而制定的,它使用与 Flesch 易读度相同的两个指标,但把它们换算成美国教育体系中的年级。
代入数字得到:
四舍五入到十分位后为 3.7,相当于三、四年级学生能够读懂的年级水平。由于 Flesch-Kincaid 年级公式和 Flesch 易读度依赖相同的指标,一项得分高通常意味着另一项得分低。
Gunning Fog 指数
Robert Gunning 的 Fog 指数试图根据句子长度和用词难度,估计读懂文档所需达到的年级水平。按照 Gunning 的定义,难词包括所有三个及以上音节的词,但不包括由常见成分组成的复合词、名称,以及仅靠 -ed 之类的词尾才达到三个音节的词。
是难词的数量;LemmaLoom 只排除名称,即索引标记为专有名词的词,例如 Larkhaven。乘以 100 是把难词的比例换算成百分数。
示例段落中有三个难词(nobody、families 和 already),没有任何名称。计算结果为:
Fog 指数为 8,表示大约需要 8 年的学校教育;12 相当于美国高中的最后一年。由于公式的第二部分只考虑三个及以上音节的词,少数几个这样的词就会对结果产生相当大的影响。
SMOG 指数
SMOG 年级(Simple Measure of Gobbledygook,意为“官样文章的简易度量”)由 G. Harry McLaughlin 提出。这项可读性度量要统计三个及以上音节的词,McLaughlin 是在 30 个句子的样本中统计的。在 LemmaLoom 中,这项计算在整个文档上进行,再把结果换算到 30 个句子。
这里的 表示三个及以上音节的词数。因为取了平方根,随着这类词增多,年级上升得越来越慢。
例如,上面的示例段落在 3 个句子中有 个三音节及以上的词。换算到 30 个句子,就是 :
SMOG 年级指数衡量的是人们能完全读懂一篇文字的年级水平。因此,对同一段文字,它通常应高于 Flesch-Kincaid 年级(8.8 对 3.7)。在较短的文字中,三音节及以上的词分量很重,所以这段文字的结果偏高。
Coleman-Liau 指数
Coleman-Liau 指数与上面的可读性指数不同,它根据字母数而不是音节数来预测年级。便于计算机处理是它设计时的关键考虑,所以它不去估算可能出错的音节数,而是统计确切的字母数。
公式中的 指每百词的字母数, 指每百词的句数。每个词的字母越多,预测的年级越高;每百词的句子越多(即句子越短),预测的年级越低。
以示例段落为例,它的 120 个字母和 3 个句子相当于每 100 个词 400 个字母和 10 个句子:
预测的年级介于四年级和五年级之间。
ARI 指数
与 Coleman-Liau 指数类似,自动可读性指数(Automated Readability Index)不使用音节,而是根据每个词的字符数计算相应的美国学校年级。这里的字符包括字母和数字(即上表中的变量 )。
如果 ,,那么:
ARI 在计算中包括数字,而 Coleman-Liau 指数忽略数字,所以一份像“2024 热浪报告”那样含有大量数字的英语文档,在 ARI 上得到的年级会比在 Coleman-Liau 指数上相对更高。
LIX 指数
Carl-Hugo Björnsson 的可读性指数(Läsbarhetsindex),简称 LIX,是一段文字的平均句长与长词百分比之和。英语和德语文本都提供这项度量。它的数学表达式如下:
上式中的 是这段文字中长词的总数。示例段落的 30 个词中有 3 个长词:
它的范围大致从 20(非常容易)到 60(非常难),一般情况为 40(中等难度)。示例段落得 20 分,所以算作非常容易。
由于 LIX 按字母数而不是音节数判断长词,无论哪种语言,计算 LIX 的算法都完全相同。然而,不同语言之间无法比较 LIX 值。德语把复合名词连写成一个词(例如 heat wave 写作 Hitzewelle),这是同一篇文本的德语版本得分往往高于英语版本的原因之一。例如,英文示例段落得 20 分,而它的德语版本(见下文)有九个长词,得分为 。
Flesch-Amstad 指数(德语)
Toni Amstad 把 Flesch 易读度的标度推广到德语文本;德语的词往往含有更多音节。与 Flesch 易读度公式类似,结果通常在 0 到 100 之间,数值越大表示越容易读。
德语的算例使用示例段落的这个德语改写版本:
Auch in diesem Sommer hat uns die Hitze wieder getroffen. Die Schulen blieben eine Woche zu, und niemand konnte schlafen. Die Familien glaubten, dass unser Bürgermeister schon längst aufgegeben hatte.
| 计数 | 值 |
|---|---|
| 词数 | 30 |
| 句数 | 3 |
| 音节数 | 54 |
| 字母数 | 166 |
| 三音节及以上的词 | 4(getroffen、Familien、Bürgermeister、aufgegeben) |
| 长词 | 9(getroffen、Schulen、blieben、niemand、schlafen、Familien、glaubten、Bürgermeister、aufgegeben) |
| 单音节词 | 12 |
音节估算把 Familien 算成三个音节,尽管它实际上有四个。代入 :
按照 Flesch 的分数表(其区间在这里同样适用),这个德语版本属于标准难度。把这个数字与前面英语版本的 86.7 相比较,并不能说明哪个版本更容易读,因为两个公式是针对不同语言拟合的。
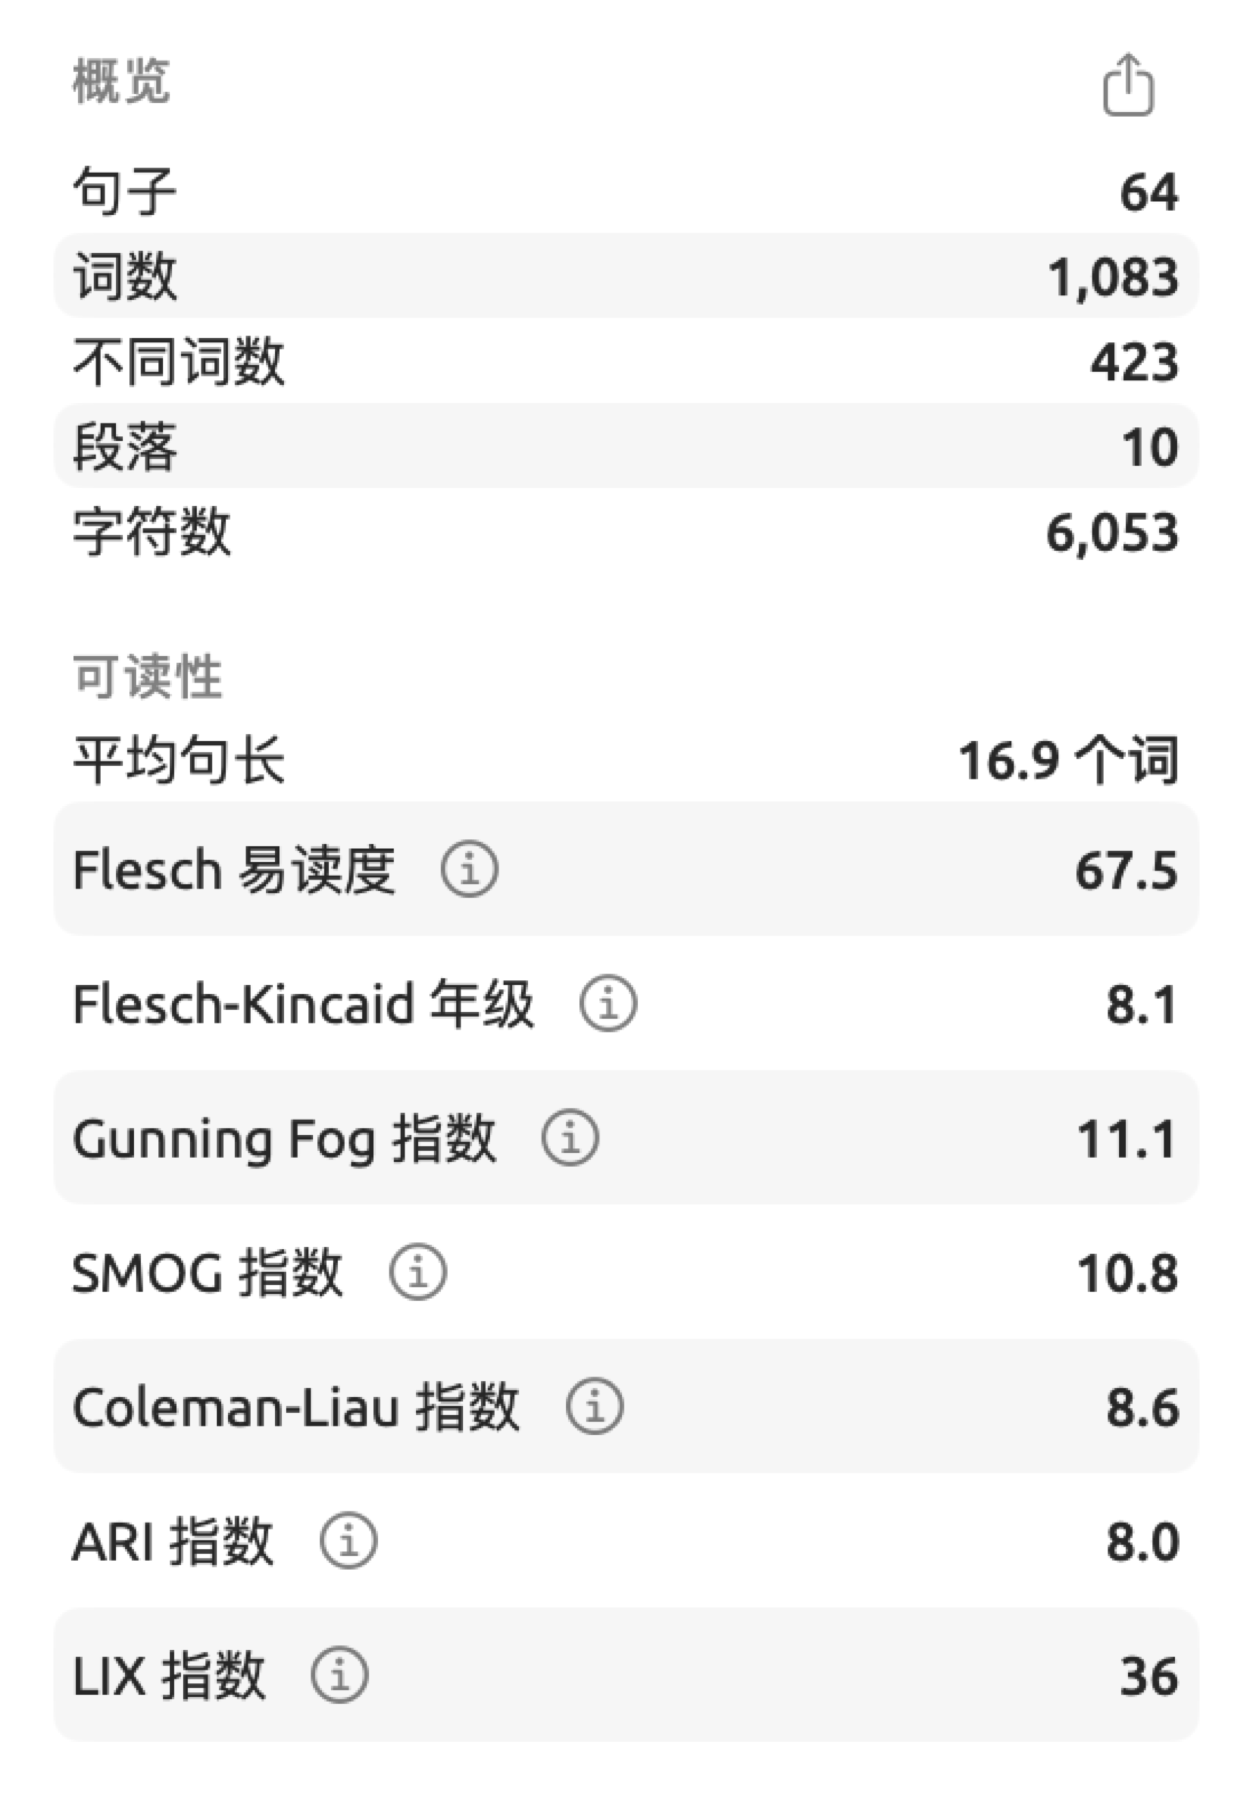
译文的可读性部分采用译文语言的度量。下图是“气候辩论”项目中“时间不多了”的英文译本“时间不多了 (英语)”,它显示的是英语的可读性度量,其中 Flesch 易读度为 67.5,LIX 指数为 36;德语文档则在同一位置显示 Flesch-Amstad 指数和维也纳实用文公式。
维也纳实用文公式(德语)
维也纳实用文公式(Wiener Sachtextformel)由 Richard Bamberger 和 Erich Vanecek 为德语文本制定。这个公式估算文本在德语国家教育体系中的年级,标度大致从 4(容易)到 15(非常难)。LemmaLoom 实现的是这个公式多个版本中的第一版,它按下式结合四项度量(三音节及以上的词所占的百分比、平均句长、长词所占的百分比,以及单音节词所占的百分比):
对于上面的德语段落,按公式中的顺序算出的三个百分比分别是 、 和 。第四部分是减去的,因为单音节词多会让文本更容易读。代入后得到:
结果为:
四舍五入到一位小数后,最终分数约为 6.0,接近标度的下限,所以这段文字算作容易。
汉语的度量
对于拼音文字,上面的公式根据音节或字母衡量可读性。这些指标不适用于汉语文本,所以汉语文档的可读性部分在平均句长之后提供三项替代度量:
- 每句字数衡量文本中汉字数与句数之比。非汉字的字母也计算在内。此外,用汉字写的数字也计入字数,例如“十二”算作两个字。但用阿拉伯数字写的数字(例如 12)不算作汉字。和其他度量一样,标点也不增加字数。
- 平均词长以字为单位衡量,即字数除以词数。含有许多“气候”“邻居”这类双字词的文档,得分高于单字词常见的文档。
- 助词密度衡量每 100 个词中出现多少个助词。助词包括助词透镜标注的词,即动词后的“了”“着”“过”,“的”“地”“得”,以及“个”之类的量词(见第 6 章“透镜”中的句式与助词(中文))。“吗”“呢”“吧”等句末语气词不计入。
对于下面两个句子,索引把词切分如下:
我们 / 等 / 了 / 十二 / 个 / 小时 。 邻居 / 也 / 非常 / 担心 。
结果是两个句子中共有十个词、十六个字。其中出现了两个助词,即“了”和量词“个”。因此,每句字数为 ,平均词长为 个字,助词密度为每百词 个助词。
汉语的这些指标不对应任何年级水平。这三项只用于在汉语文档之间相互比较;单看助词密度较高,并不能说明文本有多难。
解读可读性分数
把这些公式用于 30 个词的英语示例段落,得到以下结果:
| 度量 | 分数 | 标度类型 |
|---|---|---|
| Flesch 易读度 | 86.7 | 易读程度,0 到 100 |
| Flesch-Kincaid 年级 | 3.7 | 美国学校年级 |
| Gunning Fog 指数 | 8.0 | 受教育年数 |
| SMOG 指数 | 8.8 | 美国学校年级 |
| Coleman-Liau 指数 | 4.8 | 美国学校年级 |
| ARI 指数 | 2.4 | 美国学校年级 |
| LIX 指数 | 20 | 难度,约 20 到 60 |
五个公式对同一段文字给出的受教育程度估计值从 2.4 到 8.8 不等。数字之所以不同,是因为每个公式给各个特征分配的权重不同。这段文字在较短的句子中夹着几个三音节及以上的词,所以 Gunning Fog 指数和 SMOG 指数偏高,ARI 指数却几乎不受影响。在较长的文档中,公式之间的差异会缩小,但不会完全消失。五个公式对文档“时间不多了 (英语)”的估计值从 8.0 到 11.1 不等。
词汇
词汇部分涉及文档中的词。通过这些度量,你可以了解文档是倾向于大量重复使用同样的词汇,还是用词丰富多样。例如,类符形符比会告诉你,相对于文本的总词数,用到了多少个不同的词元。类符形符比、MATTR 和罕用词比例都把同一个词元的不同形式算作一个。
类符形符比
类符形符比用不同词数除以总词数来衡量词汇的多样性:
这里的 表示不同词数, 表示词数。比值等于 1 时,每个词都恰好出现一次;因此,文档中的词重复得越少,比值就越接近 1。
示例段落只重复了 the,它一共出现 3 次,所以 ,类符形符比为 。如果一份 4,000 词的报告有 800 个不同词,它的比值就是 。
比值较低并不一定意味着词汇贫乏。文档越长,这个比值总会越低,因为常用词不断重复,新词则出现得越来越少。
MATTR
MATTR 即移动平均类符形符比(moving-average type-token ratio),它衡量词汇多样性,不受文档长度的影响。在 LemmaLoom 中,MATTR 先在文本前 100 个词的滑动窗口中计算类符形符比,然后向后移动一个词,计算第 2 到第 101 个词的类符形符比,如此一直到文本末尾。MATTR 就是这些比值的平均数。
这里的 、 等依次表示文档中每个 100 词窗口里的不同词数; 是窗口的总数,也就是词数减去 99。每个 除以 100,得到相应窗口的比值;把这些比值相加再除以 ,就得到平均数。
举一个小规模的例子。假设窗口是 4 个词而不是 100 个,文本是这八个词:we warn and we wait and we warn。五个窗口如下:
| 窗口 | 不同词数 | 比值 |
|---|---|---|
| we warn and we | 3 | 0.75 |
| warn and we wait | 4 | 1.00 |
| and we wait and | 3 | 0.75 |
| we wait and we | 3 | 0.75 |
| wait and we warn | 4 | 1.00 |
这里的平均数是 。而这八个词只有 4 个不同词,类符形符比只有 。
对于不超过 100 个词的文档,MATTR 公式简化后就等于类符形符比。
罕用词比例
hapax(希腊语,意为“一次”)指在文档中恰好只出现一次的词,即罕用词。罕用词比例是不同词中罕用词所占的比例:
这里的 是恰好出现一次的不同词数, 是不同词的总数。有时也会改用词数作 的除数,得出的数字会更小。示例段落的 28 个不同词中,有 27 个恰好出现一次,比值为 ,显示为 96%。在前面假设的那份 4,000 词的文档中,如果 800 个不同词里有 400 个罕用词,比值就是 50%。
罕用词比例高,往往说明很多词只是顺带出现,其中包括专有名词。与类符形符比一样,罕用词比例也取决于长度;在短文档中,大多数词都只出现一次。
词汇密度和虚词比例
虚词比例是文档中属于该文档语言停用词表的词所占的比例。反过来,词汇密度是文档中不属于停用词的词所占的比例;因此,两个比例相加为 100%。
以示例段落为例,它由 30 个词组成,其中有 17 个停用词:第一句中的 we、were、by、the、again 和 this;第二句中的 so、the、for、a、and 和 could;第三句中的 the、that、our、had 和 up。所以这段文字的虚词比例为 ,词汇密度为 。
由于代词和助动词较多,自然口语的词汇密度通常低于经过编辑的书面文字。如果一份转写文本的停用词比例比自然口语低,可能说明它是概括整理出来的,而不是逐字转写的。
停用词表是内置的,每种语言各有一张固定的词表:
- 英语停用词表约有 160 个词,包括冠词、代词、介词和连词;be、have 和 do 的各种变位形式;can、should、must 等情态动词;否定词 not 和 no;以及 very、also 和 again 之类的常用副词。
- 德语停用词表约有 210 个词,除冠词、代词、介词和助动词外,还包括情态小品词 ja、doch、mal、eben 和 halt。
- 汉语停用词表约有 150 个词,其中有“的”“了”和“是”;代词;“不”和“没有”;以及常用的介词和副词。
一个词只要在词元或词符形式上与表中的词相符,就算作停用词。有些实义词看起来像虚词,例如示例段落中的 nobody。查询字段停用词使用的是同样的词表。
平均词长
词汇部分中的平均词长是字母数与词数之比,即 ,以字母为单位。示例段落每个词有 个字母,它的德语版本则是 个。数字不含字母,所以数字多的文本,平均词长会比数字少的文本稍低。对于汉语文本,这项度量出现在可读性部分,以字为单位。
句法
句法部分分析句子是如何构成的,而不只是衡量句子的长度。这些度量考察相互关联的词之间的距离、小句在其他小句中的嵌套,以及其他能揭示句子结构复杂程度的类似指标。它们依赖语法分析的两个部分。
依存分析是指根据每个词所依附的中心词,分析句中词与词之间的关系。例如在 a fair share 中,fair 和 a 都依附于 share。每个句子都有一个不依附于任何词的根词(通常是句子的主要动词)。检查器的语法标签页以图示显示词与中心词之间的联系(见第 11 章“语法检查器”)。
短语分析把句中的词归入层层嵌套的短语和小句。
平均依存距离
依存距离按句中的位置计算一个词与它的中心词之间相隔多远。平均依存距离是文档中所有带中心词的词的依存距离的平均数:
这里的 到 是各个依存距离, 是带中心词的词的数量,也就是除每个句子的根以外的所有词。标点符号占据位置,但不计入依存距离的总和。
在句子 The richest countries rarely pay a fair share. 中,pay 是根动词。词的编号表示位置顺序,从 1 开始。各词及其中心词如下:
| 词 | 位置 | 中心词 | 中心词的位置 | 距离 |
|---|---|---|---|---|
| The | 1 | countries | 3 | 2 |
| richest | 2 | countries | 3 | 1 |
| countries | 3 | pay | 5 | 2 |
| rarely | 4 | pay | 5 | 1 |
| a | 6 | share | 8 | 2 |
| fair | 7 | share | 8 | 1 |
| share | 8 | pay | 5 | 3 |
这 7 个依存距离的总和是 12。因此,这个句子的平均依存距离为 。有关联的词相隔越远,依存距离就越大。在句子加工的研究中,依存距离越大,读者需要的加工就越多。长句、嵌套小句,以及德语小句中动词居末的结构,都会让这项分数升高。平均依存距离没有通用的标度;只有与同一语言的其他文档相比较,它才有意义。
平均句法树深度
对每个词来说,沿着它的中心词逐级向上,直到层级结构的根,这条路径决定了它的深度。需要经过的步数就是这个词的深度。句子的深度是句中所有词的深度的最大值。平均句法树深度就是文档中各句深度的平均数。
在上面的句子中,countries、rarely 和 share 直接连到根,只需一步(深度为 1)。the、richest、a 和 fair 都需要两步才能到达根;因此,这个句子的深度为 2。再举一个例子,假设另一个文档中各句的深度为 2、4 和 6,那么平均句法树深度就是 。
每句小句数和嵌套小句
每句小句数按短语分析的结果,计算平均每个句子有多少个小句。这项度量计算 ,其中 是文档中小句的总数, 是文档中句子的总数。嵌套小句比例计算文档的小句中不是主句的小句所占的比例。每个至少含有一个小句的句子,都被视为恰好有一个主句。因此,这项度量用 除以 ,其中 是至少含有一个小句的句子数。结合这两项度量,你可以判断作者在多大程度上把一个意思嵌入另一个意思之中,而不是把它们并列摆出。
用公式表示,每句小句数是 ,嵌套小句比例则是
计数严格依照短语分析的结果。例如,英语从句 because the heat was dangerous 算作两层,它包含内层的小句 the heat was dangerous。因此,句子 We stayed inside because the heat was dangerous. 共有三个小句(整个句子、because 从句,以及从句内部的小句)。而句子 Nobody complained. 只有一个。以由这两个句子组成的文档为例:
- 每句小句数等于 。
- 嵌套小句比例等于 ,即 50%。
由于这种分层,得出的数值会比学校语法所数的小句数高。
被动句比例
被动句比例指文档中含有一处或多处被动结构的句子所占的比例。一个句子中出现多处被动结构,也不会改变计数。例如,一个文档共有 40 个句子,其中 6 个含有被动结构,比例就是 。
什么算作被动结构,取决于语言:
- 在英语中,语法分析会识别被动句中的主语和助动词,例如 This report was prepared by the agency's climate monitoring service。
- 在汉语中,含有“被”字的句子以及其他可识别的被动结构都会计入,与句式透镜的被字句标注项一致。
- 在德语中,由 werden 加过去分词构成的被动结构无论是否交代施事都会计入,例如 Dieser Bericht wurde erstellt 和 Dieser Bericht wurde von der Klimaüberwachung des Amtes erstellt。由 sein 构成的被动结构只有在 von 或 durch 短语交代施事时才计入,与修辞透镜的被动语态一致。
被动句有时不交代动作是由谁执行的。例如“2024 热浪报告”中的“探视独居老人的责任没有被明确分配”。
结构
结构部分包含三项指标。
对话比例计算位于双引号之间的词所占的百分比。以虚构的英文句子 My neighbor always said, “Our summers are mild.” 为例,八个词中有四个在引号内,对话比例为 50%。在“碳税之争”这样的新闻报道中,引号用来标出发言者的直接引语,这一比例反映文本整体上有多少是别人的话。LemmaLoom 通过给引号配对来估算这一比例:
- 直引号(
")按出现顺序交替表示开始和结束。 - 弯引号以 “ 开始、以 ” 结束。在德语文档中,„ 表示开始,“ 表示结束。
- « 以及中文的直角引号 「 和 『 表示开始,»、」 和 』 表示结束。在德语文档中,» 表示开始,« 表示结束。
- 单引号会被忽略。
一个没有配对的引号会让它之后的所有词都算作引语。如果数值高得出奇,往往说明文档中某处有一个多余的引号。
疑问句与感叹句计算以问号或感叹号结尾的句子所占的百分比。汉语文本中的全角问号和感叹号也计算在内。注意,只有最后一个词符是感叹号或问号的句子才计入;问号后面还有右引号的句子不计入。在一个有 80 个句子的文档中,如果有 18 个疑问句和 2 个感叹句,疑问句与感叹句就是 。在评论文章和演讲中,数值高可能表明其中有反问句,例如“时间不多了”中加了书签的那一句。和其他统计数据一样,它涵盖整个文档,所以在“电台辩论”这样的转写文本中,主持人的提问也计算在内。
最后,每段句数是句子总数除以段落数。例如,120 个句子分布在 40 个段落中,得出每段 3.0 句。LemmaLoom 生成的转写文本在每次换说话人和每次较长的停顿处结束段落;因此,这项指标大致反映说话人连续说了几句话。
词类、句法功能和短语
度量下方有三个条形图,显示所选文档中的词和短语在各个类别中的分布。每一行包括类别名称、一个条形,以及一个表示该类别在所选文档中出现次数的数字。注意,这些统计不包含未出现的类别;即使你在设置的透镜面板中选择了其他颜色,条形仍使用相应透镜的标准颜色。
- 词类显示词类透镜十个词类中各类的词数,从名词到感叹词(见第 6 章“透镜”中的词类)。注意,其他所有类型的词(包括外语词)都不计入这项统计。
- 句法功能显示语法功能透镜十种功能中每一种的词数,从主语到连接词(见第 6 章“透镜”中的语法功能)。注意,每个句子中没有功能的根词(通常是主要动词)不计入,关系不属于这十种语法功能的词也不计入,所以这些统计的总数会低于文档的总词数。
- 短语显示短语透镜中每一类短语的数量,从名词短语到感叹词(见第 6 章“透镜”中的短语)。注意,嵌套的短语各自计数,例如 in our valley 算作一个介词短语,our valley 在名词短语类别中再算一次;小句则在句法部分中单独统计。
在示例项目“气候辩论”中,“2024 热浪报告”的名词比重很大,而与评论文章或“电台辩论”相比,它几乎不用代词。下图是“时间不多了”文档的词类和句法功能图表。
要查看每个条形由哪些词组成,请在阅读器中打开相应的透镜。
书签分面
书签分面按书签在文档中的位置顺序显示文档的书签。例如在“气候辩论”中,“时间不多了”在最后一段有 1 个书签,位于问句“我们到底还在等什么?”上,评论是“转入结尾呼吁时的反问句”。标题显示与文档关联的书签数量,所以这里的标题是书签(1)。关于如何添加书签,请参阅第 7 章“编码”中的书签。
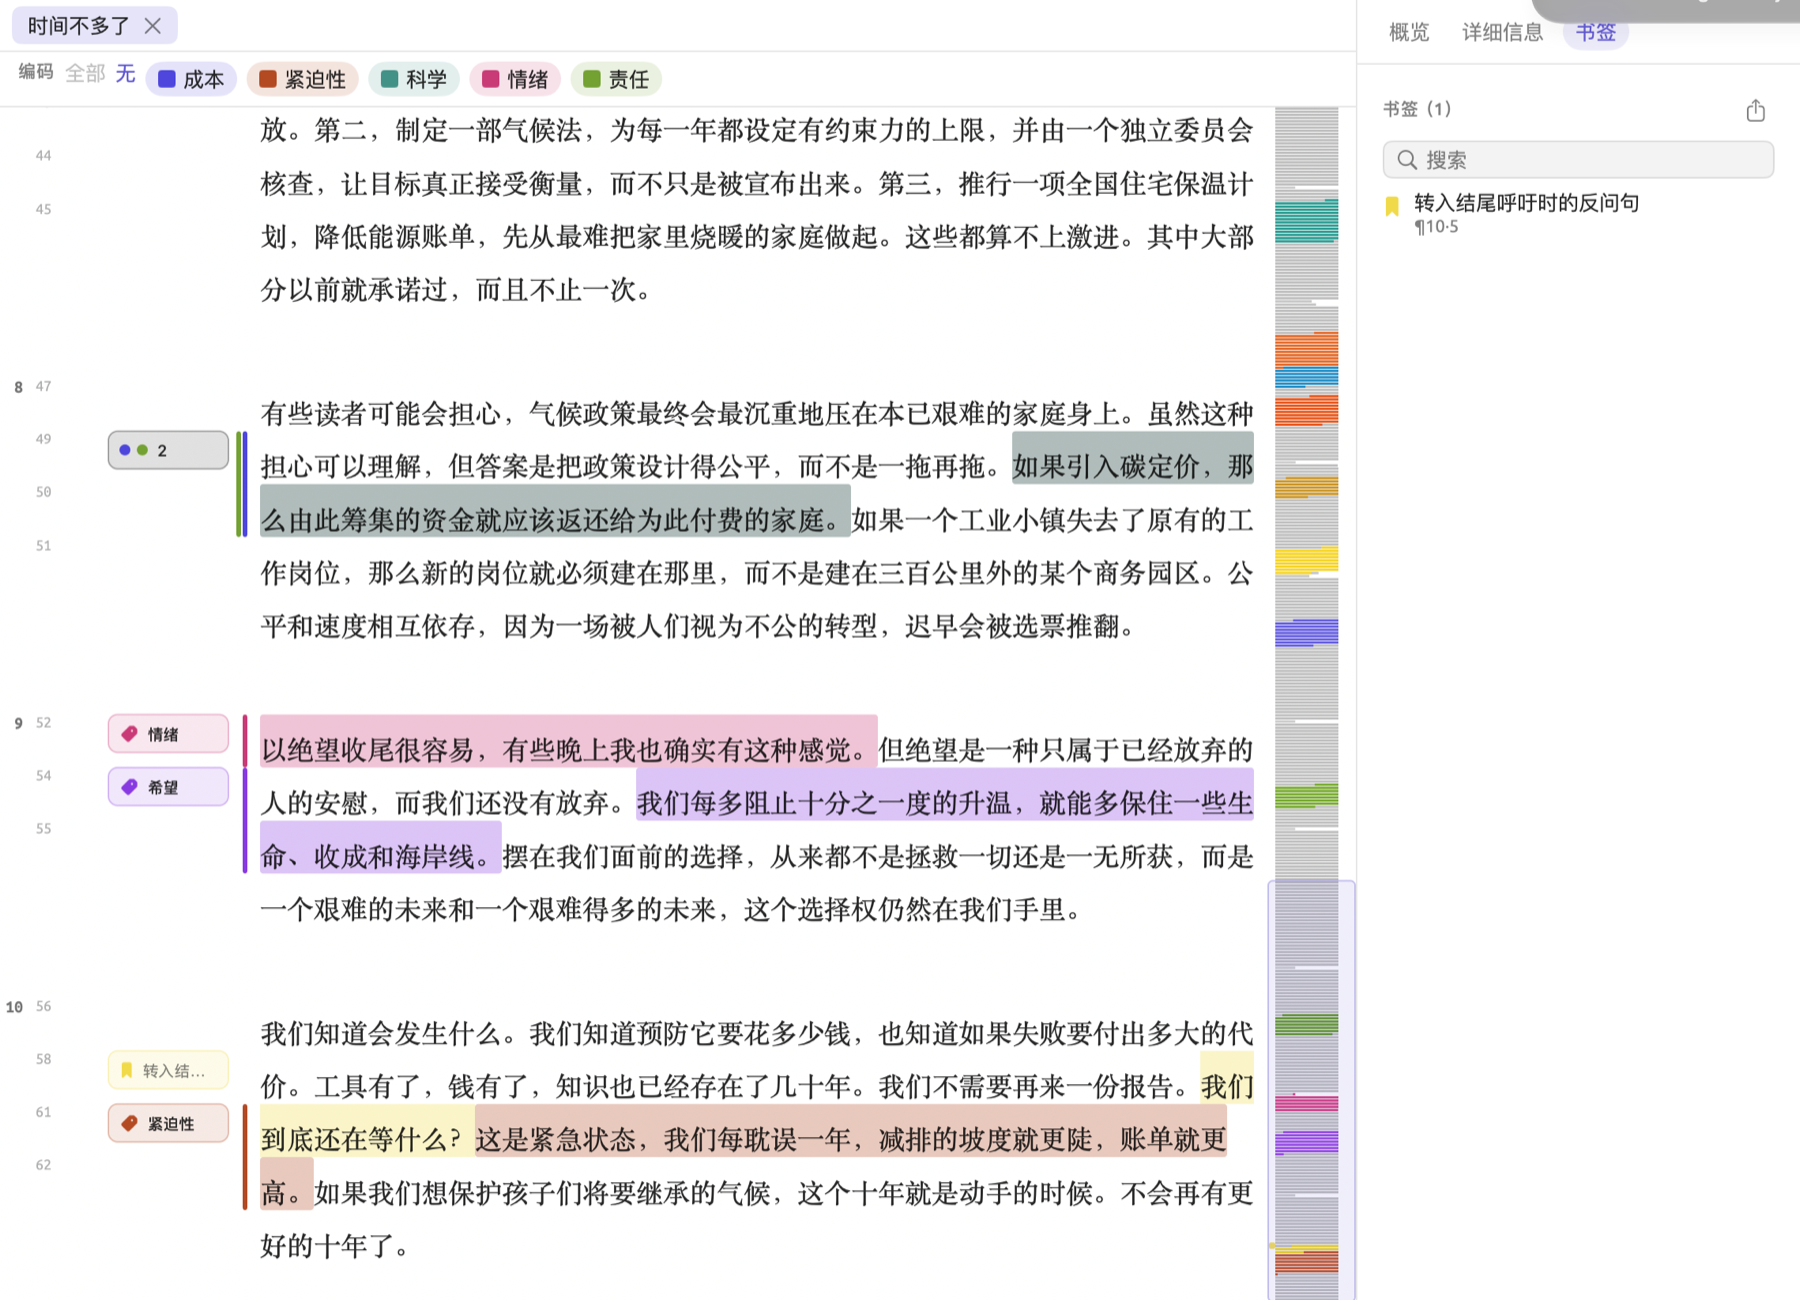
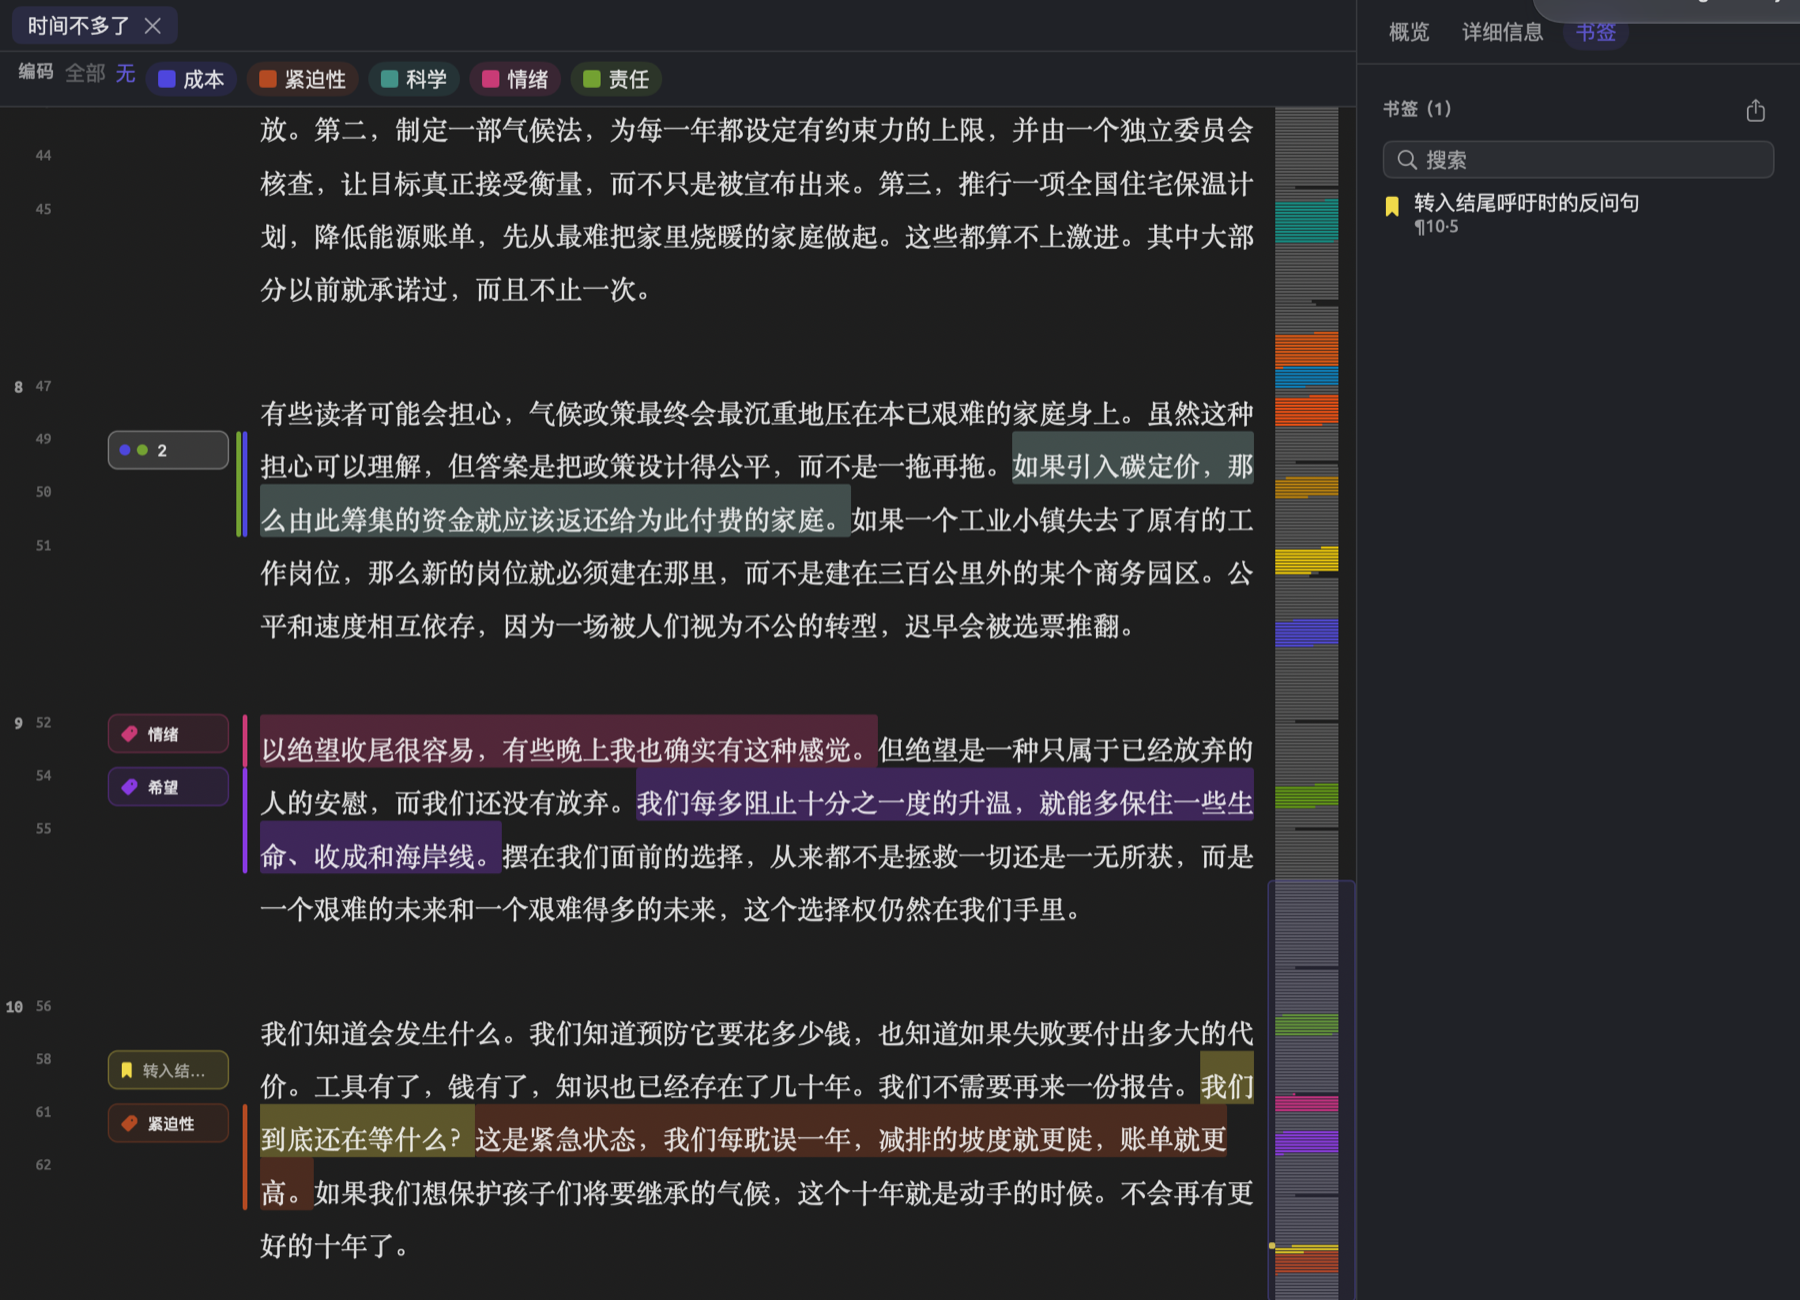
每一行列出:
- 书签图标,颜色与书签相同;如果书签为无颜色,则显示为灰色;
- 书签的评论;如果没有评论,则显示加了书签的文本本身,最多三行;
- 以及书签的位置,例如 ¶10·5 表示第十段的第五句。将鼠标指针悬停在位置上,会显示完整的写法,例如第 10 段,第 5 句。
点按某一行即可跳转到该书签。如果阅读器只显示有标注的句子,而所选书签不在其中,会先显示文档的其余全部内容,再跳转到书签。
列表上方是搜索栏。在其中输入任何内容,列表就只显示评论或文本中含有所输入内容的书签;搜索不区分大小写。不过,无论是否搜索,标题中的数字都统计全部书签。
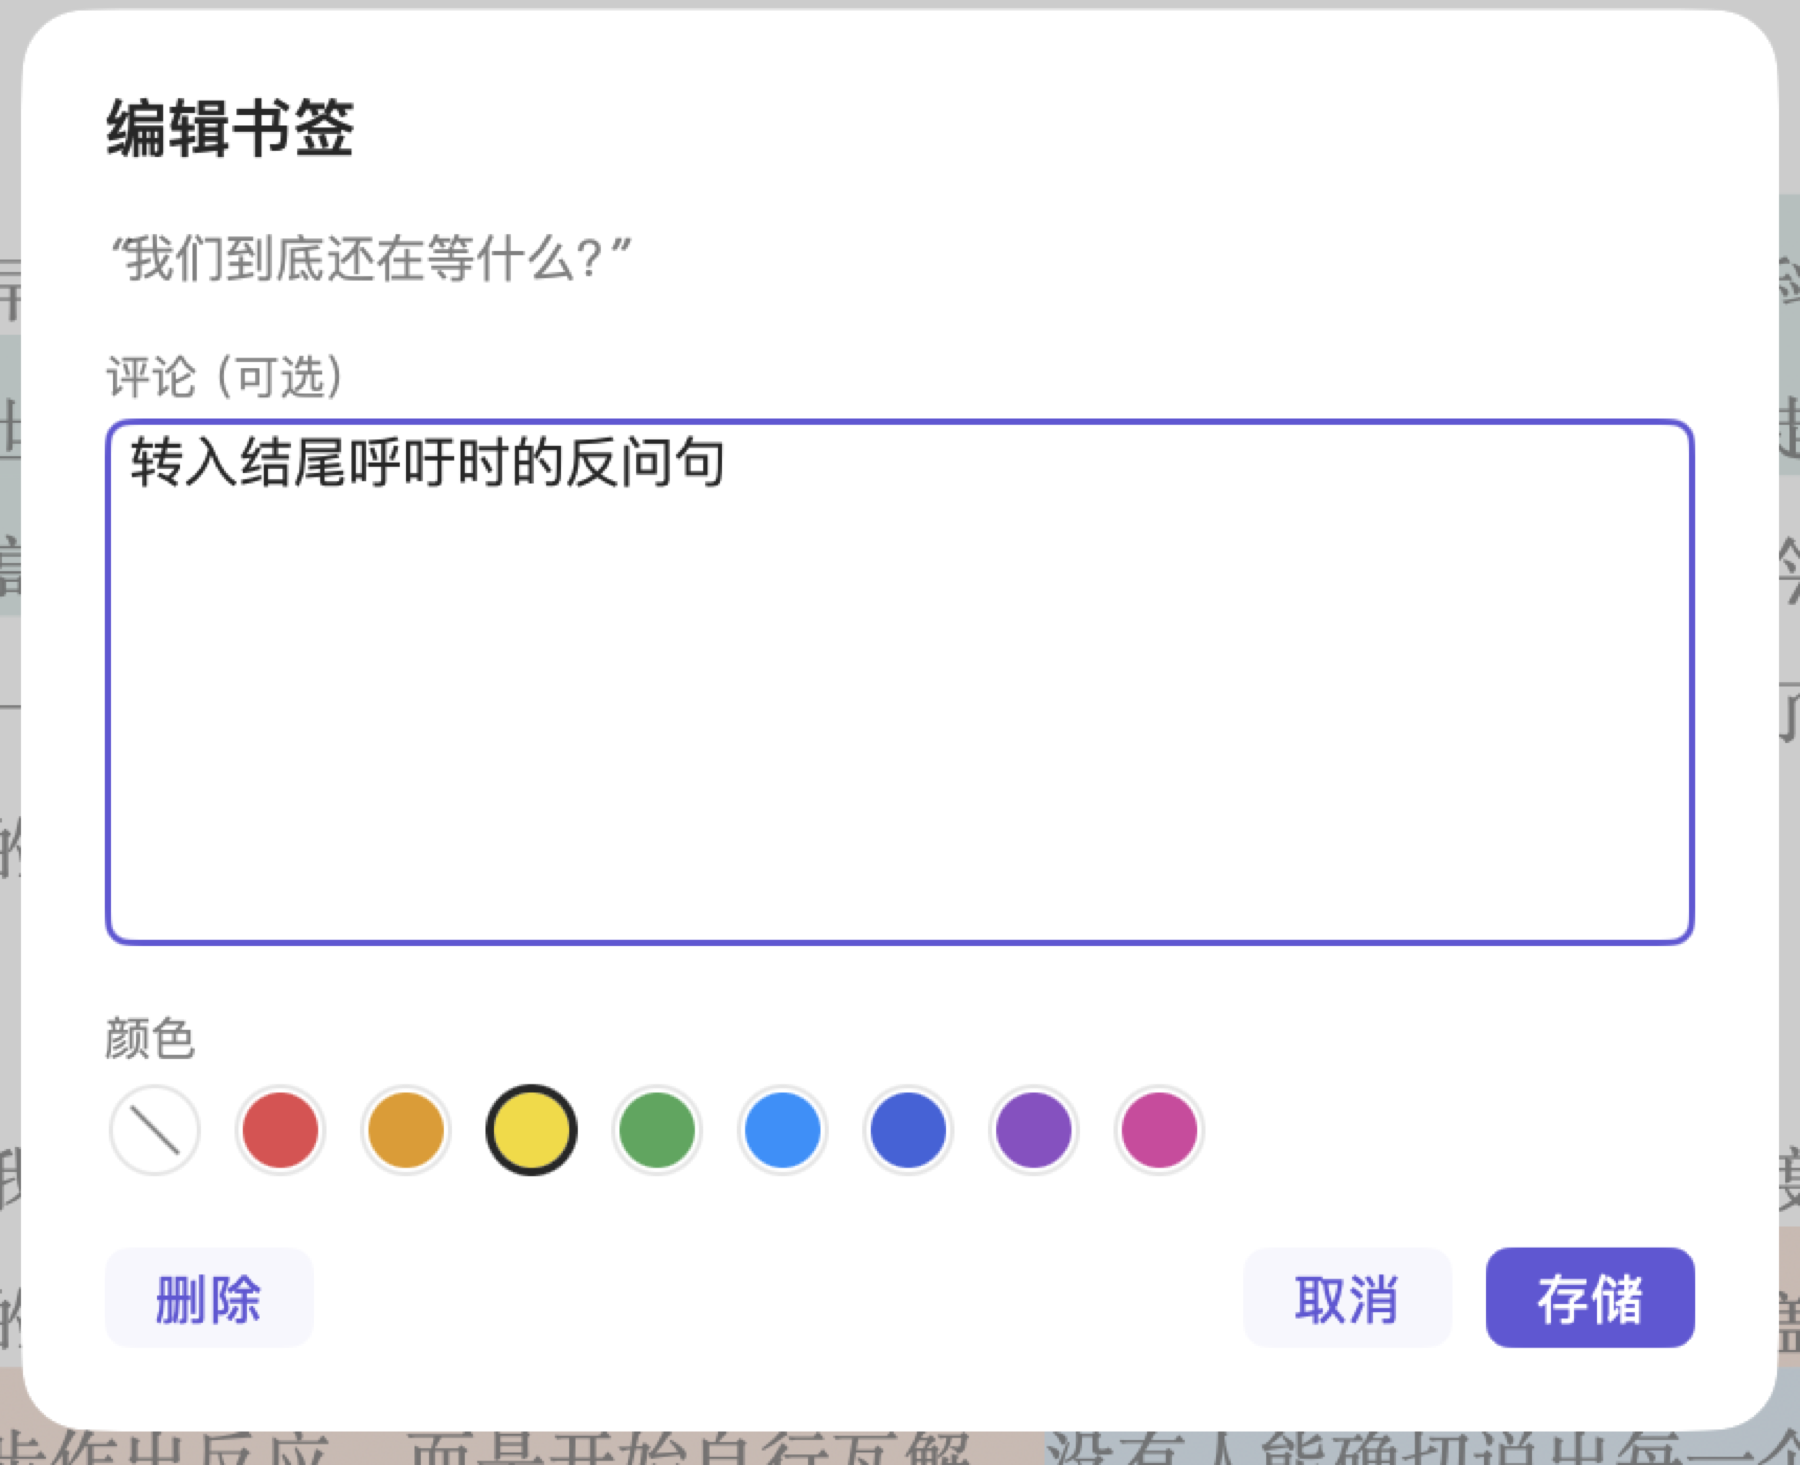
要更改书签的评论或颜色:
- 右键点按它所在的行,然后选取编辑。
- 在显示加了书签的段落的编辑书签对话框中,更改评论(可选)或颜色。
- 点按保存。
要删除书签,请右键点按它所在的行,然后选取删除。也可以在编辑书签对话框底部点按删除。更改会立即生效;要恢复已删除的书签,请使用编辑 ▸ 撤销移除书签(⌘Z)。编辑 ▸ 撤销编辑书签(⌘Z)可以撤销对书签所做的编辑。
如果你添加书签的文档有译文,这个书签就会存在于每一份译文中。它与每份译文中的对应段落相关联;对书签的编辑和删除会作用于所有这些文档。根据查询的命中结果创建书签(为命中添加书签…)时,生成的书签也会像普通书签一样显示在这里(见第 18 章“使用查询结果”中的为命中添加书签)。
点按标题右侧的导出按钮(导出为 CSV)即可导出书签。导出的文件包含位置、文本和评论三列,收录当前列出的所有书签;也就是说,搜索之后只包含匹配的书签。建议的文件名是文档标题后接 -bookmarks。