编码分析
在文档中为足够多的段落编码之后,就可以查看各编码的分布,以及几组文档在使用编码上可能存在的差别。LemmaLoom 的视图统计每个编码出现的次数,以及它覆盖了多少文本。其中一个视图显示每个编码实例在各个文档中的位置。另一个视图显示不同编码如何共现。
单个文档的视图位于检查器的编码标签页,项目、文档集和标签的视图位于项目视图栏中(见第 3 章“项目与文档”中的项目视图栏)。关于如何创建编码、为段落编码,第 7 章“编码”中有更多说明。
下面的演示使用 LemmaLoom 的示例项目“气候辩论”(文件 ▸ 导入 ▸ 示例项目)。LemmaLoom 会以界面所用的语言添加“气候辩论”,其中的文档已建立索引,所有编码实例也已标注好。“气候辩论”示例项目使用的编码有“紧迫性”(子编码为“临界点”和“时间节点”)、“科学”(子编码为“不确定性”)、“成本”、“责任”和“情绪”(子编码为“恐惧”和“希望”)。此外,“电台辩论”中还有“说话人”(子编码为说话人编码“主持人”“活动人士”和“怀疑论者”),它把这些说话人编码归为一组,因此项目的编码统计共列出 13 个编码。项目中的文档集包括“行动派”和“怀疑派”,前者包含六个行动派文档,后者包含五个怀疑派文档。
下文中片段、文档和重叠的计数都取自 LemmaLoom 提供的示例项目。示例中的字符数则是为了演示而虚构的,并且都取整数,便于跟上计算过程。因此,示例项目本身显示的覆盖率和 φ 值与示例中的不同。
关键术语
- 编码实例指一个编码在一段文本上的一次应用。如果一个段落标注了两个编码,它就有两个编码实例。
- 编码片段(简称片段)指一个编码实例所覆盖的段落;在各视图的计数中,片段与编码实例同义。
- 视图的范围是它所涵盖的文档,可以是检查器中的当前文档,也可以是项目视图栏中的一个项目、文档集或标签。
- 编码的覆盖率是该编码的片段所跨越的字符在范围内文本中所占的比例,以百分比表示。
- 在同一文档中,只要一个编码的某个片段与另一个编码的某个片段至少共有一个字符,这两个编码就重叠,也称共现。
- 如果一个文档中至少有某个编码的一个片段,就说这个编码在该文档中出现。
- 属性是附加在编码上的特性,例如附加在“恐惧”上的“强度”。带有该属性的编码,其每个编码实例都保存着这个属性的值,属性分布和编码实例视图的筛选用的就是这些值;而编码矩阵中的列分组依据则按文档属性(例如“立场”)为各列分组。
- φ(phi 系数)是一种标准化的关联度量,取值在 0 到 1 之间,表示两个编码的共现程度与纯属偶然时的预期相比有多高。
- 克莱姆 V 系数(Cramér's V)与 phi 系数相似,取值范围也相同,但它衡量的不是编码之间的重叠,而是比较各组中含有某个编码的文档所占的比例。
- p 值是一种概率度量,用来检验一个结果如果完全出于随机,会有多出人意料;p 值越小,结果越出人意料。
选择视图
根据你最关心的问题选择视图:
| 要查看的内容 | 使用 | 范围 |
|---|---|---|
| 每个编码的使用频率,以及它覆盖了多少文本 | 编码统计 | 一个文档,或者一个项目、文档集或标签 |
| 文档中各编码出现的先后顺序 | 画像 | 一个文档 |
| 文档中哪些编码相互重叠,重叠程度如何 | 编码统计中的共现 | 一个文档 |
| 每个已编码的段落及其属性值 | 编码实例 | 一个文档,或者一个项目、文档集或标签 |
| 某个编码的属性值如何分布 | 编码统计中的属性分布 | 一个文档,或者一个项目、文档集或标签 |
| 哪些文档用了哪些编码 | 编码矩阵 | 一个项目、文档集或标签 |
| 几组文档(例如行动派和怀疑派)中,含有某个编码的文档所占比例是否不同 | 使用列分组依据的编码矩阵 | 一个项目、文档集或标签 |
| 在许多文档中哪些编码相互重叠,重叠程度如何 | 关系 | 一个项目、文档集或标签 |
| 一个词的语法搭配成分在不同编码之间有何差别 | 编码速写,或词汇速写视图中的编码 | 一个文档,或者一个项目、文档集或标签 |
要查看每 10,000 词的编码实例比率,或者检验单个文档之间的比率差异,请使用查询,并把显示选项设为比较(见第 16 章“查询结果与统计”中的比较各组)。
视图统计的是什么
- 项目视图栏中的编码视图只统计原文文档。译文文档保存的是其原文编码实例的副本(见第 7 章“编码”中的译文中的编码实例),把它们也统计进去,每个编码实例就会被计算两次。检查器的分面统计的是当前文档,所以查看“时间不多了 (英语)”时,会显示它复制过来的编码实例。
- 编码和编码统计分面会把已编码备忘录算作其编码的一个编码实例(见第 7 章“编码”中的已编码备忘录),而画像分面、属性分布以及项目视图栏中的编码视图只统计实际的编码实例。
- 每个编码单独统计。因此,对示例项目中的编码“紧迫性”来说,只有实际标注为“紧迫性”本身的段落才计入它的数字。“临界点”和“时间节点”作为子编码另行统计。不过,在编码实例视图中阅读某个数字背后的片段时,可以把子编码加进来(见“编码实例”视图)。
- 覆盖率按字符计算,空格和换行符也算在内。同一编码的段落相互重叠时,重叠部分的字符只计一次。
检查器的“编码”标签页
检查器的编码标签页显示当前文档的编码。选取显示 ▸ 检查器 ▸ 编码(⌥⌘3),或者点按检查器顶部的标签形图标,即可打开它。标签页图标下方有六个按钮,用来在“编码”标签页的六个分面之间切换,即编码、编码实例、链接、编码统计、画像和编码速写。
前三个分面分别处理编码、编码实例和链接,第 7 章“编码”中的检查器的“编码”标签页对它们有完整的说明。这三个分面中都显示计数。
- 编码分面在每个编码旁边显示它在这个文档中的使用次数。点按编码系统旁的导出按钮,编码列表会连同这些数字一起导出为 CSV 文件。
- 编码实例分面按阅读顺序列出这个文档中的所有编码实例,并在切换按钮上显示它们的数量,例如编码实例 (13)。使用按编码筛选,可以让列表只显示属于某一个编码的编码实例。
- 链接分面列出一端位于这个文档中的所有链接,上方的标题给出链接的数量。
编码频率与覆盖率
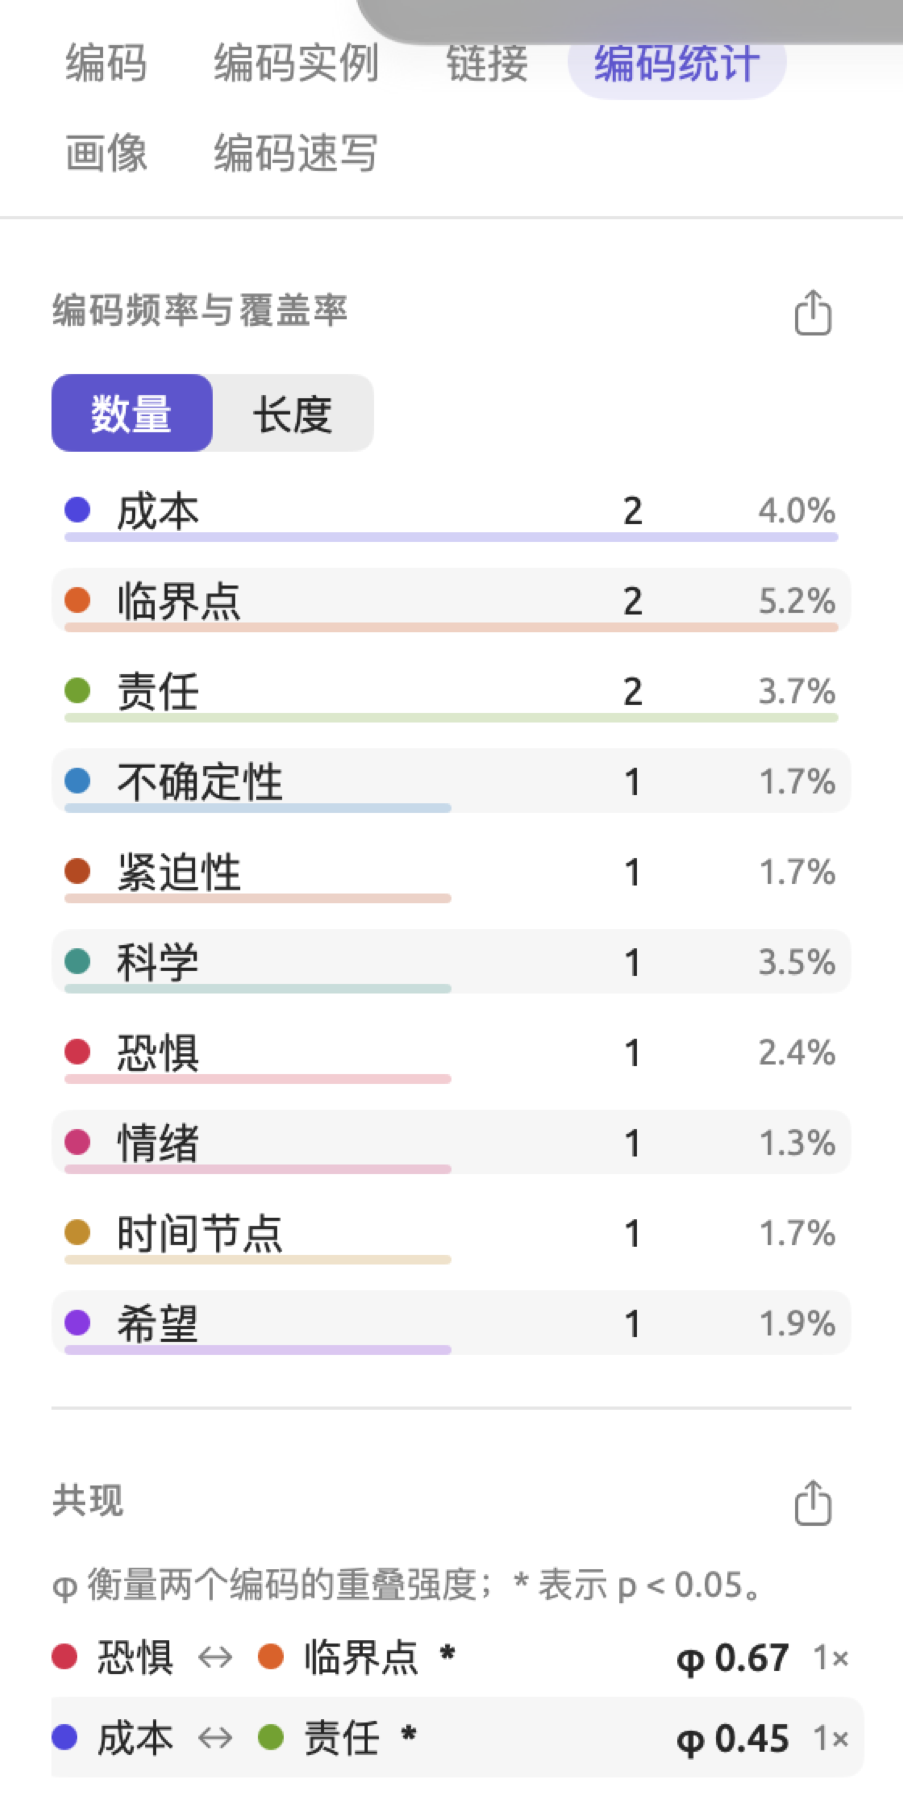
编码统计分面统计当前文档中的编码实例。它的第一部分名为编码频率与覆盖率,列出文档中出现的每个编码,并附上两个数字,分别是该编码在文档中标注的片段总数,以及该编码覆盖文档的百分比。下图是“时间不多了”(“气候辩论”中的一篇行动派评论)的这个分面。
要查看一个文档所用的编码:
- 打开文档。
- 选取显示 ▸ 检查器 ▸ 编码(⌥⌘3),然后点按编码统计。
- 点按列表上方的数量或长度。
数量按片段数为编码排序,长度则按片段跨越的字符数排序。每行下方的条形对应所选的排序方式,这个度量的数字也比另一个数字颜色更深。点按任意一行,阅读器就会显示这个编码的一个片段。
覆盖率的计算公式如下:
是所讨论编码的片段所含的字符数,同一编码的片段相互重叠时,共有的字符只计一次。 是文档的字符总数。下面用虚构的整数举例。假设文档“时间不多了”有 5,000 个字符,其中两个“临界点”片段覆盖了 300 个字符。“临界点”这一行的片段数显示为 2。在这个例子中,覆盖率的计算如下:
实际上,这一行显示的是 5.2%,它是根据“时间不多了”实际的字符数算出的。第 2 章“开始使用”中的查看一篇文本的编码情况还有一个示例,演示片段相互重叠时的覆盖率。
按数量排序,可以看出哪些编码用得最多;按长度排序时,只有一个长片段的编码也可能排得很靠前。“科学”在“时间不多了”中只出现一次,却覆盖了 3.5% 的文本,与有两个片段、覆盖 3.7% 的“责任”相差无几。因此,按长度排序时,“科学”紧跟在“责任”之后,排在其他只有一个片段的编码之前。
文档中的共现
编码统计的第二部分是共现,列出在文档中任何地方同时出现的每一对编码。
每一行显示用双向箭头相连的两个编码,后面是 φ 系数,以及相互重叠的片段对数,例如 1×。编码名称后面的 * 表示这一对编码的 p 值低于 0.05。各行按 φ 值从高到低排列。
在“时间不多了”中,“临界点”和“恐惧”这一行显示 *、φ 0.67 和 1×。仅有的一个“恐惧”片段与两个“临界点”片段中的一个相交。φ 根据两个编码共有的文本量与偶然情况下的预期相差多少来量化它们的关系,并按每个编码覆盖文档的多少加权。
四个计数
这个度量把文档中的每个字符都看作一次观测。每次观测根据它同时属于两个编码、只属于“恐惧”、只属于“临界点”还是两者都不属于,落入四个格子中的一个。例如,假设在“时间不多了”中,“恐惧”占 200 个字符,“临界点”占 300 个,两者重叠 120 个:
| 属于“临界点” | 不属于“临界点” | 合计 | |
|---|---|---|---|
| 属于“恐惧” | 120 | 80 | 200 |
| 不属于“恐惧” | 180 | 4,620 | 4,800 |
| 合计 | 300 | 4,700 | 5,000 |
只属于“恐惧”的有 个字符,只属于“临界点”的有 个字符。5,000 个字符中其余的 4,620 个不带任何一个编码。
期望重叠
假设这两个编码互不相关,也就是说,即使知道你在哪里标注了“临界点”,也无法据此预测你在哪里标注了“恐惧”。换句话说,“临界点”在“恐惧”的字符中所占的比例,与它在整个文档中所占的比例相同,即 300/5,000,也就是 6%;而“恐惧”的 200 个字符的 6% 是 12。这就是两个编码交集(共有格)中字符的期望频数。在像这样的列联表中,每个格子的期望频数都用下面的公式计算。
这里, 表示一个格子的期望频数, 表示它所在行的计数合计, 表示它所在列的计数合计, 表示文档的字符数。因此,“临界点”和“恐惧”共有格的期望频数为 。其他格子的期望频数分别是只属于“恐惧”的 188 个字符、只属于“临界点”的 288 个字符,以及两者都不属于的 4,512 个字符。两个编码实际共有 120 个字符,是期望值 12 的 10 倍。
卡方
卡方统计量()把每个格子的观测计数与其期望频数之间的差异加总起来。
表示格子的观测计数, 表示格子的期望频数。求和符号()在这里的意思是“对每个格子计算下面的式子,再全部相加”。取平方之后,高于期望和低于期望的差异都会使总和增加。除以 ,则让计数小的格子比计数大的格子分量更重。
在两行两列的表中,每个计数与各自期望频数的差距都相同,这里是 108(、,依此类推),而 。 的计算如下:
几乎全部来自共有格,那里实际有 120 个字符,而期望值只有 12 个。
φ 系数
χ² 这个度量随文档长度线性增长。所有计数都加倍时,χ² 也会加倍。φ 消除了这种依赖:
对“临界点”和“恐惧”来说:
这个 φ 值是根据整数计数算出的。根据“时间不多了”实际的字符数,“临界点”和“恐惧”这一行显示 φ 0.67。两个编码的重叠恰好等于期望值时,φ 等于 0;两个编码覆盖的字符完全相同时,φ 等于 1。
短编码即使完全包含在较长的编码之内,φ 值也一定小于 1。假如“恐惧”的 200 个字符全都同时标注了“临界点”,四个格子的计数就是 200、0、100 和 4,700。这样的观测得出的 χ² 约为 3,264,于是 ,原因是“临界点”还有 100 个字符不在“恐惧”之内。
在 LemmaLoom 中,φ 从不取负值,因此共现少得出乎意料的编码对得到的也是正值。一般来说,只要两个编码有所重叠,重叠就会多于期望,因为每个文档中各编码的覆盖率往往都很低。要检查两个编码的重叠是否少于期望,可以先计算它们的期望重叠,即把两个编码各自的字符数相乘,再除以文档的字符总数。然后把这个期望值与共现 CSV 文件“字符数”一列中实际重叠的字符数相比较。每个编码的字符数见编码频率与覆盖率 CSV 文件的“字符数”一列,单个文档的长度见文本检查器中的字符数字段。
p 值与 *
随机放置的两个编码,重叠也会比期望略多或略少,所以 χ² 很少恰好等于 0。p 值本质上是在两个编码毫无关系的条件下,χ² 至少与观测值一样大的概率。例如,p 为 0.03,意味着互不相关的编码大约每 100 次中有 3 次会得到至少这么大的 χ²。
偶然产生的 χ² 值有一种可以预知的形态,即卡方分布。它随自由度而变化;自由度指的是在边际和(每一列和每一行的合计)确定之后,表中仍可自由变动的项数。2 × 2 列联表有一个自由度(共有格和各个合计确定了其余三个格子),这意味着仅凭偶然,每 100 次中有 5 次会得到 3.84 或更大的 χ²。LemmaLoom 根据这个分布计算概率,并给概率低于 0.05(也就是 χ² 大于 3.84)的编码对加上星号。在电子表格中,=CHISQ.DIST.RT(3.84,1) 等于 0.05。把 3.84 和 1 换成任意 χ² 值和自由度,即可得到相应的概率。
以“临界点”和“恐惧”为例,它们的 χ² 为 1,077,远远超过 3.84;几乎每一对重叠超过几个词的编码都是如此。假设在这篇评论中,你把“不确定性”片段的起点提前了两个词,使它有一部分落在前面的“临界点”片段之内。这里“临界点”覆盖 300 个字符,“不确定性”覆盖 100 个,两者重叠 12 个。期望重叠是 个字符。格子中其余三个计数与期望值都相差 6(288 而不是 294,88 而不是 94,4,612 而不是 4,606):
=CHISQ.DIST.RT(6.51,1) 得出 p ≈ 0.011,所以这一对也有星号。它的 φ 是 。
星号之所以这么容易得到,是因为检验把 5,000 个字符中的每一个都当作一次单独的观测。然而,字符的出现显然相互依赖;这些共有字符都来自你对一个片段起点的选择。因此,p 值夸大了显著性。请把 * 理解为“重叠不像偶然”,这几乎总是指重叠偏多;衡量一对编码关联的强弱则要看 φ,“临界点”和“恐惧”的 φ 是 0.46,“临界点”和“不确定性”的是 0.04。φ 高只说明你在相同的地方标注了两个主题。
属性分布
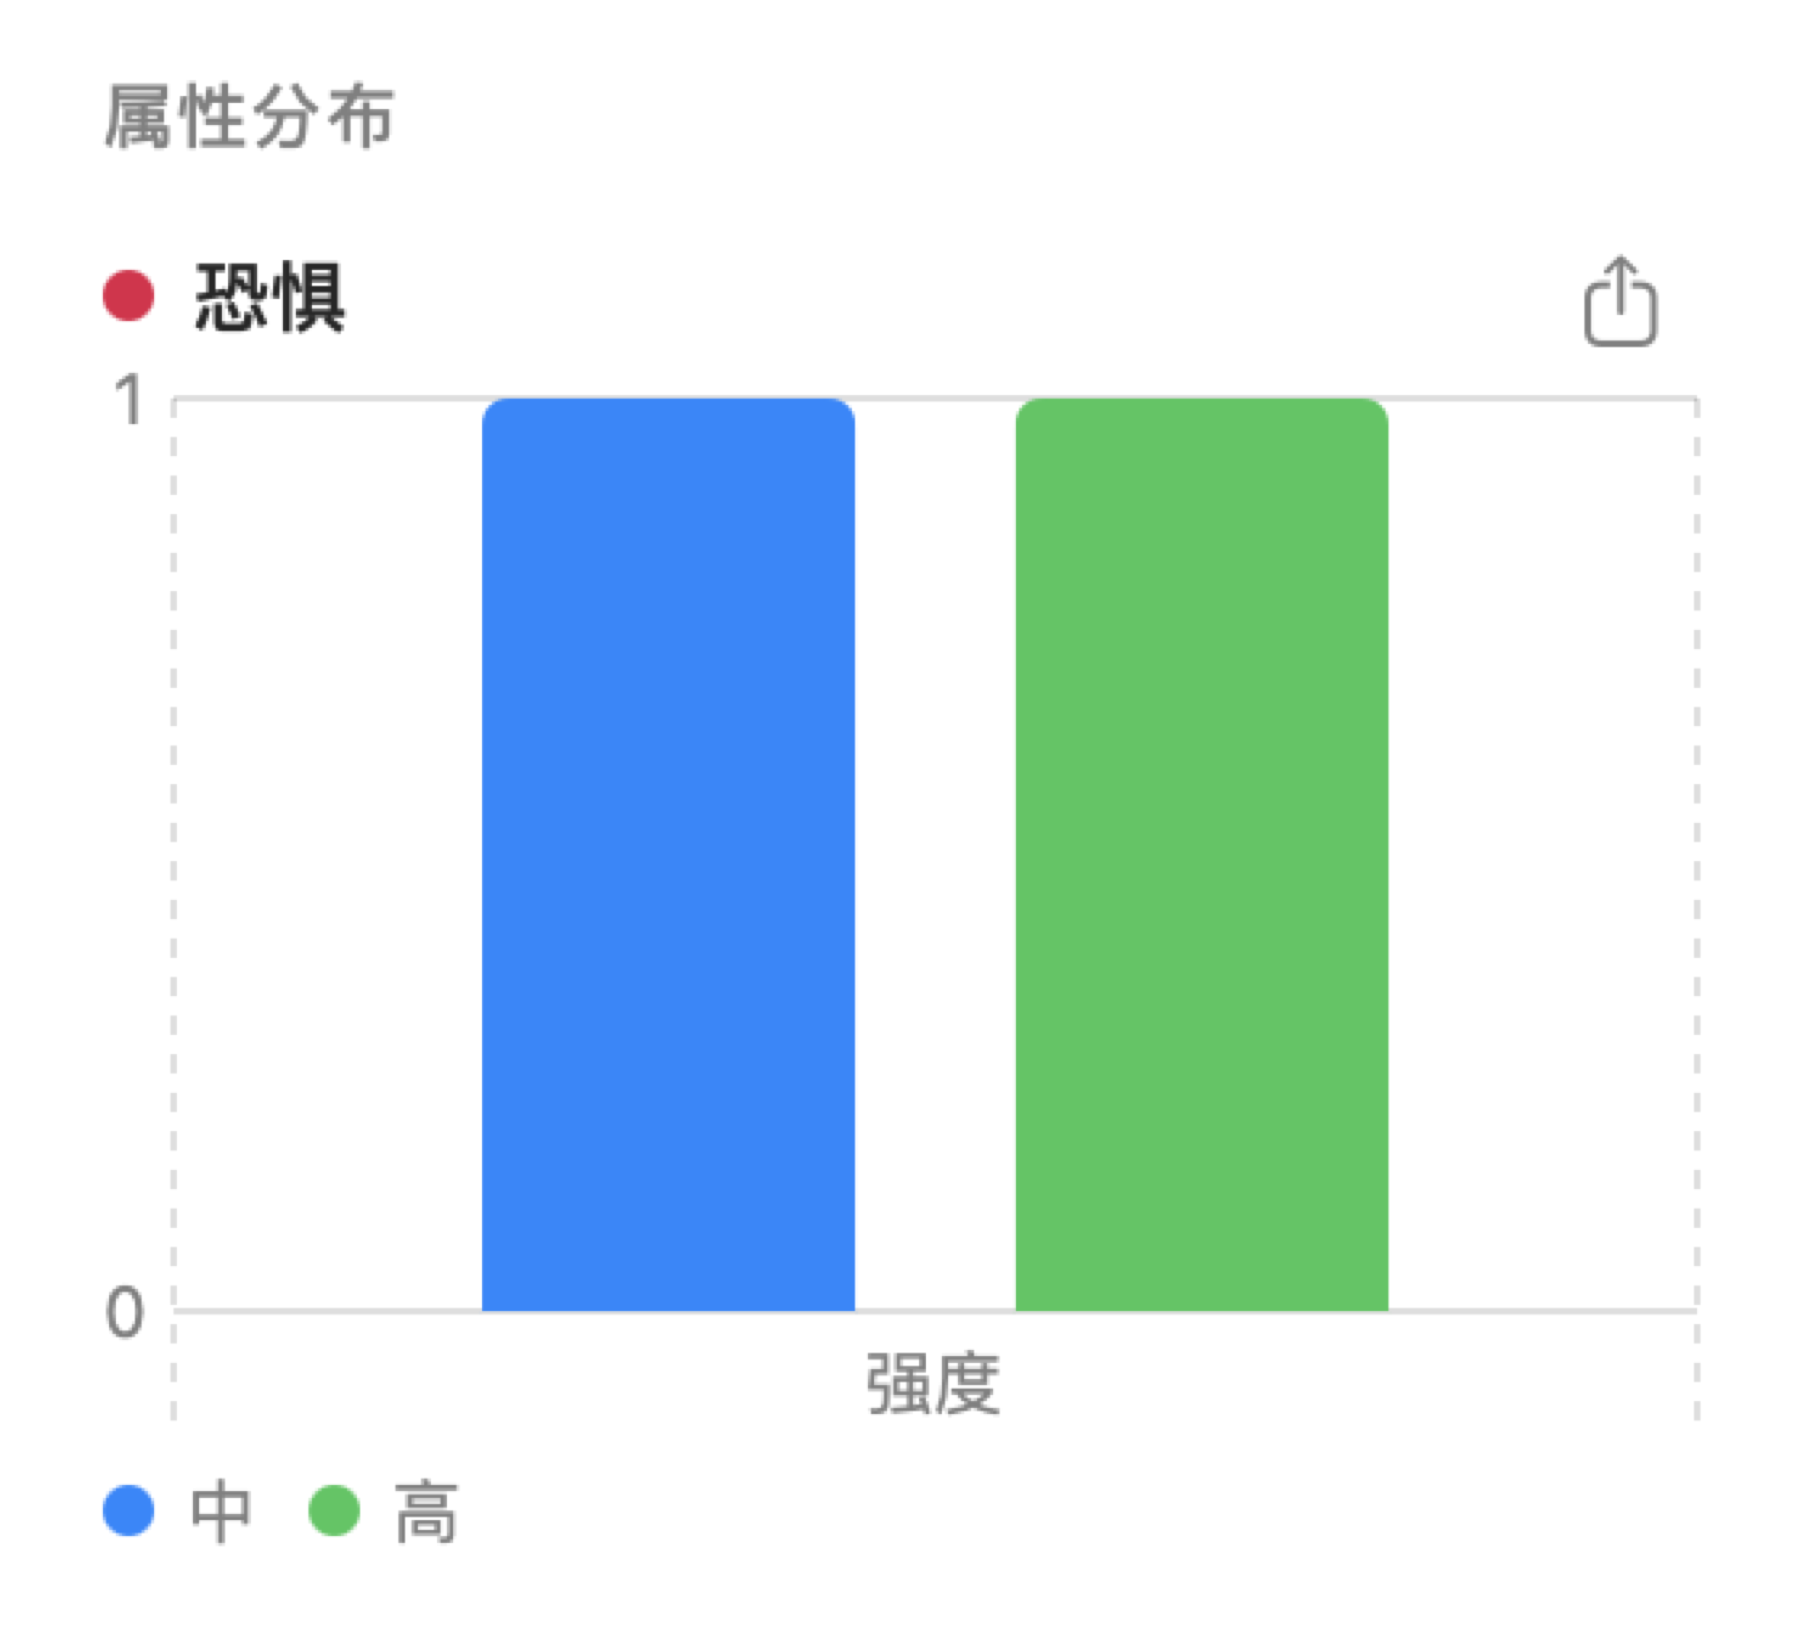
如果某个编码带有属性(见第 7 章“编码”中的带属性的编码),编码统计分面的末尾会出现一个名为属性分布的新部分。带有属性并且在当前文档中至少用过一次的每个编码,各有一张图表,显示它有多少个编码实例取各个值。在本章的例子中,假设“恐惧”这个编码有一个属性“强度”,它接受“低”“中”“高”三个选项。
编码的每个属性各有一簇条形,每个值一个条形。条形表示该属性取这个值的编码实例共有多少个。对于选择器(带有固定选项列表的属性),条形的顺序与用户在属性中定义的选项顺序一致;数字按从小到大排列,其他值按字母顺序排列,日期因此按先后排列。在该属性中没有值的编码实例显示在最后一个额外的条形中,以短横标示。图表下方的图例说明各个颜色对应哪个值。
假设“恐惧”在“我们为什么封路”中出现两次,一次的“强度”为“高”,另一次的“强度”为“中”。图表中就会有两个条形,按选项的顺序各对应其中一个值,每个条形的高度都是 1。
项目视图栏中的编码统计视图为项目、文档集和标签提供同样的部分;要列出取某个特定值的编码实例,可以筛选编码实例视图(见按属性值筛选)。
画像
画像分面用两种方式把当前文档的编码情况可视化。第一种是马赛克,显示各编码出现的顺序和片段的长短。第二种是编码行,列出带有任何编码的句子,并显示每个句子上的编码。
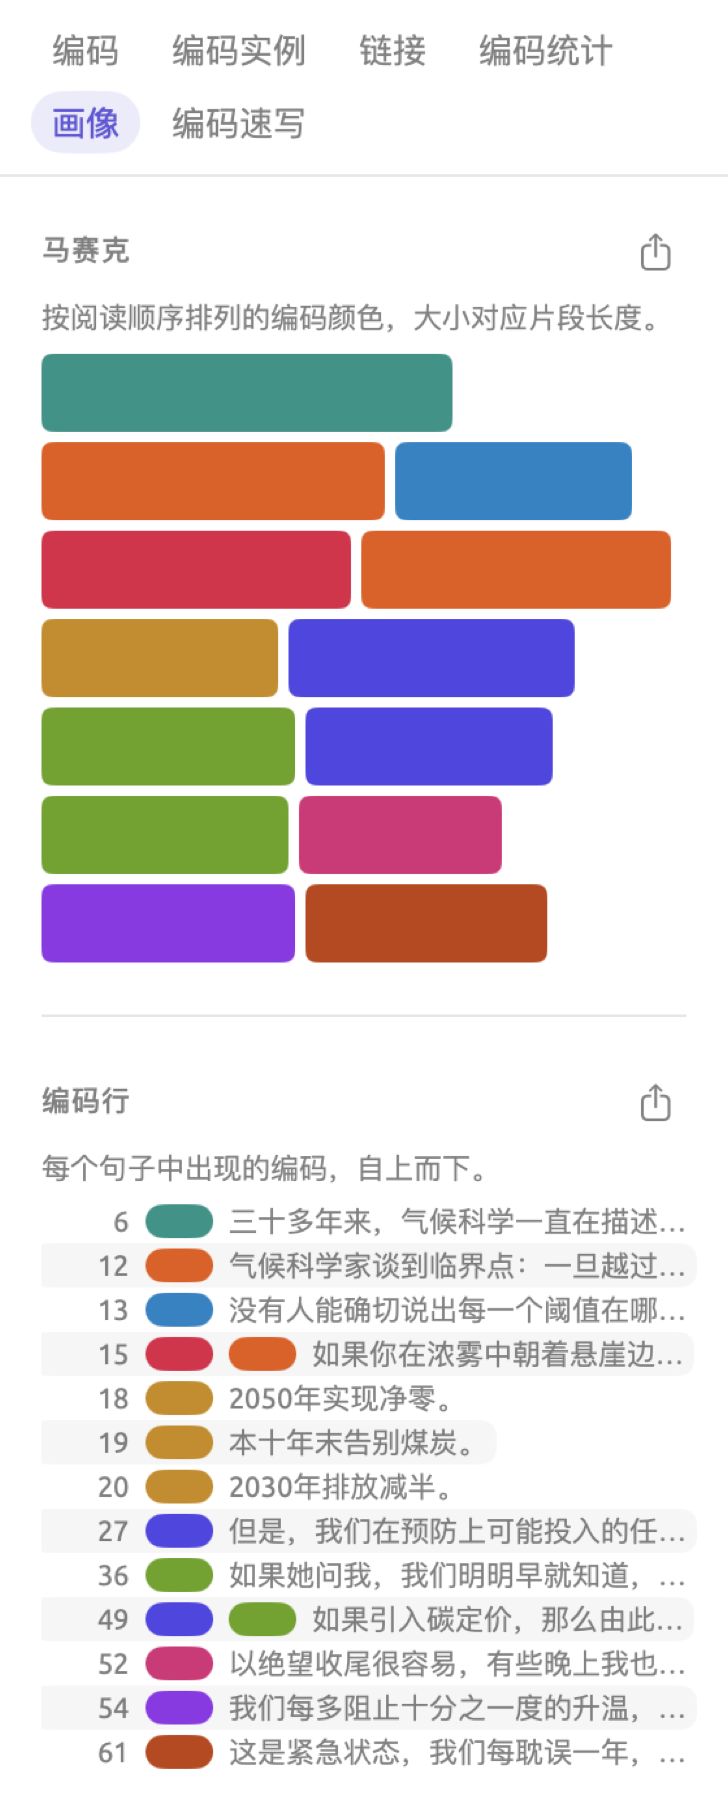
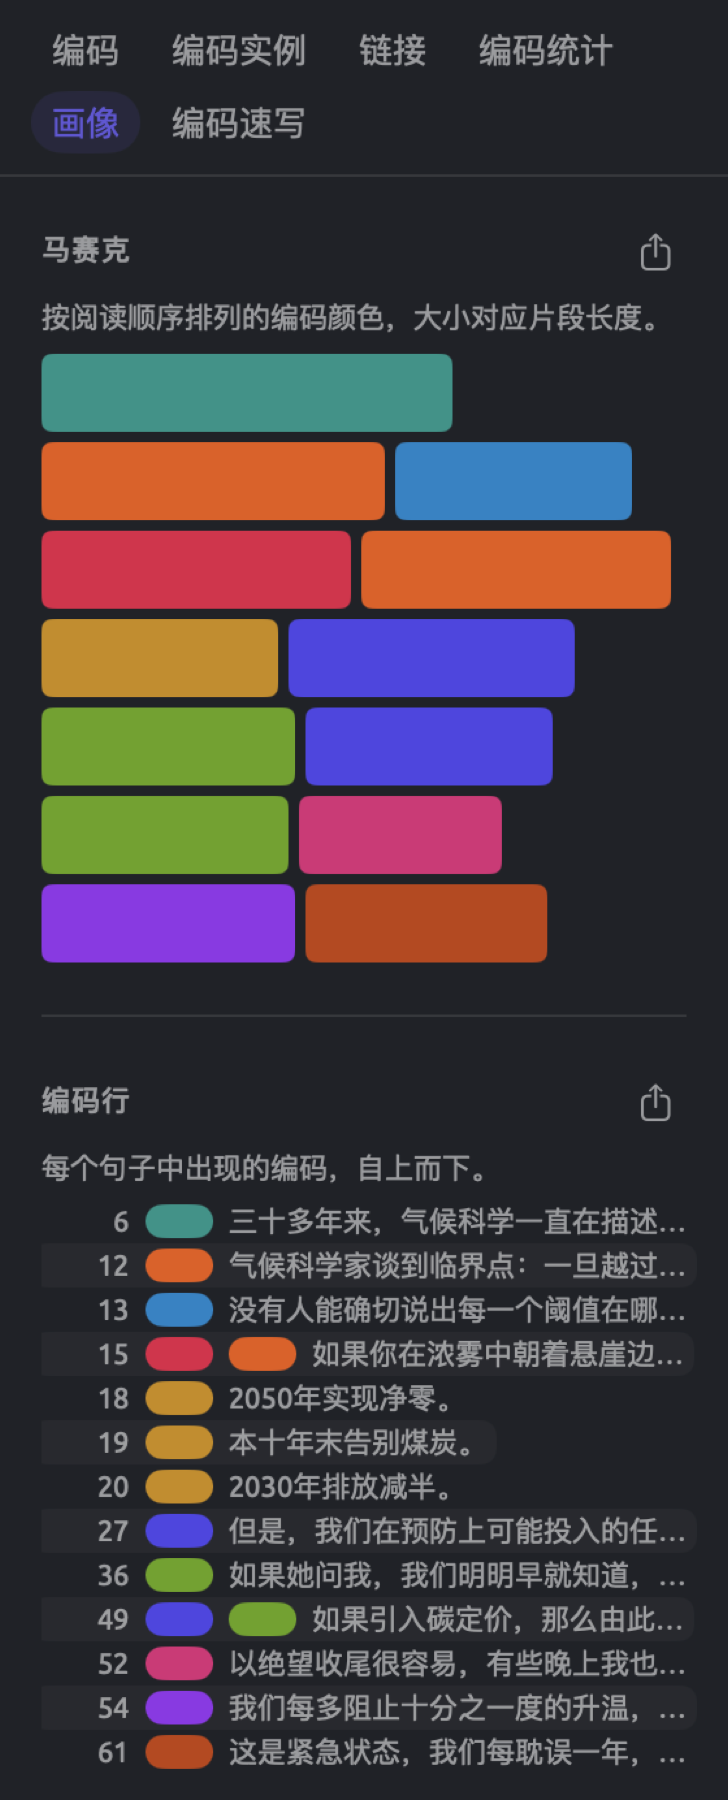
马赛克
马赛克把文档中的每个编码实例显示为一个色块,色块的颜色与其编码的颜色相同。色块按文本自然的阅读顺序从左到右排列,一行一行地显示。色块的宽度取决于对应片段的长度;最长的片段对应最宽的色块,即使最短的片段也有一个小方块。将鼠标指针悬停在色块上,可以看到编码的名称和色块所含的文本片段。点按色块,阅读器就会显示对应的段落。
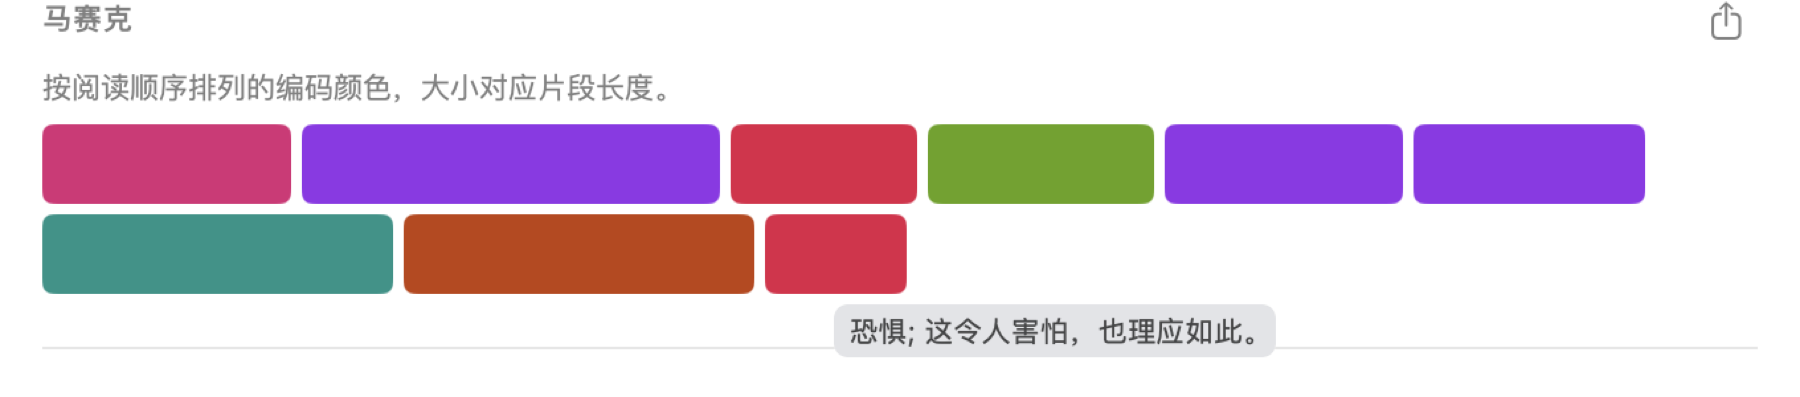
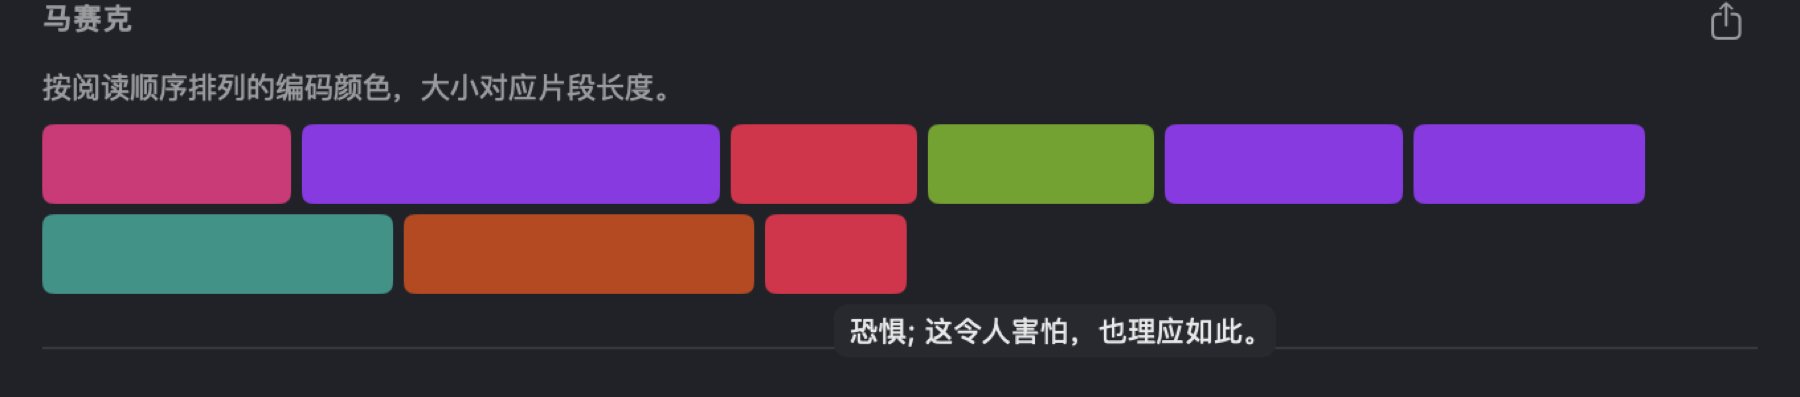
一连串同色的色块表示一段围绕同一主题的文字;颜色交替出现,说明文本在几个主题之间来回切换,或者你给相同的段落标注了几个编码。马赛克可以用来比较文本的结构。导出两篇文本的马赛克,把图片并排放在一起比较即可。每个马赛克都以自身最长的片段为基准缩放色块,所以在马赛克之间应当比较颜色的顺序和搭配,而不是色块的大小。
编码行
编码行中的每一行对应一个至少被一个编码实例触及的句子,按文本中的顺序排列。每行显示句子的序号、触及该句的每个编码实例的彩色条,以及句子开头的几个词。
将鼠标指针悬停在彩色条上,可以看到编码的名称。点按彩色条,即可在阅读器中查看这个编码实例。如果编码实例跨越多个句子,它会在每个句子中分别显示。两个编码触及同一个句子(两个彩色条在同一行)时,这两个编码就在这个句子中共现;因此,编码行能显示共现中某一对编码背后的句子。
编码行需要用到文档中的句子信息,而这些信息来自索引。因此,在为文档建立索引之前,编码行是空的。此外,句子索引适用于英语、德语和汉语文档;在其他所有语言中,编码行一直是空的(见第 21 章“分析与索引”中的无需分析即可使用的功能)。马赛克适用于所有文档。
编码速写
最后,编码速写分面显示某个词的语法搭配,并按覆盖该词各次出现的编码分组。这样,它可以告诉你在标注为“紧迫性”的片段中有哪些词与气候搭配,在标注为“科学”的片段中又有哪些词与它搭配,依此类推。对于文档集、标签或整个项目,项目视图栏中词汇速写视图的编码模式提供完全相同的可视化。关于编码速写的更多信息,请参阅第 12 章“词汇速写”中的编码速写。要逐列比较一个词在不同编码中的情况,请使用速写空间(见第 14 章“速写空间”)。
项目、文档集和标签的编码视图
项目视图栏中有七个与编码有关的视图,即编码本、编码实例、备忘录、链接、编码统计、编码矩阵和关系。在导航栏的项目下为整个项目选择某个视图时,这个视图会在单独的标签页中打开。在导航栏中选择某个文档集或标签时,它的标签页中有一排按钮,对应这个文档集或标签的各个视图。标签页打开时显示你最近为这个文档集或标签查看过的视图,第一次打开时显示编码本视图。如果需要让整个项目的某个视图一直留在阅读器旁边,可以点按视图标题栏右端的在窗口中打开按钮,在编码本窗口中打开它。
每个视图统计其范围内的原文文档;范围是项目的所有文档、文档集的成员,或者带有某个标签的文档。随着你继续工作,这些数字会相应更新。
关于其中三个视图的更多细节,请参阅第 7 章“编码”中的“编码本”视图、“备忘录”视图和“链接”视图。对于文档集或标签,它们显示以下内容:
- 编码本视图列出项目的每个编码,以及它在范围内文档中标注的片段数;所选编码的详细信息中,此范围内的使用和共现编码下的内容只涉及范围内的文档。
- 备忘录视图列出写在范围内文档及其段落上的备忘录。针对某个编码或整个项目的备忘录只出现在项目的备忘录视图中;从支持 REFI-QDA 标准的软件导入的项目可能带有这类备忘录。
- 链接视图列出至少有一个端点位于范围内文档或其译文中的所有链接。一个链接与它在译文中的副本只计一次。
“编码实例”视图
编码实例视图概览所选范围内的每个已编码段落。每行包含一个编码实例的详细信息,即文档、编码、片段和位置。也就是说,你是在单个段落的层面上查看自己的编码;可以检查不同文档中涉及某个主题时编码是否一致,也可以收集引文。片段列显示被编码段落的开头部分,位置列则给出这个段落在文档中的确切起点,从文档开头的 0 起按字符计数。各行先按文档标题的字母顺序排序,再按位置排序,所以每个文档的行都按阅读顺序排列。
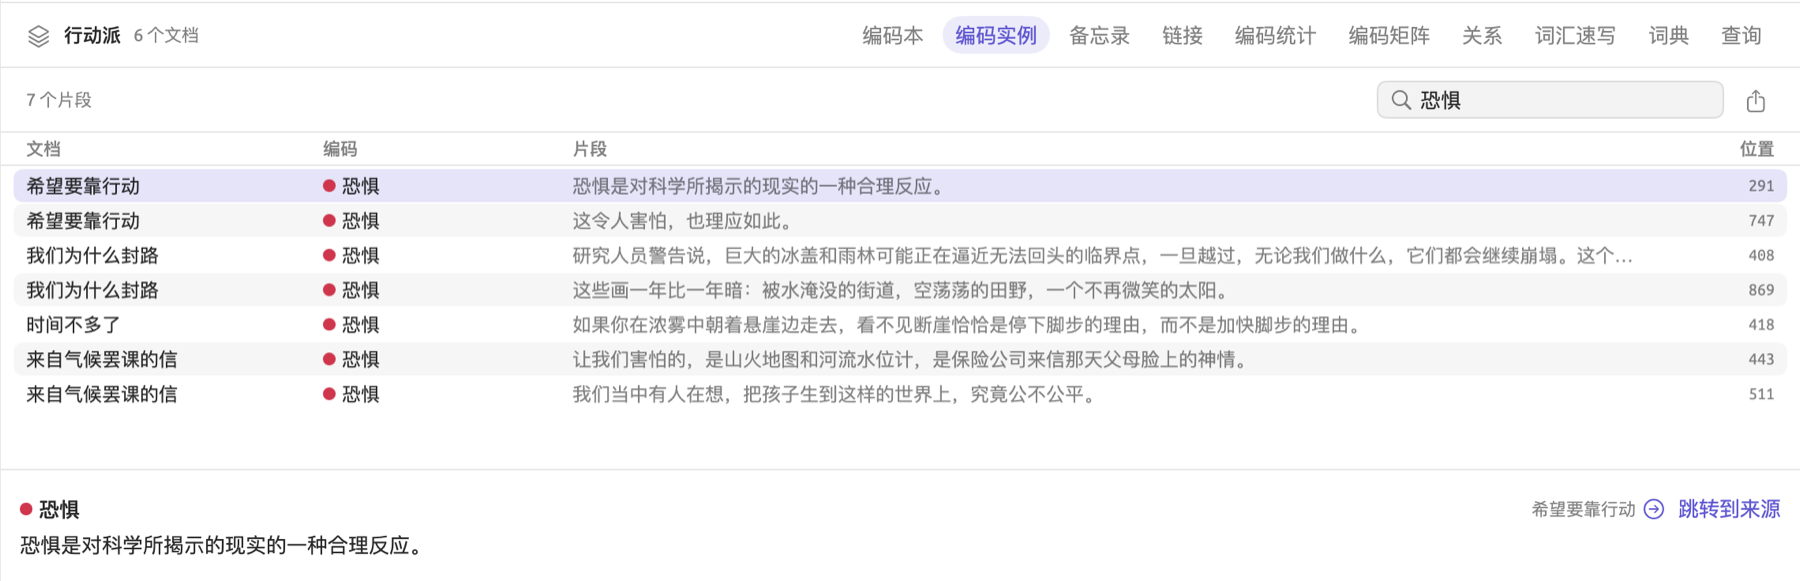
标题栏中显示的行数告诉你表格中有多少个片段,例如“行动派”文档集有 54 个片段。除了片段数,标题栏中还有搜索栏和导出按钮;如果列出的编码中有带属性的,还有筛选按钮。
- 点按一行,表格下方的窗格中就会显示完整的片段,包括它的编码、所在文档和属性值。你可以在窗格中设置或更改它的属性值。要调整表格与窗格在窗口中所占的比例,请拖动两者之间的分界线。
- 连按一行、按下 Return 键,或者点按窗格中的跳转到来源,相应的文档就会打开,并定位到这一行的片段。
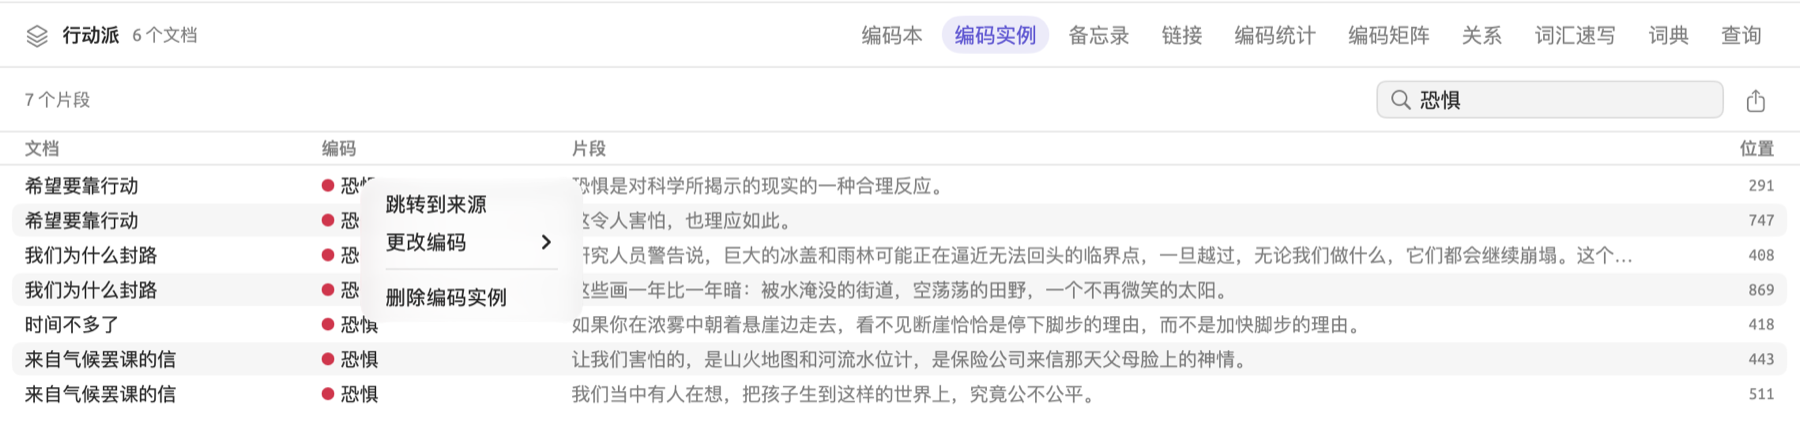
- 右键点按一行,会打开快捷菜单,其中有跳转到来源、更改编码和删除编码实例。要给某个片段现有的编码实例换一个编码,请点按更改编码(见第 7 章“编码”中的“编码实例”分面);这两种更改都可以用编辑 ▸ 撤销(⌘Z)撤回。
- 在搜索栏中输入文字,就只保留任一字段中含有这些文字的行。这些字段是编码名称、被编码的文本和文档标题。
由于搜索也会检查被编码的文本和文档标题,在“行动派”文档集中搜索“希望”,还会列出“希望要靠行动”的每个片段。如果只想查看属于某一个编码的片段,请从其他视图打开它们,方法见下文。
数字背后的片段
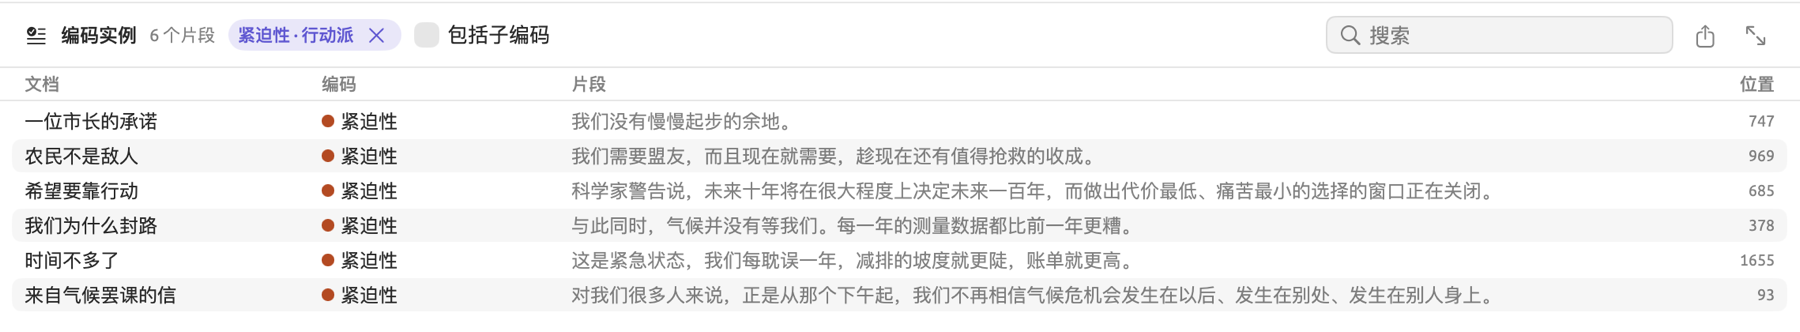
其他编码视图也可以在编码实例视图中显示其数字背后的段落。方法是连按编码统计中的任意条形或行、编码矩阵中的任意单元格,或者关系中的任意单元格或配对;也可以右键点按任意行、单元格或配对,然后从快捷菜单中选取显示编码实例。编码实例打开后,会载入你所选数字背后的编码实例,标题栏会说明载入的是哪些片段。例如在“气候辩论”中,对于行动派文本中的所有“紧迫性”编码实例,标题栏显示为紧迫性 · 行动派。编码本中的显示编码实例也按前面所述的方式工作(见第 7 章“编码”中的“编码本”视图)。
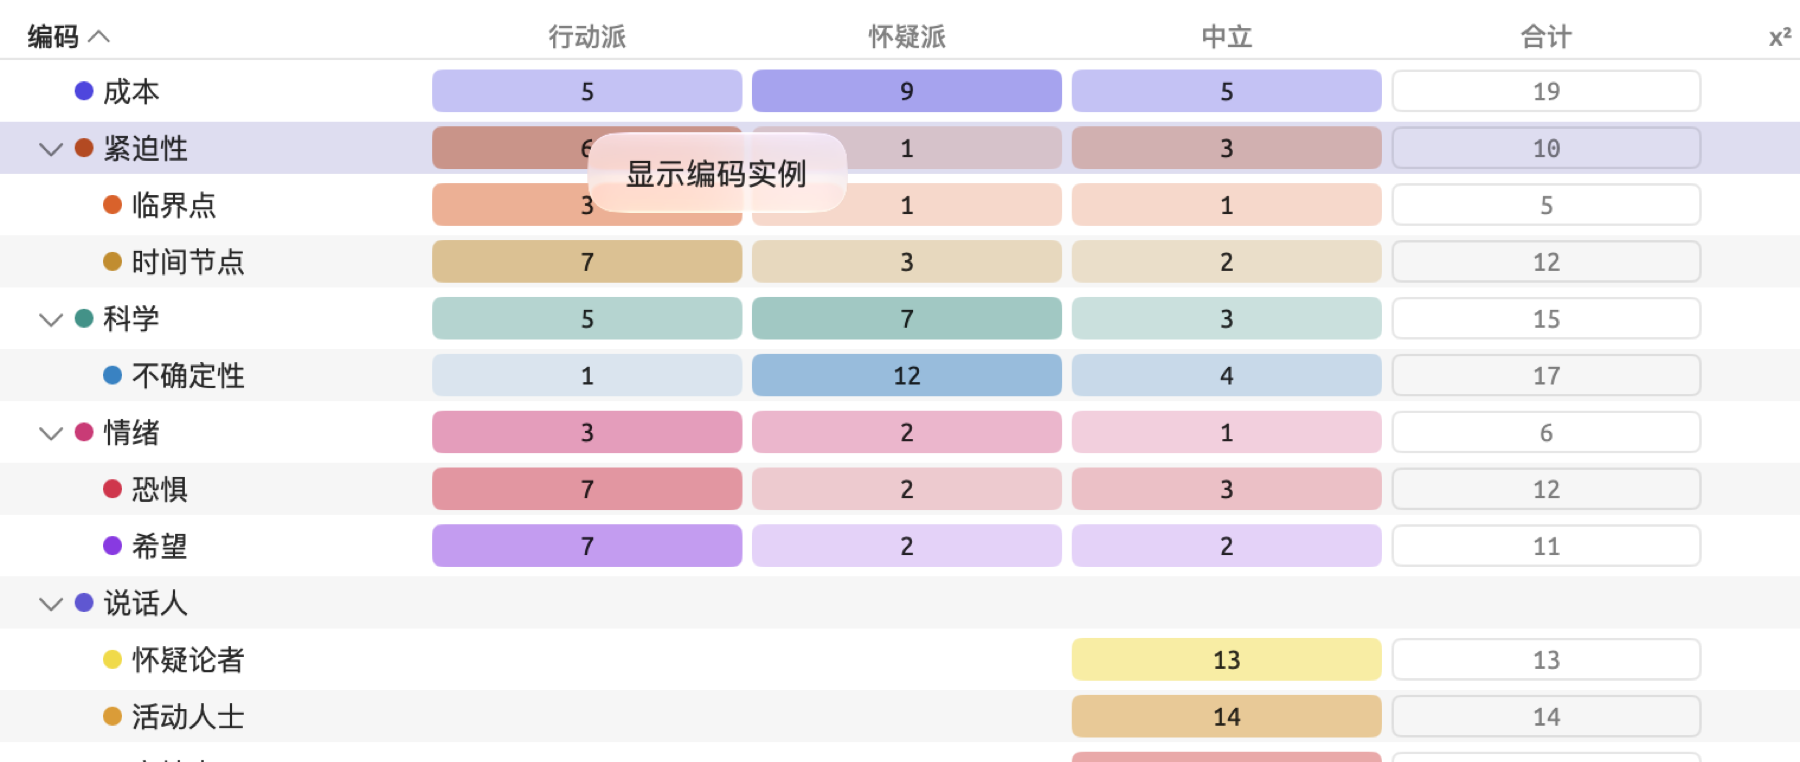
这里的数字只统计所显示的编码本身,不包括它的子编码。要把子编码包括进来,请勾选编码名称旁边的包括子编码复选框。如果这个编码没有子编码,包括子编码复选框不可用,并显示悬停提示没有子编码。搜索栏和属性筛选可以进一步缩小结果。点按编码名称旁边的 × 按钮(移除筛选),会重新显示所有编码实例;用其他任何方式打开编码实例,也是如此。
按属性值筛选
如果列表中有编码带有属性,搜索栏旁边就会出现筛选按钮,它的图标是圆圈中的漏斗。筛选把结果限定为属性值满足某个条件的编码实例,例如行动派文本中最强烈的恐惧。假设“恐惧”有属性“强度”,在“行动派”文档集中筛选“强度”是以下任一“高”,就只剩下 7 个“恐惧”编码实例中的 3 个,计数因此变为 3 个片段。
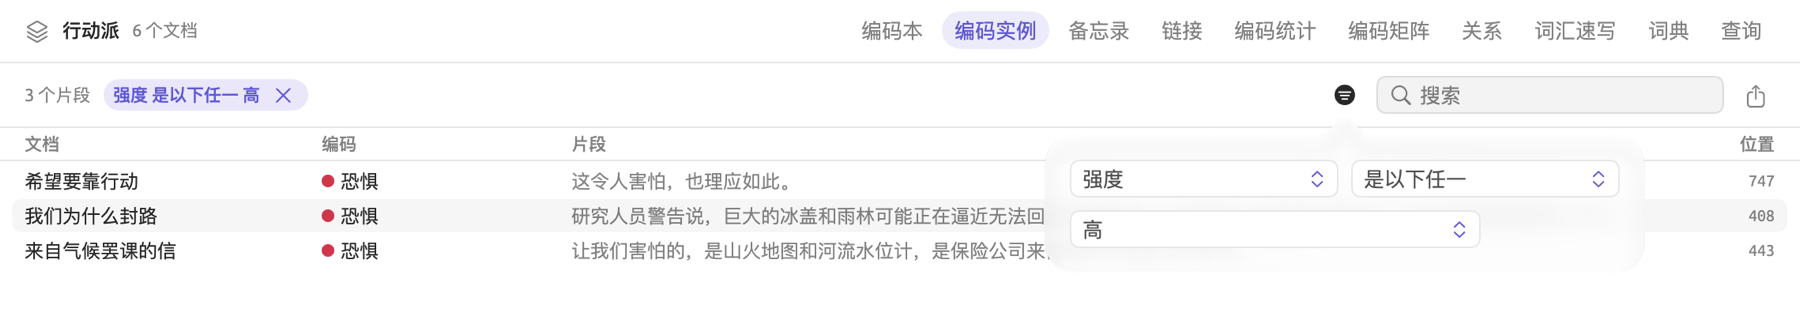
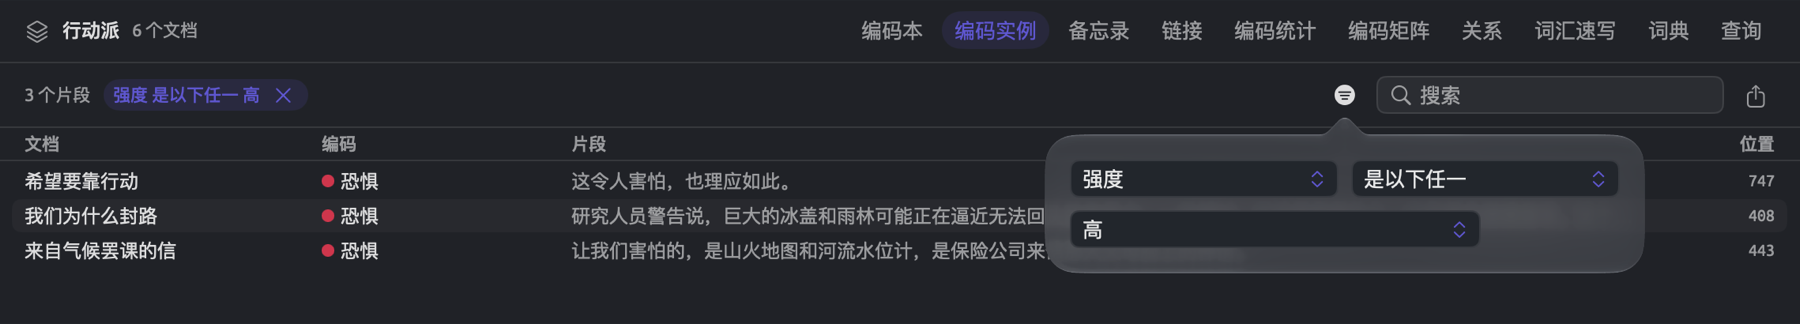
要按属性筛选片段:
- 打开项目、文档集或标签的编码实例视图。
- 点按筛选按钮。
- 在弹出窗口的第一个菜单(显示为无)中,选取属性。
- 在旁边的菜单中,选取一种比较方式,例如是以下任一。
- 设置值。对于选择器,点按下方显示为无的按钮,然后勾选一个选项。
标题栏会写明筛选条件(例如强度 是以下任一 高),在筛选停用之前,漏斗图标呈实心。点按筛选名称旁边的 × 图标(移除筛选),会完全移除筛选,重新显示所有片段;在弹出窗口的第一个菜单中选取无,效果相同。
第二个菜单中的比较方式取决于属性的类型,与智能文档集条件中的情况大致相同(见第 8 章“文档集、分组、标签和属性”中的属性的比较方式)。选择器提供是以下任一、不是以下任何、为空和不为空;数字属性则有至少为、介于等选项。
筛选只作用于带有指定属性的编码;筛选期间,不带这个属性的编码的编码实例都会被隐藏。第一个菜单列出范围内各编码所有可用的属性。如果几个编码有名称和类型都相同的属性,例如“恐惧”上的“强度”和“希望”上的“强度”,菜单中只出现一次“强度”,筛选同时作用于这两个编码。
导出片段
导出按钮把当前显示的行存储为 CSV 文件,所以文件已经反映了你在导出之前在视图中所做的搜索和筛选。请注意,文件中的“开始”和“结束”位置与位置一样,都从 0 开始按字符计数。列表为空时,按钮不可用,悬停提示为没有可导出的内容。
“编码统计”视图
编码统计视图统计所选范围内每个编码出现的次数。顶部是一张条形图,每个条形代表一个编码,颜色与该编码相同。条形图下方的表格列出每个编码的片段数、文档数和覆盖率;表格中只列出在范围内有片段的编码。
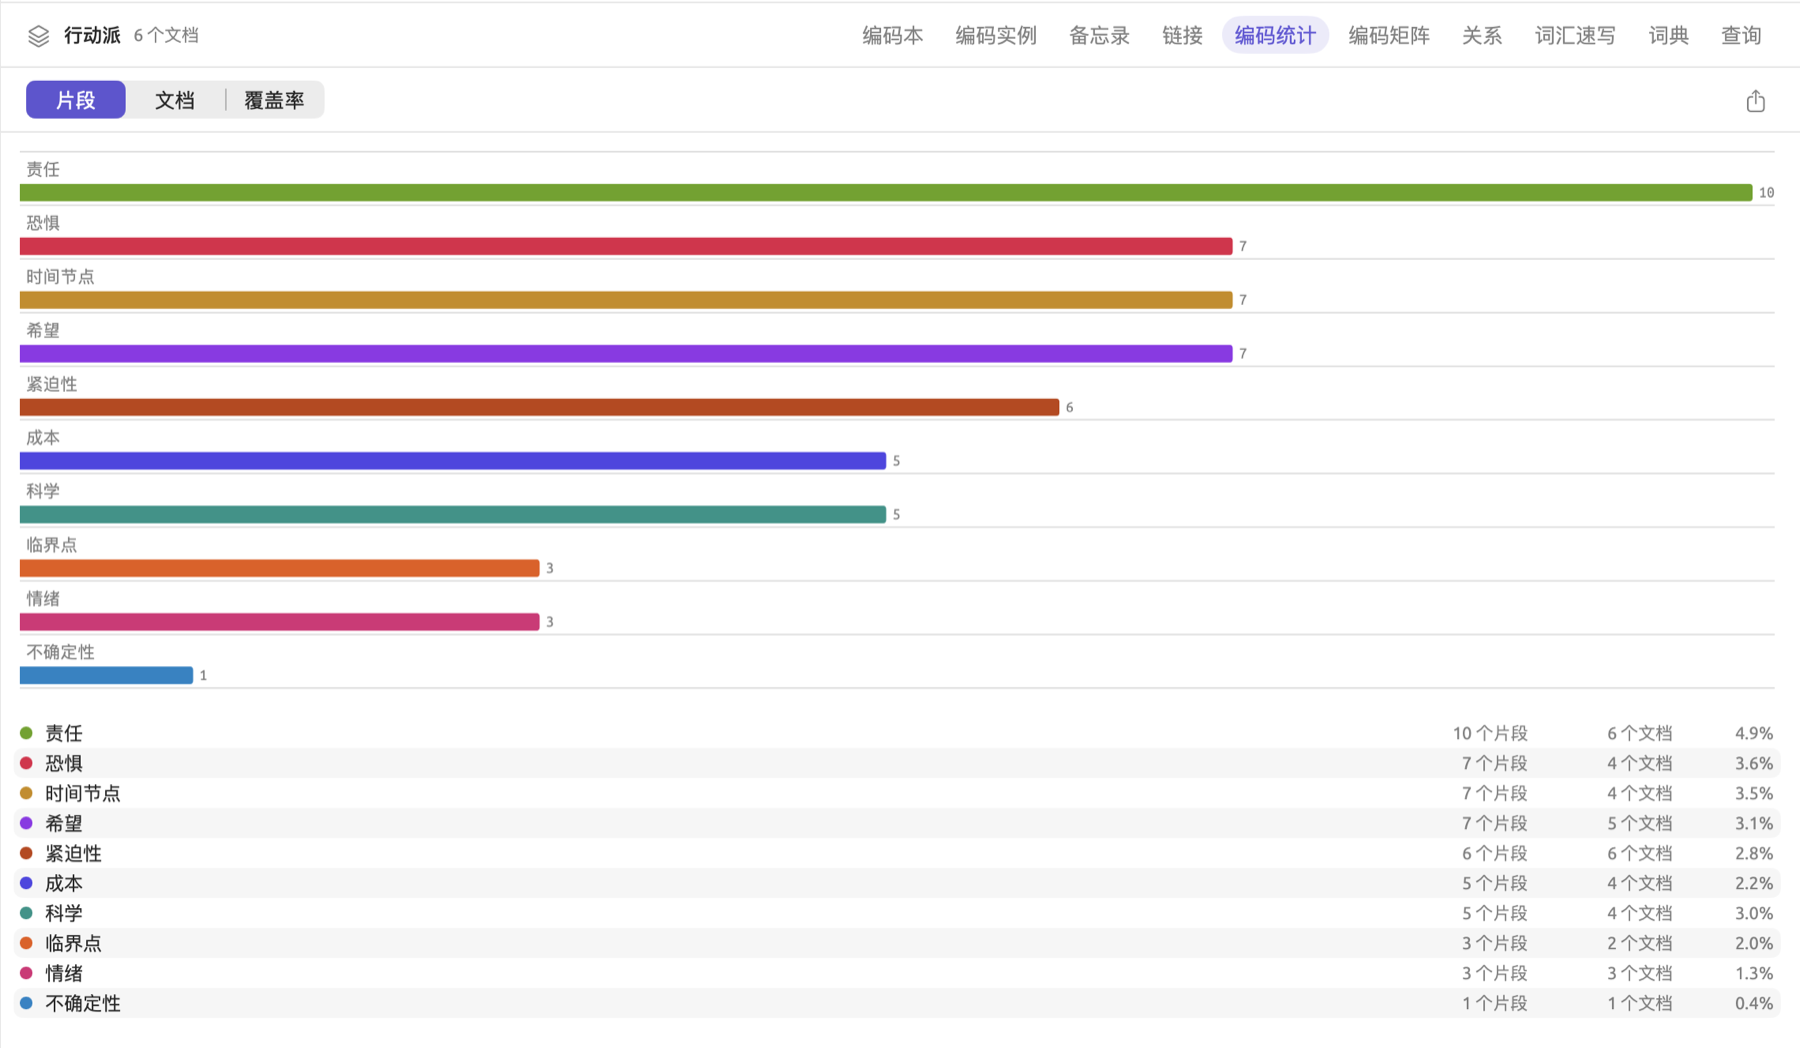
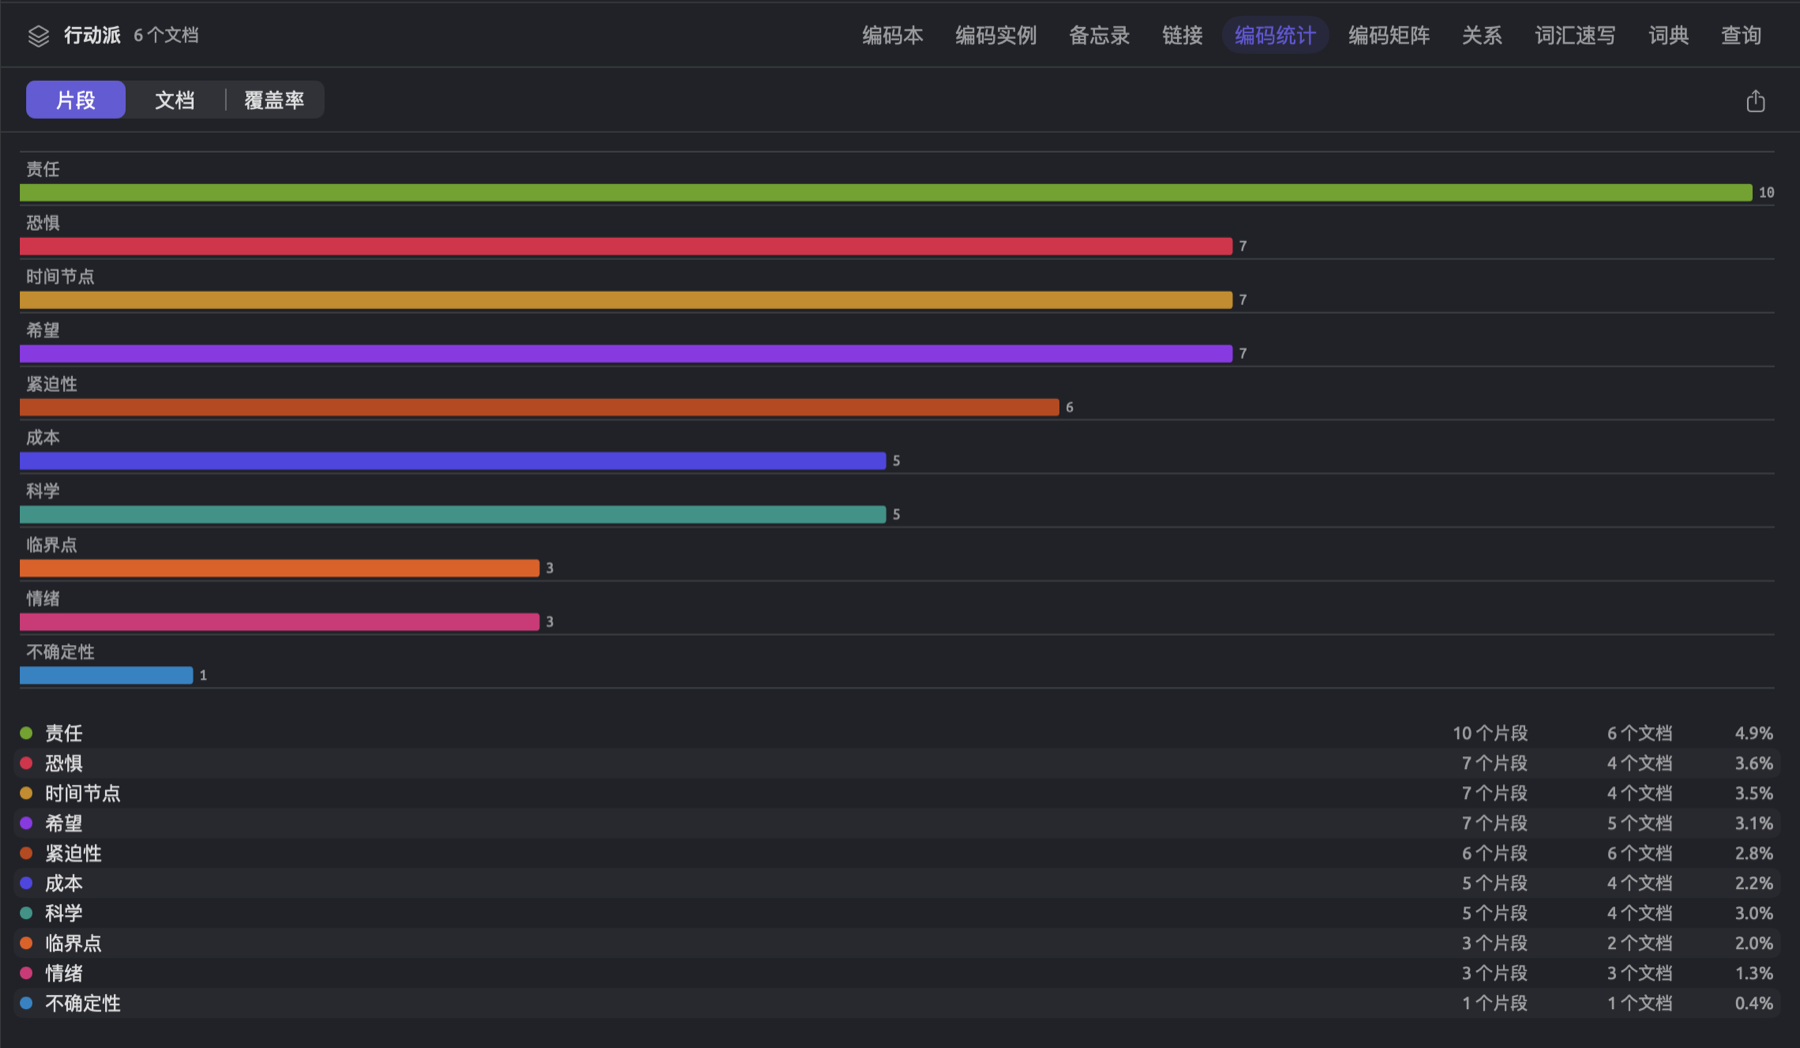
用标题栏中的切换控件(片段、文档和覆盖率)可以选择条形显示哪个度量,数值显示在条形的末端。无论切换控件选的是哪一项,编码总是按片段数从多到少排列。连按条形或行,可以在编码实例视图中阅读这个编码的片段;也可以右键点按这一行,从快捷菜单中选取显示编码实例。
- 片段是该编码在范围内的编码实例总数。
- 文档是范围内至少含有该编码一个编码实例的不同文档的数量。
- 覆盖率是该编码的片段所跨越的字符相对于范围内字符总数的比例。
涉及多个文档时, 是该编码在各个文档中覆盖的字符数之和, 是范围内所有文档的字符数,无论这些文档是否有编码。仍用虚构的整数,假设“行动派”文档集的六个文档共有 20,000 个字符。“时间节点”编码的七个片段分布在四个文档中,共覆盖 640 个字符。表格显示 7 个片段和 4 个文档,覆盖率的计算如下:
文档显示编码在文档之间的分布。“责任”编码的 10 个片段分布在全部六个文档中,而“时间节点”编码的七个片段分布在四个文档中。覆盖率则显示这些片段是寥寥几个字符还是大段的文本。由于覆盖率是占整个范围的比例,范围越大,覆盖率就越低。在整个项目的编码统计中, 还包括怀疑派文档和其他文本的字符,所以怀疑派很少使用的编码(例如“紧迫性”),即使片段没有任何变化,覆盖率也会下降。
表格下方的属性分布与分面中的完全相同(见上文的属性分布)。按照假设的“强度”属性,“行动派”文档集中“恐惧”编码的分布图把它的七个编码实例显示为“低”1 个、“中”2 个、“高”3 个,另有 1 个编码实例没有值。
编码矩阵
编码矩阵是一张表格,范围内的每个编码占一行,同一范围内的每个文档占一列。单元格给出每个编码在相应文档中的片段数。最后的合计列给出每个编码在整个范围内的合计,与编码统计给出的数字一致。编码矩阵用来查看哪些文档涉及哪些主题,也可以通过为列分组来比较几组文档(见下文的列分组)。
编码按编码本的顺序排列,子编码列在其上级编码之下。如果某个上级编码本身没有直接标注任何段落,例如项目中的“说话人”,它仍然在子编码上方占一行,尽管单元格都是空的。范围内的每个文档都有自己的一列,无论其中有没有编码实例。
单元格按所属的编码以及其中该编码的片段数着色,片段最多的单元格以该编码的颜色着色最深。空单元格表示零。合计列加边框,不着色。
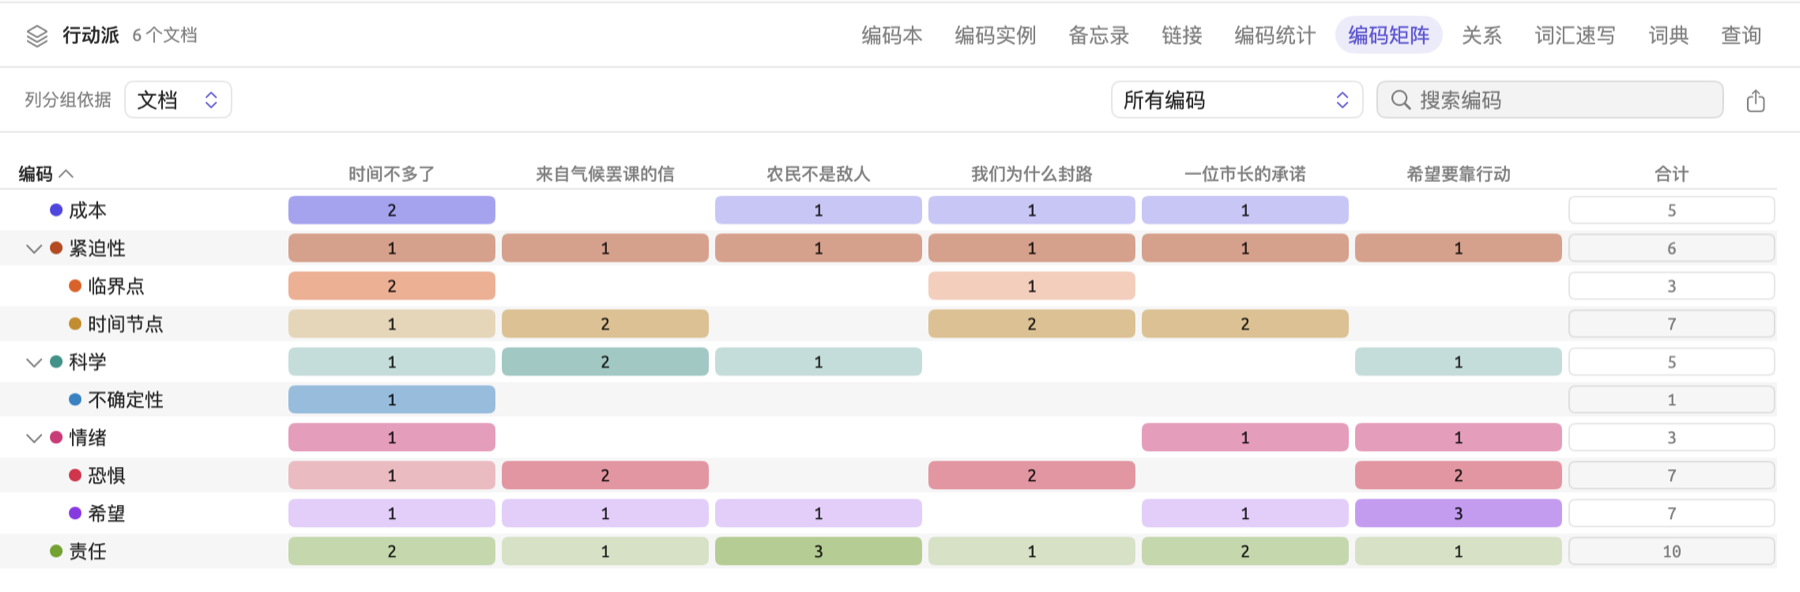
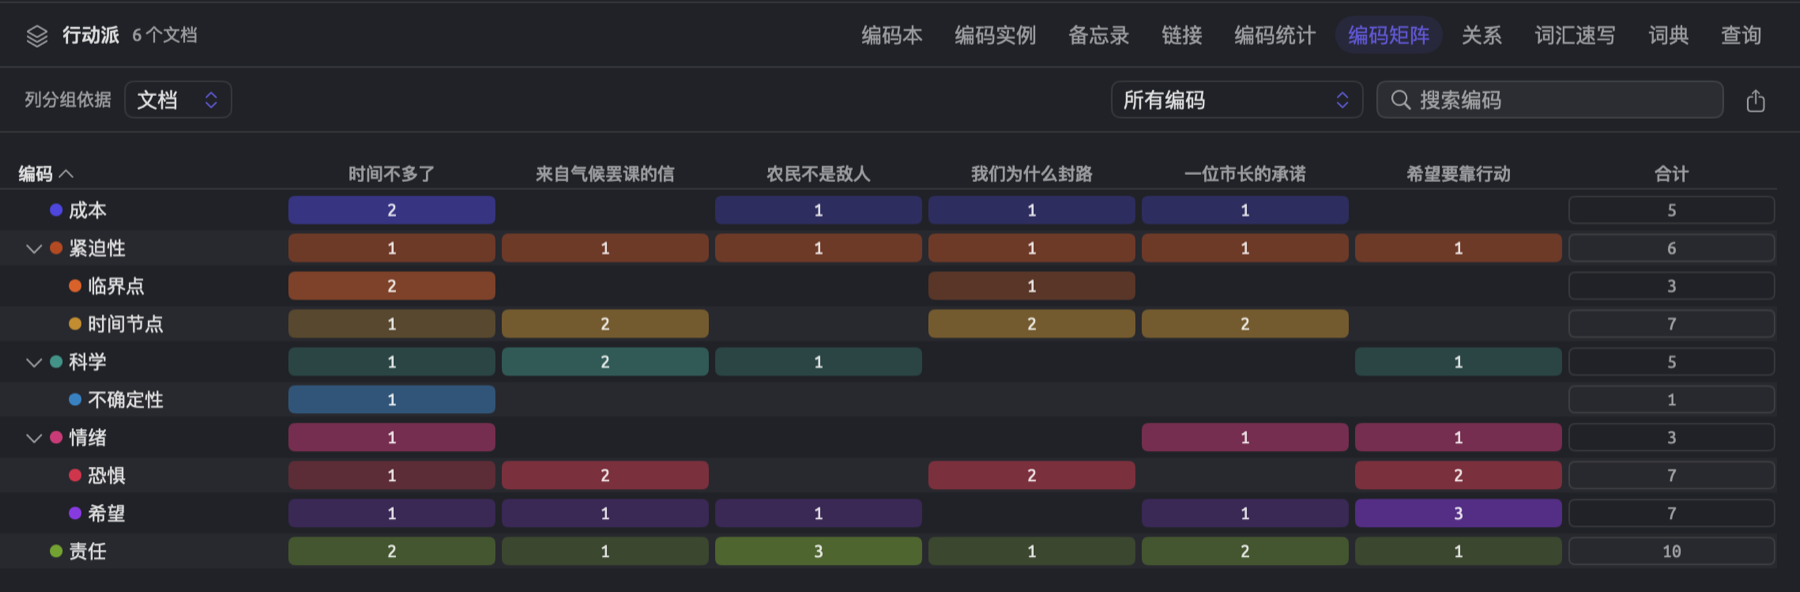
下面是“行动派”文档集编码矩阵中的三行:
| 编码 | 时间不多了 | 来自气候罢课的信 | 农民不是敌人 | 我们为什么封路 | 一位市长的承诺 | 希望要靠行动 | 合计 |
|---|---|---|---|---|---|---|---|
| 时间节点 | 1 | 2 | 2 | 2 | 7 | ||
| 希望 | 1 | 1 | 1 | 1 | 3 | 7 | |
| 责任 | 2 | 1 | 3 | 1 | 2 | 1 | 10 |
横着读一行,可以看出一个编码在各文档中的分布。例如,“责任”出现在所有文档中,而“希望”的七个片段中有三个在“希望要靠行动”里。竖着读一列,可以看出这个文档倚重哪些主题。先在数据中寻找规律(某组文档中完全没有的编码,或者反过来,主要集中在单个文档中的编码),然后连按单元格,或者右键点按单元格并选取显示编码实例,在编码实例视图中显示它的段落。请注意,计数随文档长度和你划分片段的细致程度而增长,所以长文档比短文档更容易填满自己的那一列。
每个矩阵上方都是标题栏,矩阵的工具就在其中:
- 列分组依据用来把文档合并成组(详见列分组)。
- 编码菜单(所有编码)把矩阵的行限定为一个编码集(例如“气候辩论”中的“论点”),或者一个上级编码及其子编码。
- 搜索编码只保留名称中包含所输入文字的编码。
- 最后,导出按钮用来导出表格(见导出表格和图表)。
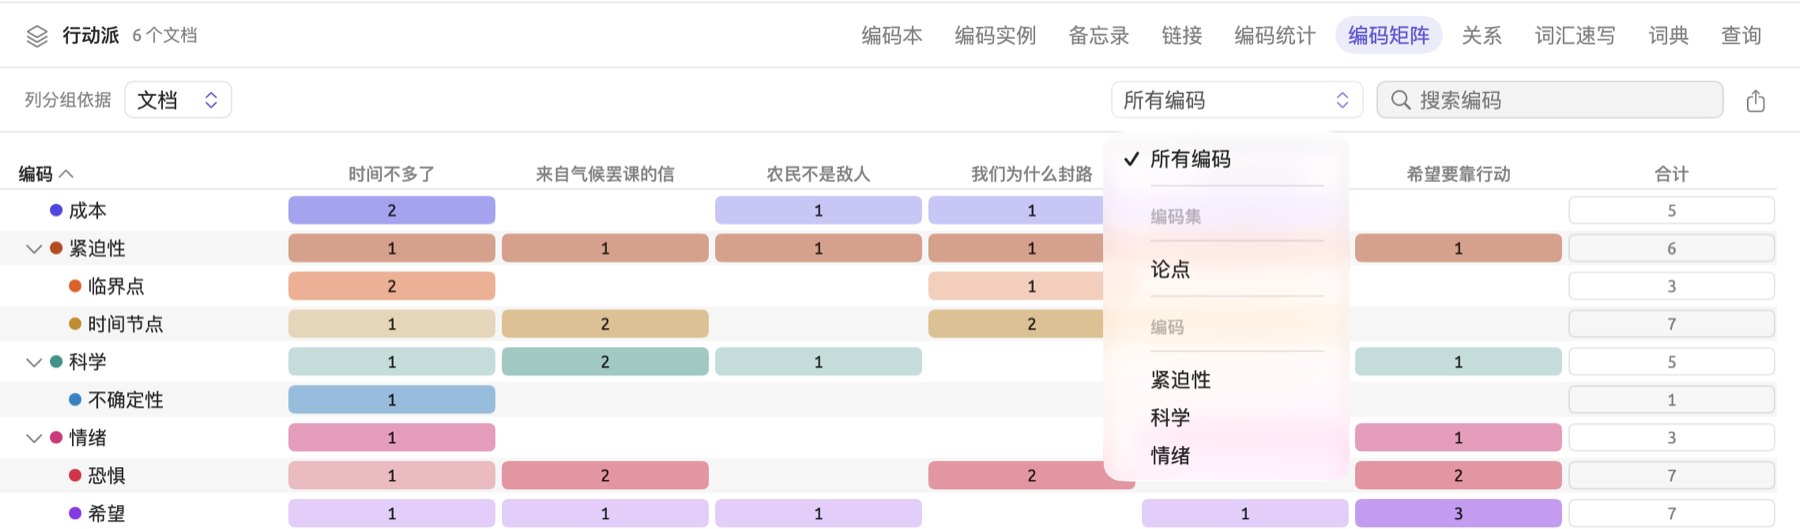
点按列标题,各行就按这一列从高到低排序(p 列从最小的 p 开始);再点按一次,顺序反过来。点按文档的列标题,各行按这个文档中使用最多的编码排序。点按编码列标题,矩阵的行会恢复为编码本顺序。只有在这个顺序下,LemmaLoom 才会缩进子编码,你也才能用上级编码旁边的箭头把它折叠起来。
列分组
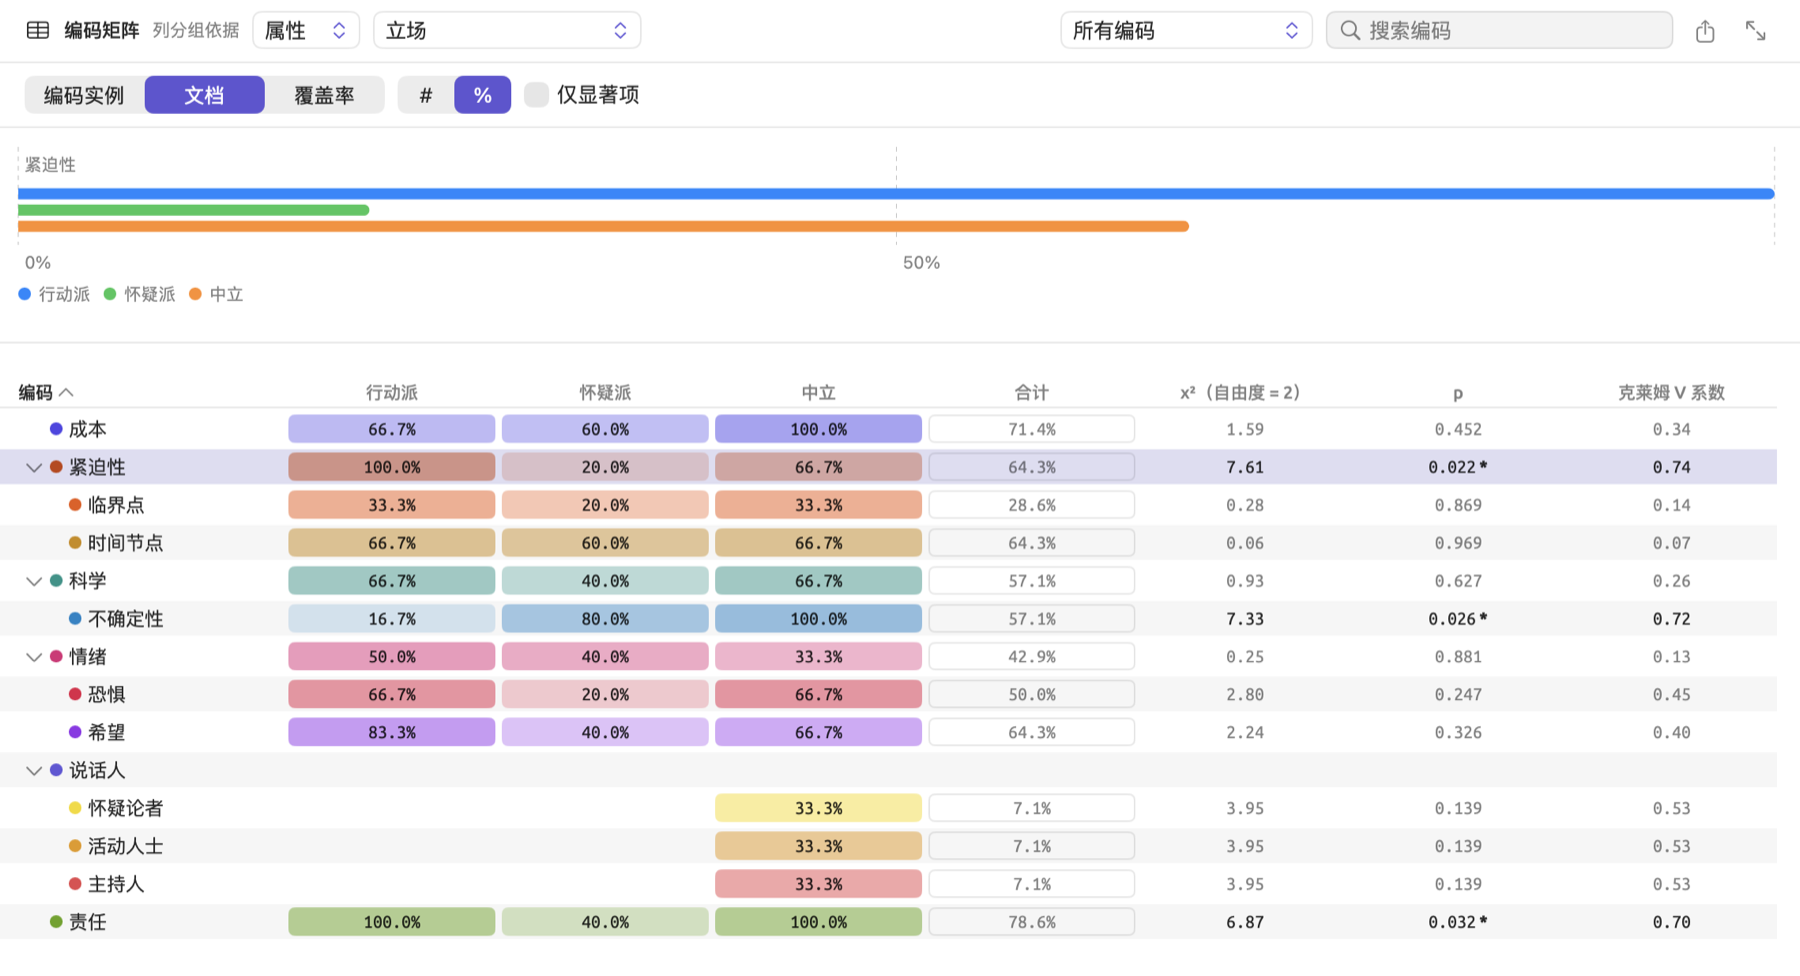
列分组依据把编码矩阵的列重新排列为共有某个值的文档组。这样就可以比较不同类型的文档,例如行动派和怀疑派,或者纸媒和网络。“气候辩论”为每个原文文档都指定了一个“立场”值,因此可以按立场为文档分组,比较行动派、怀疑派和中立来源。下图是项目的编码矩阵按“立场”属性分组后的样子,单元格中显示文档的百分比。
要比较几组文档:
- 打开项目、文档集或标签的编码矩阵。
- 在列分组依据中,选取属性、分组、语言或格式。
- 如果选的是属性,就在旁边出现的菜单中选取属性,例如“立场”。
- 在标题栏下方出现的那一行中,选择单元格统计什么,以及显示计数(#)还是百分比(%)。
这时视图包含两个窗格,中间有一条分隔线。上方是一张条形图,显示你在下方表格窗格中选中的编码,每个组一个条形,各用不同的颜色,图下方有图例。移动分隔线,可以给任一窗格更多空间。
列分组依据提供以下分组选项:
| 选项 | 列 |
|---|---|
| 文档 | 每个文档一列,即未分组的矩阵 |
| 属性 | 你在第二个菜单中选择的文档属性,每个值一列。项目中有属性时才提供。 |
| 分组 | 每个文档分组一列,例如“纸媒”和“网络”;不属于任何分组的文档归入未分组 |
| 语言 | 每种语言一列 |
| 格式 | 每种文档类型一列(文本、PDF、网页、音频或视频),以范围内实际有的类型为限 |
没有值的文档单独组成一列,名为无值。“气候辩论”中的所有原文文档都有“立场”值,所以按“立场”分组会得到三列;“行动派”包含六篇行动派文本,“怀疑派”包含五篇怀疑派文本,“中立”包含其余三篇文本(“2024 热浪报告”“碳税之争”和“电台辩论”)。按分组划分文档时,两个未分组的文档“2024 热浪报告”和“碳税之争”单独组成一列,名为未分组。每个文档只属于一列。
各列按值的顺序排列。对于选择器,是选项的顺序;对于数字和日期,是升序。文本和语言按字母顺序排列。文档分组之间的顺序与它们在导航栏中的顺序相同。无值列和未分组列总是排在最后。范围内有文档的分组、语言或格式,都会显示为一列。
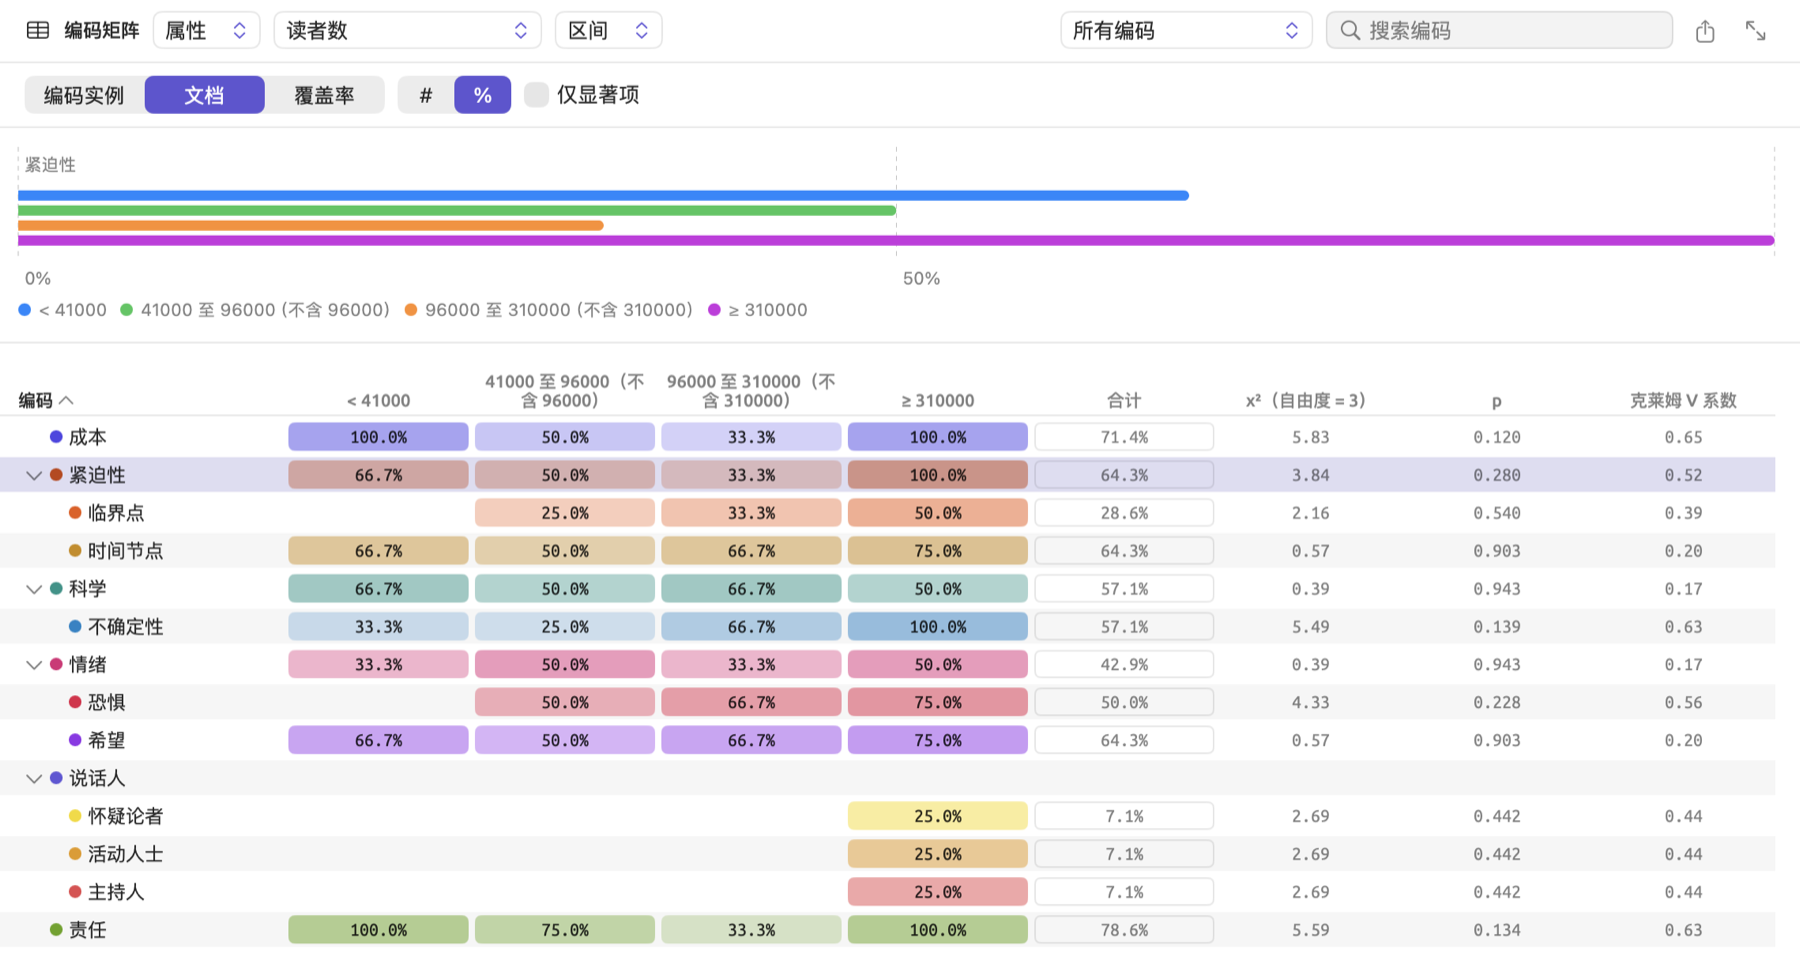
对于数字和日期属性,属性名称旁边还会多出一个菜单。数字属性的这个菜单显示区间或取值,日期属性的显示年份或月份,它决定属性值如何划分成列:
| 属性类型 | 第三个菜单 | 列 |
|---|---|---|
| 整数、小数 | 区间(第一个选项) | 最多四个区间,每个区间约包含有值文档的四分之一 |
| 取值 | 每个值一列 | |
| 日期 | 年份(第一个选项) | 每年一列 |
| 月份 | 每月一列,例如 2024 年 9 月 | |
| 文本、选择器、布尔值 | (无) | 每个值一列;布尔值为是和否 |
区间根据范围内的值计算。LemmaLoom 先把值从低到高排序,再把值的个数分别乘以四分之一、二分之一和四分之三,乘积如有小数则舍去,最后取排在这么多个值之后的那个值作为分界。以“气候辩论”的十四个原文文档为例,“读者数”的值依次为 3,100、8,500、23,000、41,000、57,000、68,000、72,000、96,000、186,000、254,000、310,000、398,000、412,000 和 875,000。由于 、、,分界分别是第 4、第 8 和第 11 个值,即 41,000、96,000 和 310,000。因此,各区间列为 < 41000、41000 至 96000(不含 96000)、96000 至 310000(不含 310000)和 ≥ 310000,分别有 3、4、3、4 个文档。区间包含下限,不包含上限。也就是说,“读者数”为 96,000 的“模型总是失准”这样的文档属于 96000 至 310000(不含 310000)。如果几个文档的值相同,区间可能少于四个。
计数与百分比
矩阵启用分组后,标题栏正下方总会出现第二行,其中有两个切换控件和仅显著项。第一个切换控件决定每个单元格显示哪一种计数。第二个切换控件决定每个单元格显示计数(#)还是百分比(%)。百分比是单元格的计数除以所在组的基数。将鼠标指针悬停在某个组的列标题上,可以看到它的基数,例如“行动派”的“文档 6”。
| 第一个切换控件 | 选 # 时的单元格 | 基数 | 选 % 时的单元格 |
|---|---|---|---|
| 编码实例 | 该编码在组内文档中的片段数 | 组内文档中所有编码的全部片段 | 组内编码实例中属于该编码的比例 |
| 文档 | 组内至少有一个该编码片段的文档数 | 组内的文档数 | 组内文档中出现该编码的比例 |
| 覆盖率 | 该编码的片段在组内文档中覆盖的字符数 | 组内文档的字符数 | 该编码覆盖的文本在组内文本中所占的比例 |
各组的文档数不同时(这里是六个行动派文档、五个怀疑派文档和三个中立文档),应当考虑选择 %。使用编码矩阵时,通常最好从文档和 % 开始,因为这一组合显示一组文档中有多大比例包含所分析的主题。
每个编码行中,该编码数值最高的那一组单元格颜色最深。合计列给出整个范围的同类数值,包括无值下的文档。再往后是检验的各列(见下文的检验组间差异)。
按“立场”分组,选择文档和 % 时,“紧迫性”这一行如下:
| 编码 | 行动派 | 怀疑派 | 中立 | 合计 | χ²(自由度 = 2) | p | 克莱姆 V 系数 |
|---|---|---|---|---|---|---|---|
| 紧迫性 | 100.0% | 20.0% | 66.7% | 64.3% | 7.61 | 0.022 * | 0.74 |
六篇行动派文本全都含有编码“紧迫性”。五篇怀疑派文本中有一篇也含有“紧迫性”(),三篇中立文本中有两篇含有()。合起来是 14 篇文本中的 9 篇,即 64.3%。
检验组间差异
如果各列中有两个或更多有值的组,表格最后会为每个编码给出一项检验,说明这个编码在各组中的出现情况是否不均,而且不均的程度超出了随机波动所能解释的范围。点按 p 值的列标题,可以按 p 值从小到大为编码排序;勾选仅显著项,则会滤除 p 等于或高于 0.05 的编码。可供检验的组少于两个时,仅显著项不可用,悬停时显示需要至少两个组。
- 就显著性检验而言,无论切换控件如何设置,检验统计的始终是文档。同一文档中的编码实例并不是独立的观测,因为作者往往会反复提到同一个话题。文档本身则可以看作相互独立的观测数据点。
- 检验不包括未分组列或无值列中的文档,但这些文档计入合计列。
- 如果某个编码出现在所有参与检验的文档中,或者在这些文档中都没有出现,它在各组之间就不可能有差异。因此,这一行的检验列中显示短横,而不是数值。
- 有两个组时,LemmaLoom 进行 Fisher 精确检验,给出 p(Fisher 精确检验)和克莱姆 V 系数两列。有三个或更多组时,它进行卡方检验,给出带有自由度的 χ²(自由度 = …)、p 和克莱姆 V 系数。
- 最后,如果某个编码的 p 值低于 0.05,它的检验值会以较深的颜色显示,p 值后面紧跟一个 *。低于 0.001 的 p 值显示为 < 0.001。
两个组的 Fisher 精确检验
按“立场”属性为“气候辩论”的文档分组,会得到三个组。改按分组划分各列,就只有两个组,即“纸媒”和“网络”,各有六个文档。两个未分组的文档不参与检验,剩下 12 个文档。其中 8 个含有编码“时间节点”:
| 含“时间节点” | 不含 | 合计 | |
|---|---|---|---|
| 纸媒 | 2 | 4 | 6 |
| 网络 | 6 | 0 | 6 |
| 合计 | 8 | 4 | 12 |
Fisher 精确检验把各个合计视为固定不变,然后考察,假如分组没有任何影响,这八个含“时间节点”的文档可能会怎样分配。不妨想象把 12 张扑克牌洗乱,每张牌代表一个文档,其中 8 张是红牌,然后从洗好的牌中随机发 6 张给“纸媒”;Fisher 精确检验计算在所有可能的发牌结果中,“纸媒”拿到每一种红牌张数的情况各有多少种。
从 个元素中选出 个(不计顺序)的选法数记作 ,读作“从 n 中选 r”。它的数学定义如下:
符号 表示阶乘运算,即把从 1 到 n 的所有正整数相乘,所以 。从 4 个元素中选 2 个,有 种选法。关于这种计数方法的更多讨论,请参阅第 12 章“词汇速写”中的单侧 Fisher 精确检验。
随机发牌时,从全部 12 个文档中分出 6 个,共有 种分法。要发出一手含 张红牌的牌,就要从 8 张红牌中选 张,再从 4 张非红牌中选 张,所以有 种方式。含 2 张红牌的一手牌有 种可能。
| 发给“纸媒”的红牌数 | 手数 | 占全部手数的比例 |
|---|---|---|
| 2 | 28 × 1 = 28 | 0.030 |
| 3 | 56 × 4 = 224 | 0.242 |
| 4 | 70 × 6 = 420 | 0.455 |
| 5 | 56 × 4 = 224 | 0.242 |
| 6 | 28 × 1 = 28 | 0.030 |
少于 2 张是不可能的,因为“网络”只有 6 个文档,所以 8 张红牌中至少有 2 张要分给“纸媒”。如果分组对分配没有影响,“纸媒”一般应拿到 4 张红牌,因为 6/12 × 8 = 4。
实际观测到的分配是“纸媒”拿到 2 张红牌。这个检验是双侧的,所以两端都要看,把所有可能性不高于观测结果的牌型的概率加起来。因此,检验既考虑含 2 张红牌的牌型(28 种),也考虑含 6 张红牌的牌型(28 种);后者是“纸媒”拿到 6 张红牌,即每个纸媒文档都含有“时间节点”,而网络文档中只有 2 个含有:
“时间节点”这一行在 p(Fisher 精确检验)列中的值是 0.061。随机分配 8 张红牌时,这种程度或更大的不均衡大约每 100 次出现 6 次。这个值高于 0.05,所以这一行的数字不会以较深的颜色显示,也不会有 *。这里的差异也许确实有原因,但检验无法把它与运气区分开。
这个检验是精确的概率计算,因为它考虑了分配的所有可能情况。用前面讲共现时的公式计算同一张列联表的卡方统计量,得到 ,。但问题在于,这张表的四个期望频数(4、2、4 和 2)都低于 5 左右,所以很难依赖卡方分布的近似。因此,有两个组时,LemmaLoom 报告的是 Fisher 检验的 p 值。
三个或更多组的卡方检验
有三个或更多组时,LemmaLoom 用完全相同类型的表格进行卡方检验,每组一行,分别给出含有和不含该编码的文档数。前面“立场”例子中的“紧迫性”这一行依据的就是这张表:
| 立场 | 含“紧迫性” | 不含 | 合计 |
|---|---|---|---|
| 行动派 | 6 | 0 | 6 |
| 怀疑派 | 1 | 4 | 5 |
| 中立 | 2 | 1 | 3 |
| 合计 | 9 | 5 | 14 |
十四个文档中有九个含有“紧迫性”。期望频数可以用 求出;这里 等于十四,即文档总数。在“行动派”这一行,含“紧迫性”的文档的期望频数为 ,不含“紧迫性”的为 。在“怀疑派”这一行,两者分别为 和 。在“中立”这一行,分别为 和 。对于“行动派”,。其余两行分别得 4.27 和 0.01,因此:
× 的列联表有 个自由度。这里是 ;自由度显示在矩阵的列标题中,即 χ²(自由度 = 2)。自由度为 2 时,得到等于或大于 5.99 的 的概率是 5%。电子表格公式 =CHISQ.DIST.RT(7.61,2) 得出 。“紧迫性”这一行显示 7.61、带 * 的 0.022 和克莱姆 V 系数 0.74,都以较深的颜色显示。
用卡方分布作近似来做假设检验,通常需要期望频数在 5 左右。对于这么小的列联表,p 值充其量只是一个相当模糊的参考。连按“怀疑派”下“紧迫性”的单元格,就会在编码实例视图中从“净零代价高昂”开始阅读,它是唯一含有“紧迫性”的怀疑派文本。
克莱姆 V 系数
p 值既受文档数量的影响,也受编码比例之间差异大小的影响。效应量衡量的是差异本身的大小。克莱姆 V 系数是一种取值在 0 到 1 之间的效应量,没有差异时为 0;在每个组要么所有文档都含有该编码,要么都不含的极端情况下为 1。V 的公式如下:
这里, 是参与检验的文档数, 是表格行数与列数中较小的那个(表格有两列,分别对应含有和不含该编码,所以 ,因此有两个组时,V 等于 φ)。据此,对于“紧迫性”,;而按分组划分的“时间节点”,卡方统计量为 6.00,因此 。这个卡方统计量只用于计算效应量,实际采用的 p 值是 Fisher 精确检验的。
关系
关系视图显示范围内的文档中各编码相互重叠的程度。可以用它考察作者常常一起提到的主题,它甚至能揭示你的某两个编码是否重叠过多,以致描述的可能是同一个概念。
标题栏左侧的切换控件用来在网格和配对之间选择。网格以表格形式显示编码与编码的对照,配对列出相互重叠的编码对。无论哪一种,φ 和 p 值的计算方法都与单个文档相同(见上文的文档中的共现)。不过在这里,四个频数是根据范围内所有文档的全部字符计算的。
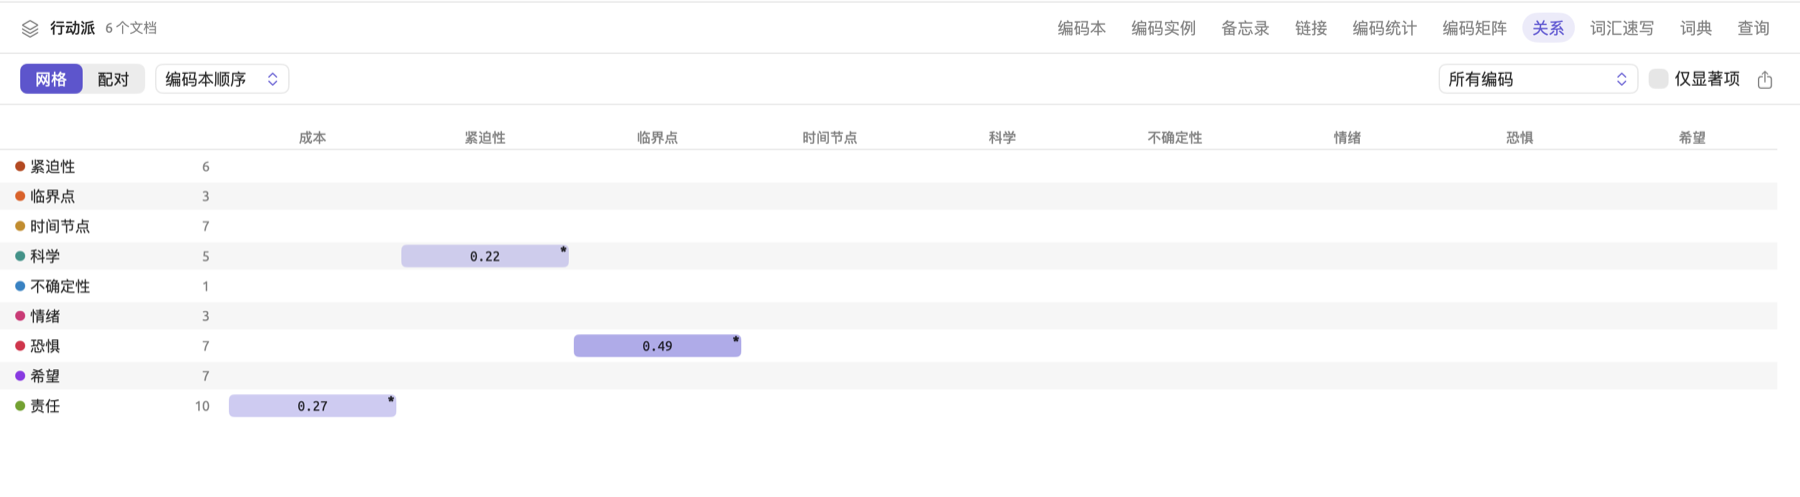
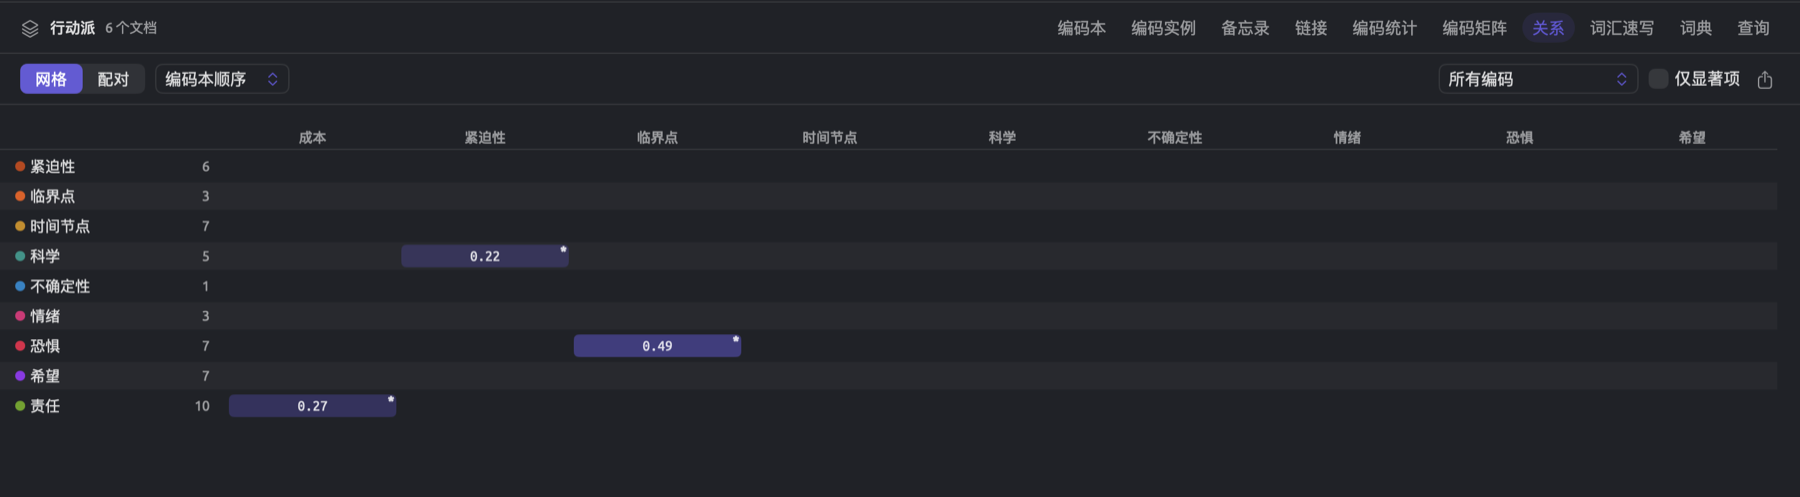
网格的行和列都是编码。每个单元格对应一对编码,位于网格的左下半部分。单元格中是保留两位小数的 φ。如果单元格的 p < 0.05,单元格的角上会有一个 *。单元格按 φ 的强弱以强调色着色,网格中最大的 φ 颜色最深;空单元格表示这一对编码在当前范围内没有重叠。左侧每个编码名称旁边是这个编码的片段数;将鼠标指针悬停在单元格上,可以看到重叠次数和 p 值。编码按所选的排序标准排列,排序标准在切换控件旁边的排序菜单中选择。按编码本顺序排序时,编码保持在编码本中出现的顺序;按聚类排序时,重叠较强的编码在网格中排在相邻的位置。
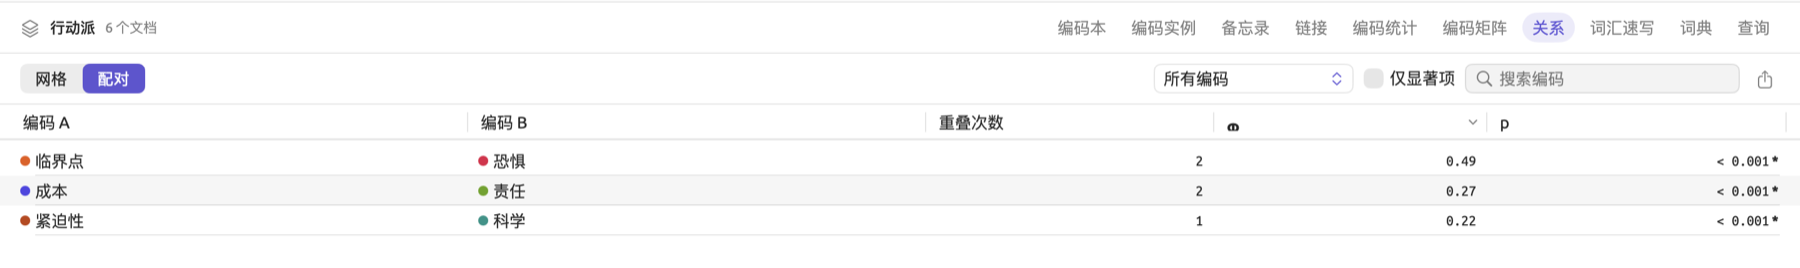
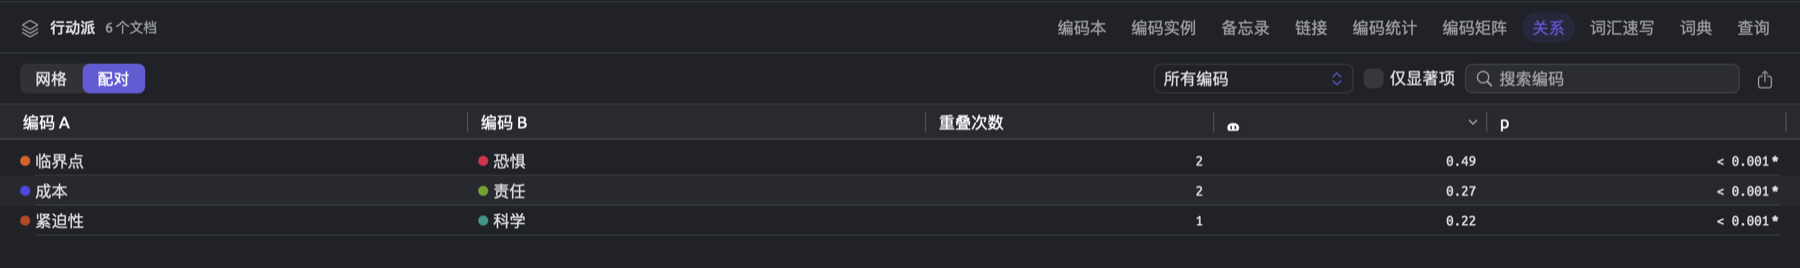
与网格不同,配对每行显示一对编码,共有五列(编码 A、编码 B、重叠次数、φ 和 p)。表格从最大的 φ 开始排列;需要时,随时可以点按相应的列标题重新排序。如果只想保留编码名称中含有某些文字的配对,请使用搜索编码栏。重叠次数中的每个单元格是重叠的次数,同一文档中相互重叠的两个片段计为一次重叠。它实质上就是编码本视图中的共现编码(见第 7 章“编码”中的“编码本”视图)。
网格和配对都可以通过编码菜单(所有编码)按一个编码集,或者按一个上级编码及其子编码进行筛选。两者也都可以只显示显著的配对(仅显著项),p 值低于 0.05 即视为显著。
“行动派”文档集中有三对相互重叠的编码。有 3 个片段的“临界点”和有 7 个片段的“恐惧”重叠 2 次;“成本”和“责任”重叠的次数一样多,但它们分别有 5 个和 10 个片段;“科学”和“紧迫性”重叠 1 次。片段越多,重叠的机会自然越多,所以请始终把重叠次数与片段数相对照,或者看 φ 值。φ 考虑的是重叠字符数相对于每个编码大小的比例。
分析汇总的表格时,比分析单个文档更容易出现 *,因为汇总的表格包含当前范围内每个文档的所有字符。请以 φ 值为准,但要记住,显著性可能完全来自某一个大文档中的重叠。要查看相互重叠的片段,可以连按网格中的单元格或配对中的行,或者使用快捷菜单中的显示编码实例命令。编码实例随即显示在编码本中排在前面的那个编码(即配对中的编码 A)与另一个编码重叠的片段,并在标题栏中显示两个编码的名称,例如临界点 · 恐惧。
导出表格和图表
本章介绍的所有表格和图表,在其标题处或视图的标题栏中都有一个导出按钮,图标是一个带向上箭头的方框。如果只能导出 CSV 格式,例如共现、编码行、编码实例视图和关系中的配对,点按导出按钮会直接打开存储对话框。否则,点按导出按钮会打开一个菜单,先列出 PNG 和 PDF;如果图表背后有表格,还有 CSV。关于编码、编码实例和链接分面以及编码本、备忘录和链接视图的导出,请参阅第 7 章“编码”。
- 按需要设置好视图,包括分组、切换控件、搜索或筛选。
- 点按导出按钮;如果打开了菜单,再选择一种格式。
- 存储对话框会建议一个文件名,由文档、文档集或项目的名称加上表格的种类组成,例如
时间不多了-co-occurrences。选择一个文件夹,然后点按保存。
文件中的数据与视图所显示的内容一致。在编码实例中搜索和筛选的结果会带入文件;编码矩阵和关系中的编码菜单、搜索编码和仅显著项,以及编码矩阵中计数或百分比的选择,也都会带入文件。
| 位置 | 格式 | CSV 文件的列 | 建议的文件名 |
|---|---|---|---|
| 编码统计分面,编码频率与覆盖率 | PNG、PDF、CSV | 编码、片段、字符数、覆盖率 (%) | 时间不多了-code-frequencies |
| 编码统计分面,共现 | CSV | 编码、编码、重叠次数、字符数、φ、p | 时间不多了-co-occurrences |
| 属性分布,每张图表 | PNG、PDF、CSV | 属性、值、数量 | 时间不多了-恐惧-attributes |
| 画像,马赛克 | PNG、PDF | 时间不多了-mosaic | |
| 画像,编码行 | CSV | 句子、编码、文本 | 时间不多了-codeline |
| 编码实例视图 | CSV | 文档、编码、文本、开始、结束,然后每个属性一列 | 行动派-segments |
| 编码统计视图 | PNG、PDF、CSV | 编码、片段、文档、字符数、覆盖率 (%) | 行动派-code-statistics |
| 编码矩阵 | PNG、PDF、CSV | 编码,然后每个文档或组一列,以及合计 | 行动派-code-matrix |
| 关系,网格 | PNG、PDF、CSV | 编码、片段,然后每个编码一列 | 行动派-code-relations |
| 关系,配对 | CSV | 编码、编码、重叠次数、字符数、φ、p | 行动派-code-pairs |
共现和配对也可以导出为 CSV 文件;在这两种文件中,“重叠次数”指相互重叠的片段对数,在分面中显示为 1×;“字符数”指两个编码共有的字符数。φ 和 p 都保留四位小数,所以极小的 p 值显示为 0.0000。在编码行的 CSV 文件中,“编码”指该行的各个编码,以分号分隔。编码矩阵的 CSV 文件中,空单元格填入 0。而网格的 CSV 文件保留视图的左下半部分,φ 四舍五入到四位小数,两个编码没有重叠的地方单元格为空。
把分组后的编码矩阵导出为 CSV 文件时,每个组占一列;如果选择了百分比(%),组名后面加上 (%)。然后是合计和检验各列(χ²、自由度 和 p,或者只有 p(Fisher 精确检验)),最后是 克莱姆 V 系数。分组后的编码矩阵 CSV 文件的第一行包含每个组的基数,以及说明其内容的标签(例如“文档”)。百分比写成保留两位小数的数字(例如 66.67)。检验结果中的 p 值保留六位小数,χ² 和克莱姆 V 系数保留四位小数。没有检验的编码在检验列中的单元格为空。
表格和图表的 PNG 和 PDF 文件是在导出时重新生成的,使用当前主题的颜色。分组后的编码矩阵导出的图片中,表格包含各组的基数和检验各列。关于 CSV 导出以及图片在深色主题下的样子,请参阅第 22 章“交换与导出”中的导出表格和图表。